<!--more--> ## 零、写在前面 这篇论文就是后面经典的Vision Transformer,核心思想很直接: > 将一张图片切成一系列固定大小的patch,把一个 patch 当作NLP任务中的一个token,然后送入标准 Transformer Encoder 做图像分类。 它证明了在足够大规模数据预训练的条件下,纯**Transformer**架构可以在图像识别任多上达到基至超过**CNN**。打破了 cv 和 nlp 在模型上的壁垒。 …
<!--more--> ## 零、写在前面 今天一看博客,图床全挂了,花了一下午试了各个渠道,都不太满意。最后偶然在L站上看到有人聊这个东西,才发现了github上这个好用的项目。 ## 一、个人图床搭建 ### 1.1 CloudFlare-ImgBed 仓库链接:[CloudFlare-ImgBed](https://github.com/MarSeventh/CloudFlare-ImgBed) ### 1.2 搭建流程 项目有非常清晰的部署文档: 1. [前期准 …
<!--more--> ## 零、前言 作为本书的最后一个章节,作者介绍了如何通过微调一个follow instruction的llm。 本章代码:[ch07](https://github.com/Equinox-2003/LLMs-from-scratch-Practice/tree/main/ch07) ## 一、Fine Tuning to Follow Instructions ### 1.1 Introduction to instruction fine-tuning **流程一览:** …
<!--more--> ## 零、写在前面 这一章主要讲了下如何对llm进行微调。 本章代码:[ch06](https://github.com/Equinox-2003/LLMs-from-scratch-Practice/tree/main/ch06) ## 一、Fine-tuning for classification ### 1.1 Different categories of fine-tuning 对语言模型最常用的微调方式有 **instruction fine-tuning** 以及 **classification fine-tuning**。 …
<!--more--> ## 零、前言 本章主要讲了下如何评价llm生成文本的质量,如何进行预训练。 本章代码:[ch05](https://github.com/Equinox-2003/LLMs-from-scratch-Practice/tree/main/ch05) ## 一、Pretraining on unlabeled data ### 1.1 Evaluating generative text models 首先回顾下 GPT 生成文本的过程: **创建GPT模型:** ```python import torch from …
<!--more--> ## 零、前言 这一章作者带着手搓了一下GPT 2的architecture,架构还是比价清晰易懂的。 本章代码:[ch04](https://github.com/Equinox-2003/LLMs-from-scratch-Practice/tree/main/ch04) ## 一、Implementing a GPT model ### 1.1 Coding a LLM architecture 像**GPT(generative pretrained transformer)**这样的LLM,都是大而深的神经网络架构,使得生成文本时一次生成 …
<!--more--> ## 零、前言 原书这章主要就是搓了下注意力模块,总体还是非常easy的 本章代码:[ch03](https://github.com/Equinox-2003/LLMs-from-scratch-Practice/tree/main/ch03) ## 一、Self Attention Mechanism ### 1.1 Simple Attention Mechanism 作者没有一上来就手撕多头注意力机制或者说子注意力机制,而是用了一个思想相同,但是实现上简化的一个简单版本的注意力机制。 作者之间用输入向量之间两两做点积来进行注意力分数的计 …
<!--more--> ## 一、SVD ### 1.1 什么是SVD **SVD(奇异值分解)** 线性代数中最重要的矩阵分解之一。 它的核心结论是:**任意一个矩阵(不要求是方阵、不要求满秩),都可以分解为“旋转—缩放—旋转”三个因子的乘积。** 具体地说,对于 **任意** 复矩阵$A_{mn} \in \mathbb{C}^{m\times n} $,存在分解: $$ A_{mn} = U_{mm} \Sigma_{mn} V^T_{nn} $$ 其中: - $UU^T = I$,$U$ 的列是$AA^T$的单位正交特征向量 - $VV^T = I$,$V$ …
<!--more--> ## 一、Transformer ### 1.1 Seq2Seq **Seq2Seq(序列到序列)**模型输入和输出都是一个序列,输入与输出序列长度之间的关系有两种情况。 1. 输入跟输出的长度一样 2. 机器决定输出的长度。 序列到序列模型的常见应用: 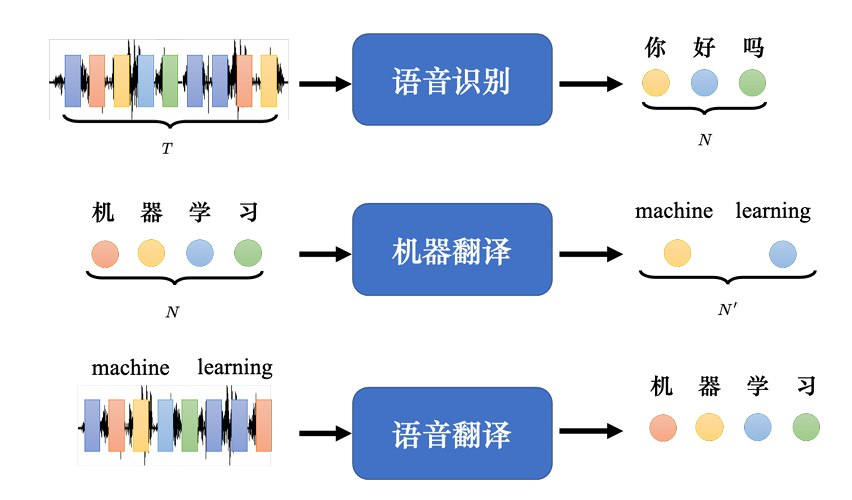 > Q:既然把语音识别系统跟机器翻译系统接起来就能达到语音翻译的效果,那么为什么 要做语音翻译? > > …