
零、写在前面
很有趣的思路,相当于是挂了一个超大的向量表,模型前向过程中O(1)查询向量然后门控注入hidden state,这样做的信息密度很高,而且延迟比较低,最重要的是 scale 的成本非常低,因为Engram可以放在内存也可以放在ssd上面(而且机制本身就符合经典的内存金字塔层级),最近的 ds v4.1f 已经加上了这个设计,qwen next 好像也用了这个。
各家思路都不太一样,但是小模型性能上限确实是在不断走高的,感觉后续会有很多有趣的工作!
一、标题
作者团队:PKU x DeepSeek
二、背景
2.1 问题:标准 Transformer 的“计算模拟检索”低效泥潭
过去几年,前沿模型通过 Mixture-of-Experts (MoE) 架构成功实现了参数规模与计算代价的解耦。MoE 依据前向计算中的动态隐藏状态激活一小部分专家,这一范式被称为条件计算(Conditional Computation)。
然而,自然语言建模在根本上包含两类截然不同的子任务(语言双重性 Linguistic Duality):
- 组合推理(Compositional Reasoning):包含因果推演、逻辑推理、数学代码算法生成等,必须依赖深度前向网络进行连续、非线性的动态计算。
- 知识检索(Knowledge Retrieval):语言中充斥着大量的实体名称(Named Entities)、固定短语搭配(Idioms)、程式化句式(Formulaic Patterns)。这类信息高度局部、静态、定型。
在经典自然语言处理中,$N$-gram 模型被广泛证明在捕捉这类局部静态依赖上极其高效,因为这些模式在数学上对应于代价极低的常数级查表操作($\mathcal{O}(1)$ Lookup)。
现有 LLM 的瓶颈所在:
标准 Transformer 架构完全缺失原生的知识检索与查表原语。在现有的 LLM 中,模型被迫用计算来模拟检索:
- 论文引用了可解释性研究(Ghandeharioun et al., PatchScopes, 2024),展示了 Transformer 解析一个简单的实体词组 “Diana, Princess of Wales” 的内部过程:
| 模型层数 | PatchScope 隐藏状态解码翻译 | 语义解释与进展 |
|---|---|---|
| Layer 1-2 | : Country in the United Kingdom |
仅识别出 Wales 属于英国 |
| Layer 3 | : Country in Europe |
欧洲国家 |
| Layer 4 | : Title held by female sovereigns in their own right or by queens consort |
识别出这是一个女性头衔(Princess of Wales),但尚未绑定具体人物 |
| Layer 5 | : Title given to the wife of the Prince of Wales (and later King) |
威尔士王妃头衔(未特指) |
| Layer 6 | : Diana, Princess of Wales (1961-1997), the first wife of Prince Charles... |
终于在第 6 层拼凑出了完整的实体事实! |
从底层原理看,这相当于模型在每次前向推理时,都要用前 5~6 层的多头注意力与 FFN 计算,去硬生生动态重构一张本应静态存在的哈希查找表! 这浪费了宝贵的有效序列层深(Sequential Depth),挤占了原本应当分配给高层复杂逻辑推理的计算带宽。
2.2 动机:引入第二稀疏轴——条件记忆 (Conditional Memory)
为了打破这一结构性错配,DeepSeek 团队倡导在模型架构中开辟全新的稀疏维度:
$$\text{Sparsity in LLMs} = \underbrace{\text{Conditional Computation (MoE)}}_{\text{处理动态逻辑推演}} + \underbrace{\text{Conditional Memory (Engram)}}_{\text{处理静态模式检索}}$$- 条件计算 (MoE):根据隐藏状态 $\mathbf{h}_t$ 动态路由至不同计算单元(参数在计算流中);
- 条件记忆 (Engram):根据输入的离散 Token 上下文,通过确定性哈希直接索引海量外部/静态参数(参数在存储流中,$\mathcal{O}(1)$ 查表)。
通过将经典 $N$-gram 嵌入现代化改造,引入分词器压缩、多头哈希、上下文门控以及软硬件协同流水线,Engram 实现了让模型“用查表做检索,用网络做推理”。
2.3 相关工作
- $N$-gram 建模与嵌入扩展:
- N-Grammer (Roy et al., 2022)、SuperBPE (Liu et al., 2025)、SCONE (Yu et al., 2025)、OverEncoding (Huang et al., 2025)、Byte Latent Transformer (BLT, 2025)。
- Engram 的区别:以往工作通常将 $N$-gram 视为输入层的外部补丁(放在 Layer 0),使得显存搬运与计算串行,拖慢吞吐;且像 OverEncoding 在稀疏 MoE 主干上几乎无法取得收益;SCONE 则引入了额外的辅助训练 FLOPs。Engram 首次在严格“同参数量、同训练 FLOPs”的标准下,确立了其与 MoE 的正交协同规律。
- 推荐系统超高基数特征嵌入 (High-Cardinality Embeddings):
- ROBE (Desai et al., 2022)、TT-Rec (Yin et al., 2021)、Multi-hash (Tito Svenstrup et al., 2017)。
- 面对数十亿甚至数百亿的离散稀疏 ID,推荐系统广泛采用多哈希冲突缓解、Zipf 频次缓存策略。Engram 吸收了这一成熟理念,并将其升维至有序语言 $N$-gram。
- 参数化与非参数化记忆网络:
- 参数化:Product Key Memory (PKM)、PEER、UltraMem。这些方法虽然在 FFN 中嵌入了海量 Key-Value,但它们的 Key 依然是由前向隐藏层经神经网络计算生成的,无法实现完全确定性的前置预取。
- 非参数化:REALM、RETRO。将长文档存为外部文本块再通过稠密向量召回,存在严重的检索时延与 Prompt 长度损耗。
- Transformer 知识存储机理与模型编辑:
- Geva et al. (2021) 提出 FFN 是 Key-Value 记忆;Dai et al. (2022) 发现 Knowledge Neurons;Meng et al. (ROME, MEMIT) 实现了事实精确定向编辑。Engram 从架构源头为事实知识提供了显式物理载体。
三、Engram
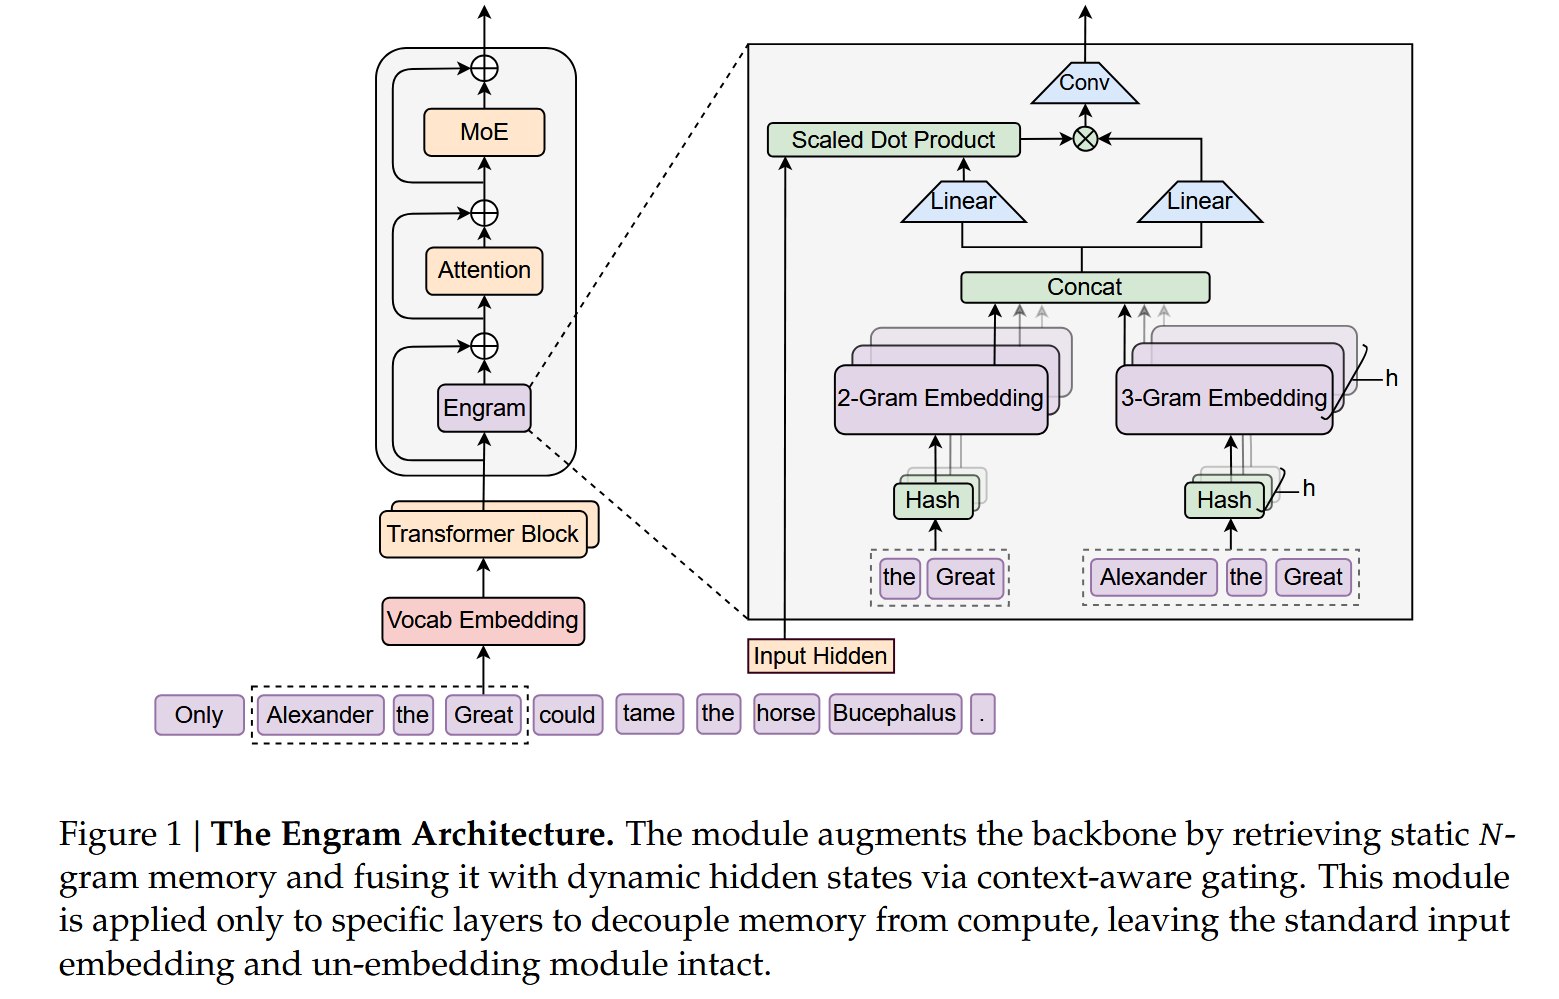
3.1 阶段一:基于哈希 $N$-gram 的稀疏检索 (Sparse Retrieval via Hashed $N$-grams)
1. 分词器压缩 (Tokenizer Compression)
- 动机:当前标准 BPE / SentencePiece 分词器以“无损文本重构”为优化目标,导致大量在语义上完全一致的词项被分配了不同的 Token ID(如大小写差异、前导空格、Unicode 变体等)。如果直接以原始 ID 组合成 $N$-gram,将引发严重的组合爆炸与语义稀疏。
- 形式化:构造预先计算的满射函数 $\mathcal{P}: \mathcal{V} \to \mathcal{V}'$:
- 通过 Unicode NFKC 规范化、转小写、去除冗余前导空白等规则,将原始词表 $\mathcal{V}$ 映射至规范语义词表 $\mathcal{V}'$;
- 压缩效果:在 DeepSeek-v3 的 128k 词表上,实现了 23.43% 的有效词表缩减(例如针对空格相关 token 合并了 163 个 ID;字符
a的各种重音形态合并了 54 个 ID)。
- 后缀元组生成:在位置 $t$,将原始 token $x_t$ 投影为其规范 ID $x'_t = \mathcal{P}(x_t)$,构成 $n$ 阶后缀 $N$-gram: $$g_{t,n} = (x'_{t-n+1}, \dots, x'_t)$$
2. 多头确定性哈希 (Multi-Head Hashing)
- 动机:所有可能的 $N$-gram 组合数规模极大(对于 10 万级词表,3-gram 理论上有 $10^{15}$ 种组合),无法为每个组合理论分配参数。直接哈希分桶又面临哈希碰撞(Hash Collision)导致语义污染。
- 形式化:对每个阶数 $n \in [2, N]$,使用 $K$ 个独立的哈希头(Hash Heads)。每个头 $k$ 对应一个大小为素数 $M_{n,k}$ 的嵌入表 $\mathbf{E}_{n,k}$: $$z_{t,n,k} \triangleq \phi_{n,k}(g_{t,n}), \quad \mathbf{e}_{t,n,k} = \mathbf{E}_{n,k}[z_{t,n,k}]$$ 其中 $\phi_{n,k}$ 采用轻量高效的乘法异或哈希(Multiplicative-XOR Hash)。
- 特征拼接:将所有阶数、所有哈希头检索出的静态向量拼接,得到最终的静态记忆表征 $\mathbf{e}_t \in \mathbb{R}^{d_{\text{mem}}}$: $$\mathbf{e}_t \triangleq \bigoplus_{n=2}^N \bigoplus_{k=1}^K \mathbf{e}_{t,n,k}$$ (在 27B 模型中,$N=3, K=8, d_{\text{mem}}=1280$)。
3.2 阶段二:上下文感知门控与特征融合 (Context-Aware Gating & Fusion)
1. 上下文感知门控 (Context-Aware Gating)
- 动机:检索出来的 $\mathbf{e}_t$ 纯粹是依赖局部 $N$-gram 的“无上下文静态先验(Context-independent Priors)”。在遭遇哈希碰撞或自然语言中的多义词时,$\mathbf{e}_t$ 会带来巨大的错误特征噪音。必须建立一套机制,让模型根据当前全局语境动态决定“采纳还是丢弃”。
- 形式化:
- 引入类似 Attention 的 Query-Key-Value 交互机制。
- 将当前层已经融合了全局上下文的隐藏状态 $\mathbf{h}_t$ 作为动态 Query;
- 将检索出的静态记忆向量 $\mathbf{e}_t$ 经由可学习矩阵投射为 Key 与 Value: $$\mathbf{k}_t = \mathbf{W}_K \mathbf{e}_t, \quad \mathbf{v}_t = \mathbf{W}_V \mathbf{e}_t$$
- 为防止极端点积破坏训练稳定性,在计算点积前对 Query 和 Key 施加 RMSNorm,计算标量门控值 $\alpha_t \in (0, 1)$: $$\alpha_t = \sigma\left( \frac{\text{RMSNorm}(\mathbf{h}_t)^\top \text{RMSNorm}(\mathbf{k}_t)}{\sqrt{d}} \right)$$
- 门控调制值: $$\tilde{\mathbf{v}}_t = \alpha_t \cdot \mathbf{v}_t$$
- 物理意义与抑噪能力:
- 当检索出的静态记忆 $\mathbf{e}_t$ 符合上下文意图时,门控激活($\alpha_t \to 1$),静态知识无缝注入主干;
- 当遭遇哈希碰撞或语境冲突时,$\mathbf{h}_t$ 与 $\mathbf{k}_t$ 语义相斥,门控自动归零($\alpha_t \to 0$),以极高效率完全屏蔽了哈希冲突的副作用。
2. 因果深度一维卷积 (Depthwise Causal Conv1D)
为了进一步扩大时域感受野,并为线性加权的门控值注入非线性交互,将门控序列 $\tilde{\mathbf{V}} \in \mathbb{R}^{T \times d}$ 送入因果深度可分离卷积:
$$\mathbf{Y} = \text{SiLU}(\text{Conv1D}(\text{RMSNorm}(\tilde{\mathbf{V}}))) + \tilde{\mathbf{V}}$$- 卷积核大小 $w=4$,空洞率(Dilation)$\delta$ 设定为最大 $N$-gram 阶数(即 3);
- 训练稳定性策略(Zero-Init):卷积层的权重与偏置在初始阶段严格初始化为 0。这意味着在训练开始的第一拍,卷积部分输出为 0,Engram 模块对外呈现严格的恒等映射,确保大模型预训练起步阶段梯度的平滑过渡。
3.3 与流形约束超连接 (mHC) 的多分支集成
DeepSeek 团队采用了流形约束超连接(mHC, Xie et al., 2025),将残差流拆分为 $M$ 个并行分支(论文基准设定 $M=4$)。Engram 针对这种拓扑提出了极致高效的融合策略:
- 权重共享:所有 $M$ 个分支共享同一张庞大的 Embedding 表,并共享同一个 Value 投影矩阵 $\mathbf{W}_V$。
- 独立感知:为 $M$ 个分支赋予独立的 Key 投影矩阵 $\{\mathbf{W}_K^{(m)}\}_{m=1}^M$,使得各分支根据自己不同的潜在表征独立计算门控: $$\alpha_t^{(m)} = \sigma\left( \frac{\text{RMSNorm}(\mathbf{h}_t^{(m)})^\top \text{RMSNorm}(\mathbf{W}_K^{(m)} \mathbf{e}_t)}{\sqrt{d}} \right), \quad \mathbf{u}_t^{(m)} = \alpha_t^{(m)} \cdot (\mathbf{W}_V \mathbf{e}_t)$$
- 算子融合(Kernel Fusion):在工程实现中,1 个 $\mathbf{W}_V$ 与 $M$ 个 $\mathbf{W}_K^{(m)}$ 被打包为一个致密的单次 FP8 矩阵乘法(Dense FP8 GEMM),彻底避免多次小矩阵调用的开销。
3.4 软硬件协同设计:计算与存储的彻底物理级解耦 (System Co-Design)
这是 DeepSeek 这篇报告最具工程洞见的部分。相比 MoE 架构,Engram 具备革命性的系统优势:
- 确定性寻址 (Deterministic Addressing): 在 MoE 中,路由由隐藏状态 $\mathbf{h}_t$ 决定,模型不算到第 $\ell$ 层,根本无法预知路由目标。 而 Engram 的索引只依赖于输入 Token 的离散 ID。在整批数据刚喂进模型、第 1 层还没开始算的时候,第 2 层、第 15 层 Engram 所需调用的全部内存地址就已经 100% 确定了。
- 异步流水线预取 (Prefetch-and-Overlap via PCIe):
地址提前已知使得系统可利用前序层的计算时间作为通信缓冲垫(Compute Window):
- 将百亿/千亿级的超大 Embedding 表全部卸载(Offload)在廉价的 CPU 宿主机内存(Host DRAM);
- 当 GPU 正在全力计算 Layer 1 时,后台异步启动 DMA 通过 PCIe 将 Layer 2 需要的活跃槽位向量拉取到显存中;
- 当 Layer 1 算完,向量早已就绪,GPU 算力利用率维持 100%,无任何算力气泡(Zero GPU Stalls)。
- 齐夫定律与多级存储金字塔 (Zipfian Multi-Level Cache):
自然语言词频与短语组合严格服从齐夫分布(Zipf’s Law):极少数高频 $N$-gram 占据绝大多数访问。
- Tier 1 (GPU HBM):缓存极高频词组(如冠词、常见介词短语);
- Tier 2 (Host DRAM):容纳常用实体与领域知识;
- Tier 3 (NVMe SSD):容纳海量冷门长尾实体与历史短语。 这使得模型可以通过极低成本的普通存储介质,轻松扩展出千亿级的外部参数体量。
四、实验
4.1 稀疏配比定律 (Sparsity Allocation Law)
1. 问题形式化
固定总训练算力预算与总参数量:
- $P_{\text{tot}}$:模型总参数量(排除词表和输出头);
- $P_{\text{act}}$:单 token 激活参数量(决定严格的训练 FLOPs);
- $P_{\text{sparse}} \triangleq P_{\text{tot}} - P_{\text{act}}$:可自由分配的稀疏参数预算;
- 定义分配比率 $\rho \in [0, 1]$: $$P_{\text{MoE}}^{\text{(sparse)}} = \rho P_{\text{sparse}}, \quad P_{\text{Engram}} = (1 - \rho) P_{\text{sparse}}$$
2. U 型曲线的揭示
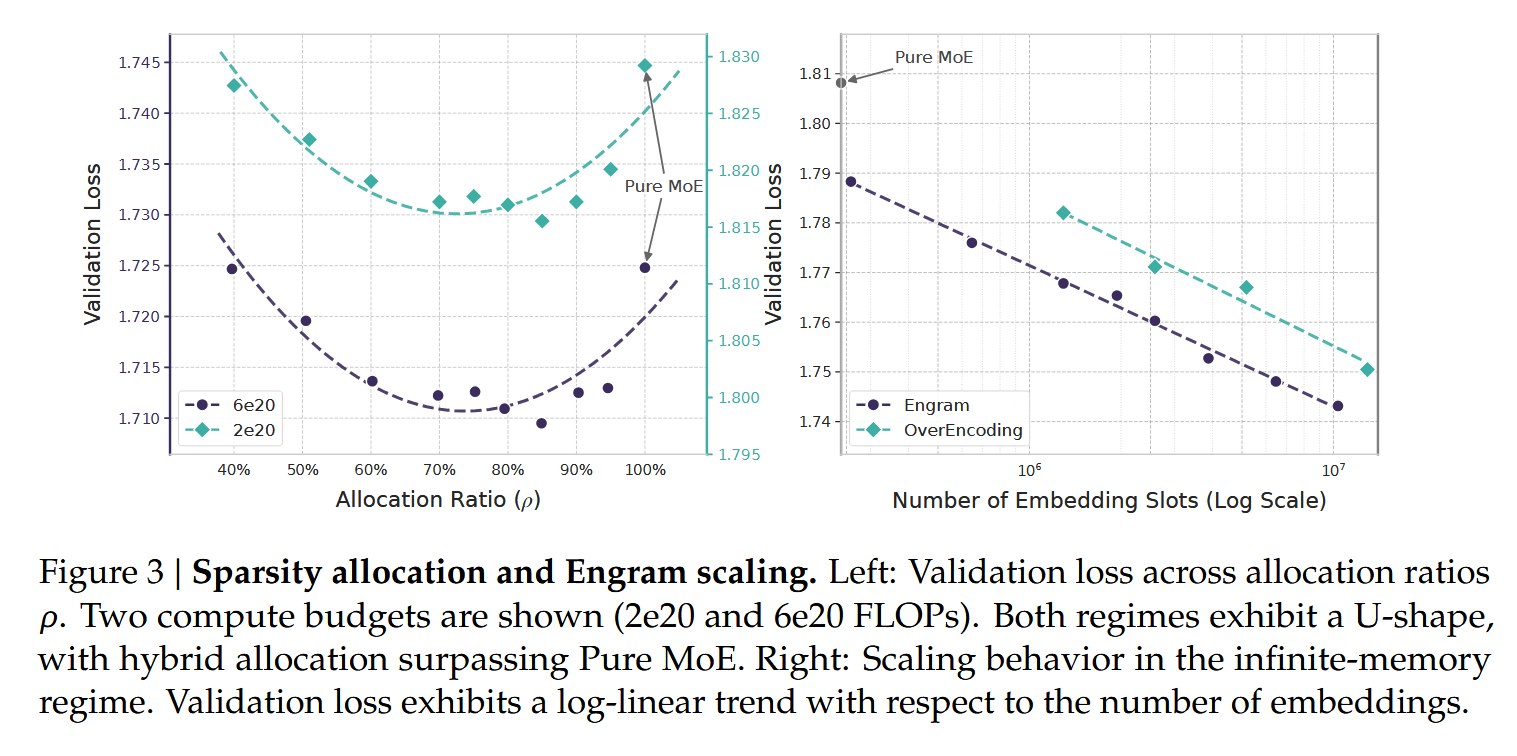
在两种算力规模下($2 \times 10^{20}$ FLOPs, 5.7B 参数;$6 \times 10^{20}$ FLOPs, 9.9B 参数;稀疏比 $P_{\text{tot}}/P_{\text{act}} \approx 10$)扫描 $\rho$:
- 黄金配比点:最优解稳定出现在 $\rho \approx 75\% \sim 80\%$。
- 在 10B 规模下,将纯 MoE($\rho=1$)的 20%~25% 稀疏预算剥离给 Engram,验证集 Loss 从 1.7248 降至 1.7109(降幅 $\Delta = 0.0139$,对于大语言模型预训练而言是非常显著的收敛增益)。
- 甚至当 MoE 专家被砍掉近 60%($\rho \approx 40\%$)时,Engram 辅助模型的表现依然追平了纯 MoE!
- 机理解释:
- $\rho \to 100\%$ 时,模型缺乏专门的静态存储机制,底层网络被迫浪费深度去计算重构;
- $\rho \to 0\%$ 时,模型丧失动态路由与条件计算算力,无法处理复杂的上下文逻辑推演;
- 结论:条件计算与条件记忆在架构层面是正交互补的。
3. 无限内存模式 (Infinite Memory Regime)
在固定 3B 主干($P_{\text{act}} = 568\text{M}$)的前提下,将 Engram 的槽位数量从 $2.58 \times 10^5$ 强力扩展至 $1.0 \times 10^7$(额外增加约 13B 静态参数,前向 FLOPs 严格保持恒定):
- 验证集 Loss 呈现出极其严格的对数线性幂律下降(Power Law);
- 证明 Engram 提供了除计算扩展(Compute Scaling)之外的全新维度——存储扩展(Storage Scaling),且性能提升未见饱和。
4.2 大规模预训练性能评测 (Large Scale Pre-training Benchmarks)
1. 评测模型规格 (训练数据 262B Tokens, 30 层, 维度 2560, MLA, mHC)
- Dense-4B:总参数 4.1B,激活 3.8B(稠密基准);
- MoE-27B:总参数 26.7B,激活 3.8B(72 路由专家 + 2 共享专家,top-6);
- Engram-27B:总参数 26.7B,激活 3.8B(严格同参同 FLOPs:缩减至 55 路由专家,腾出 5.7B 参数给 Engram,处于 $\rho=74.3\%$ 最优区间,挂载于 Layer 2 和 15);
- Engram-40B:保持相同激活参数,进一步将 Engram 参数扩展至 18.5B(总参数 39.5B)。
2. 评测基准成绩
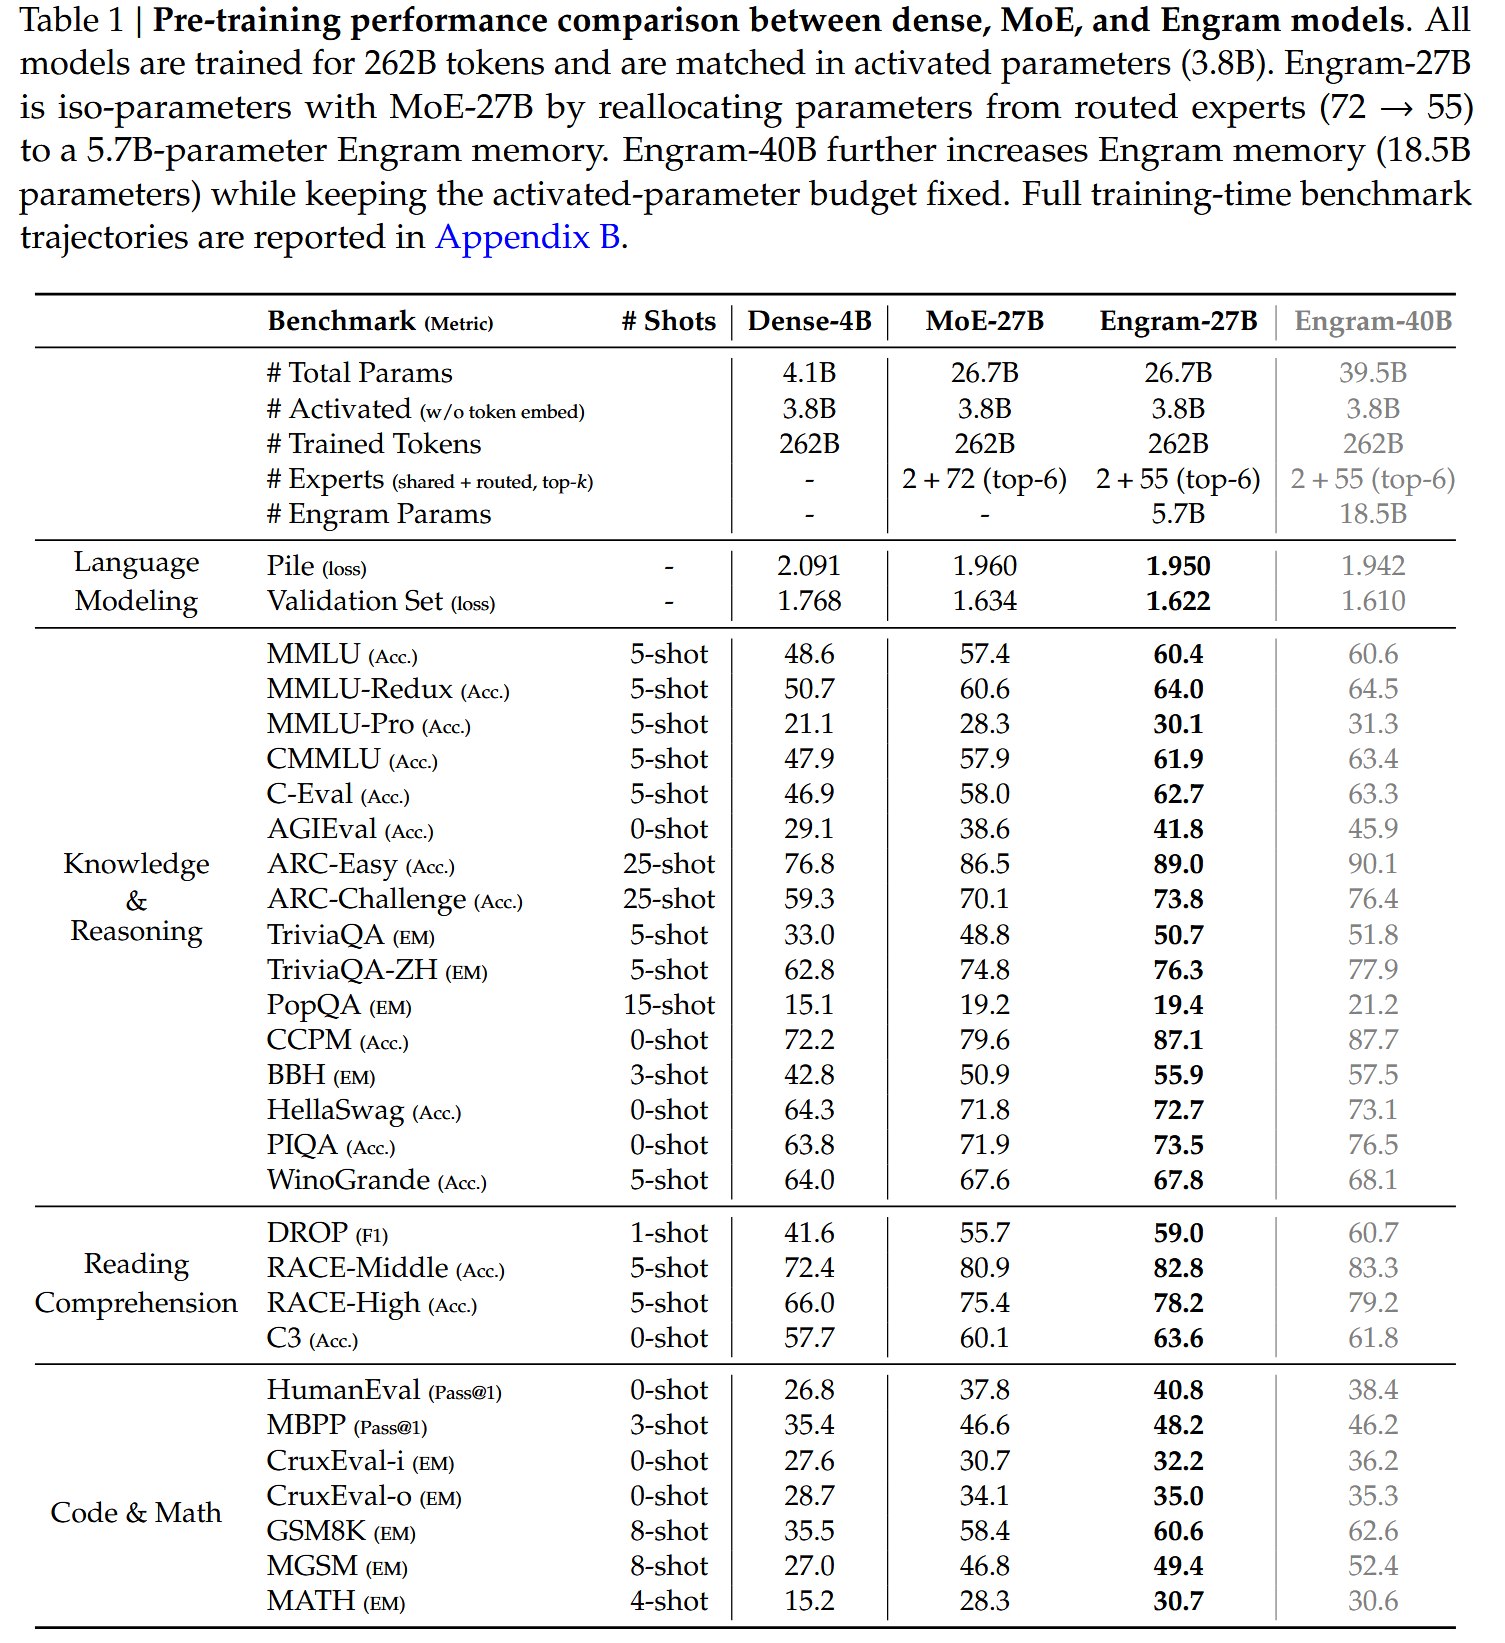
反直觉发现(Key Insight):
直觉上,大家普遍认为引入外部静态 Embedding 查表,提升最大的理应是事实知识型任务(如 TriviaQA、MMLU)。
但实验结果令人震惊:提升幅度最猛烈、最夸张的,反而是强逻辑推理任务(BBH: +5.0)、高难科学推导(ARC-C: +3.7)以及代码和数学(HumanEval: +3.0, MATH: +2.4)。
这完全证实了论文的核心假设:通过 Engram 把原本在前 5 层拼凑局部模式的苦活累活卸载掉,Transformer 主干网络的有效层深被成倍释放,从而能够动用完整的高层算力去攻克深层多步推理。
4.3 32k 长文本扩展能力评测 (Long Context via YaRN)
通过 YaRN 扩窗至 32k 进行 5k 步(30B tokens)微调。设置了三种严格受控对比:
- Iso-Loss 对照:选取预训练仅 46k 步的 Engram-27B(Loss 恰好等于跑满 50k 步的 MoE-27B,均为 1.63);
- Iso-FLOPs 对照:Engram-27B 跑满 50k 步;
- 极限制约对照:Engram-27B 仅跑 41k 步(仅消耗基准 82% 的训练算力)。
评测成绩(节选自论文 Table 2,RULER 32k 评测集):
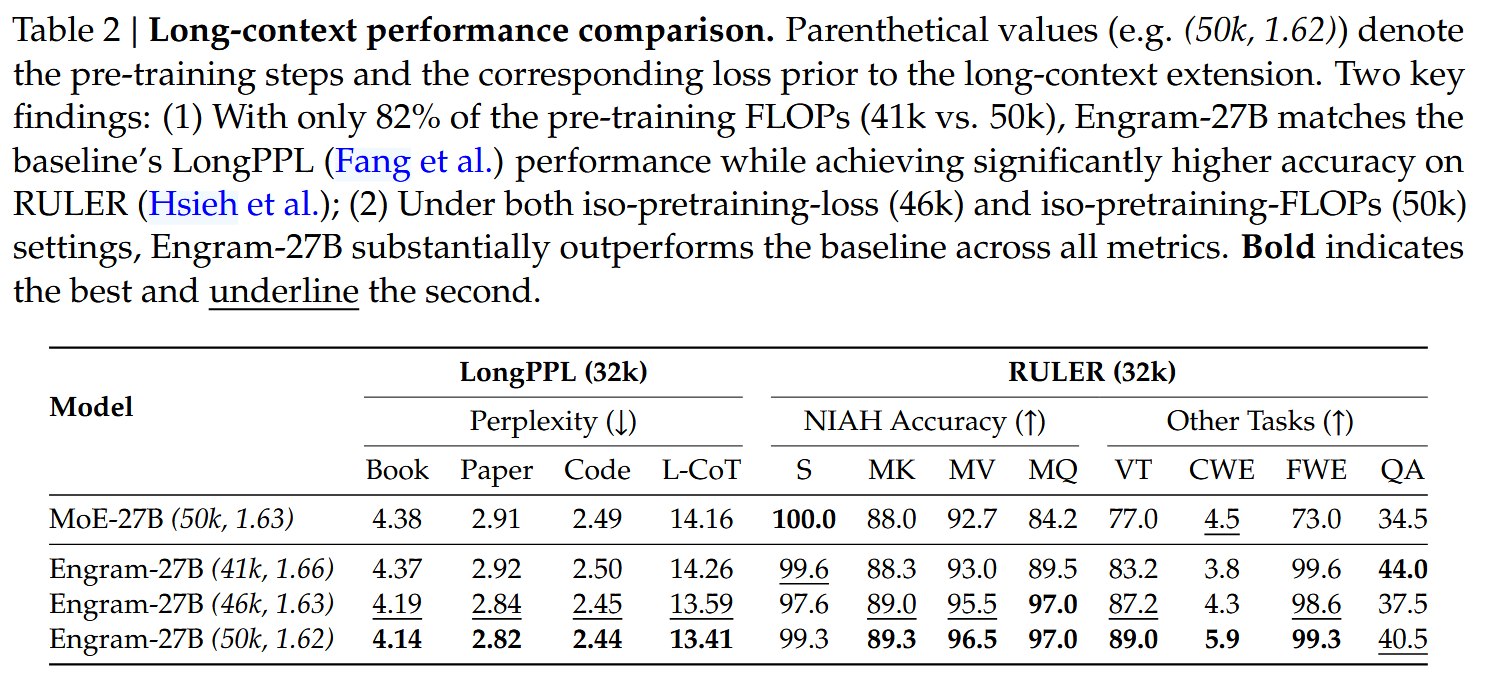
- 在长文本场景下,Multi-Query NIAH成绩从 84.2 飙升至 97.0,变量追踪从 77.0 飙升至 89.0,即使算力被砍掉 18%(41k 步),依然大幅超越满血 MoE。
- 原因机制:在长文本处理中,标准的自注意力机制极易被上下文内大量的局部词组依赖所牵扯分散;Engram 将局部词组绑定转化为 $\mathcal{O}(1)$ 查表,彻底释放了注意力头的长程关联容量,专门用于跨段落的超远距离全局定位与变量多跳追踪。
4.4 机理可解释性剖析:Engram 在物理上等效于增加了网络层深
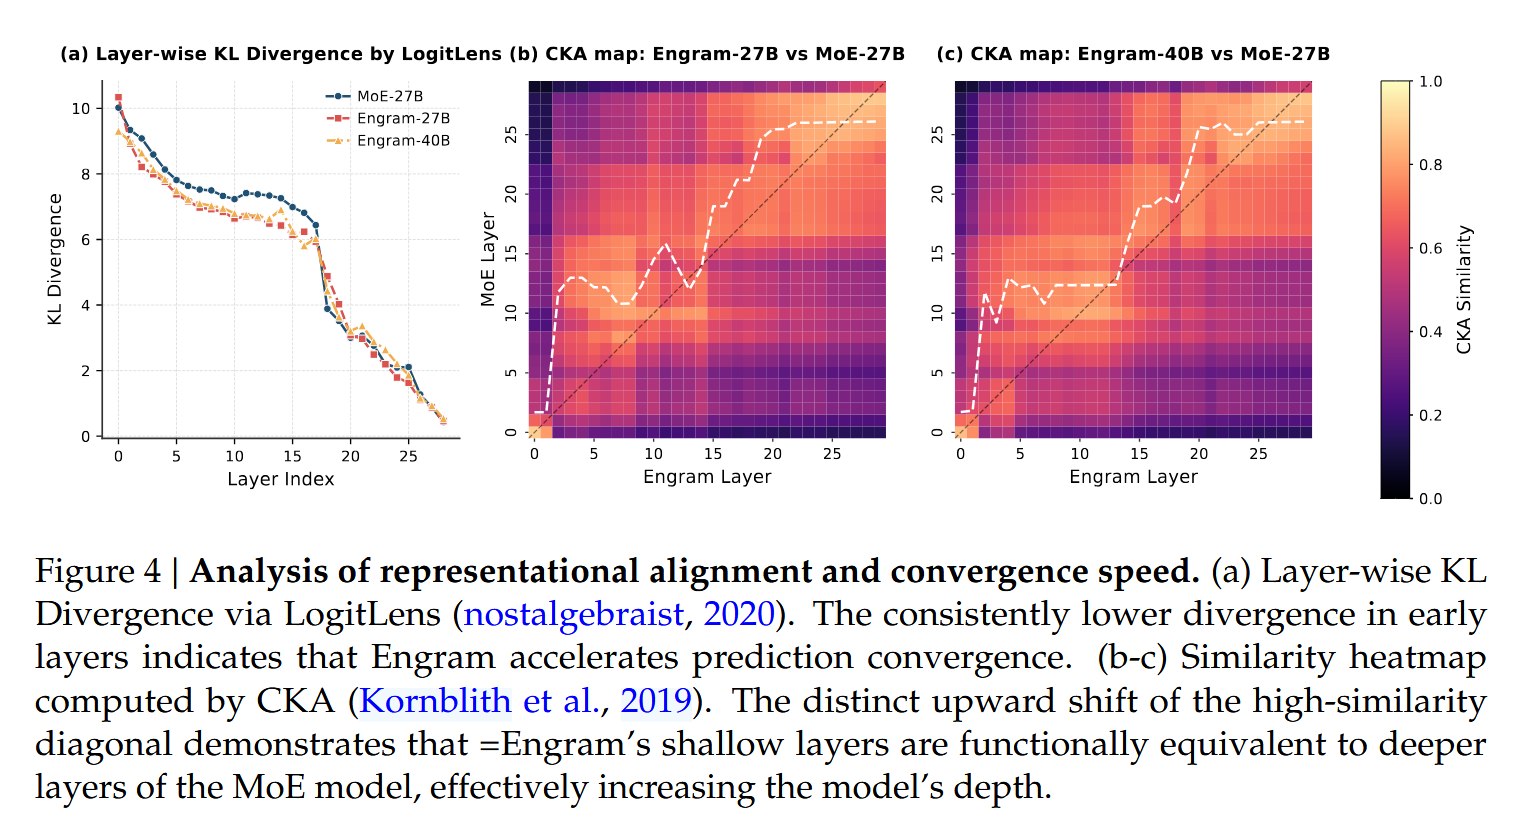
1. LogitLens 分析:中间层预测快速成熟
通过最终的 LM Head 投射各中间层的隐藏状态,计算与最终输出概率分布的 KL 散度:
- 如图 4(a) 所示,Engram 模型在前几层的 KL 散度呈现极陡峭的下降曲线,显著优于 MoE 基线。这表明网络在极早期的层数就已经完成了特征拼装,进入了“预测就绪(Prediction-ready)”状态。
2. CKA 中心核对齐与软对齐索引:几何层面的“层深倍增”
在 Few-NERD 实体识别数据集上,利用中心核对齐(Centered Kernel Alignment, CKA)计算 Engram 与 MoE 各层之间的表征相似度热力图,并定义软对齐重心索引 $a_j$:
$$a_j = \frac{\sum_{i \in \mathcal{I}_j} S_{i,j} \cdot i}{\sum_{i \in \mathcal{I}_j} S_{i,j}}$$- 如图 4(b)(c) 所示,相似度对角线发生显著向上偏移(Upward Shift, $a_j > j$);
- 实证数据:Engram-27B 的第 5 层表征,在数学相似度上直接等价于 MoE-27B 的第 12 层表征。
- 这从表示学习几何空间上严格证明了:引入 Engram 静态查表,在功能等价性上直接相当于将模型的物理深度增加了 2 倍以上。
4.5 消融实验与应力测试 (Ablations & Sensitivity)
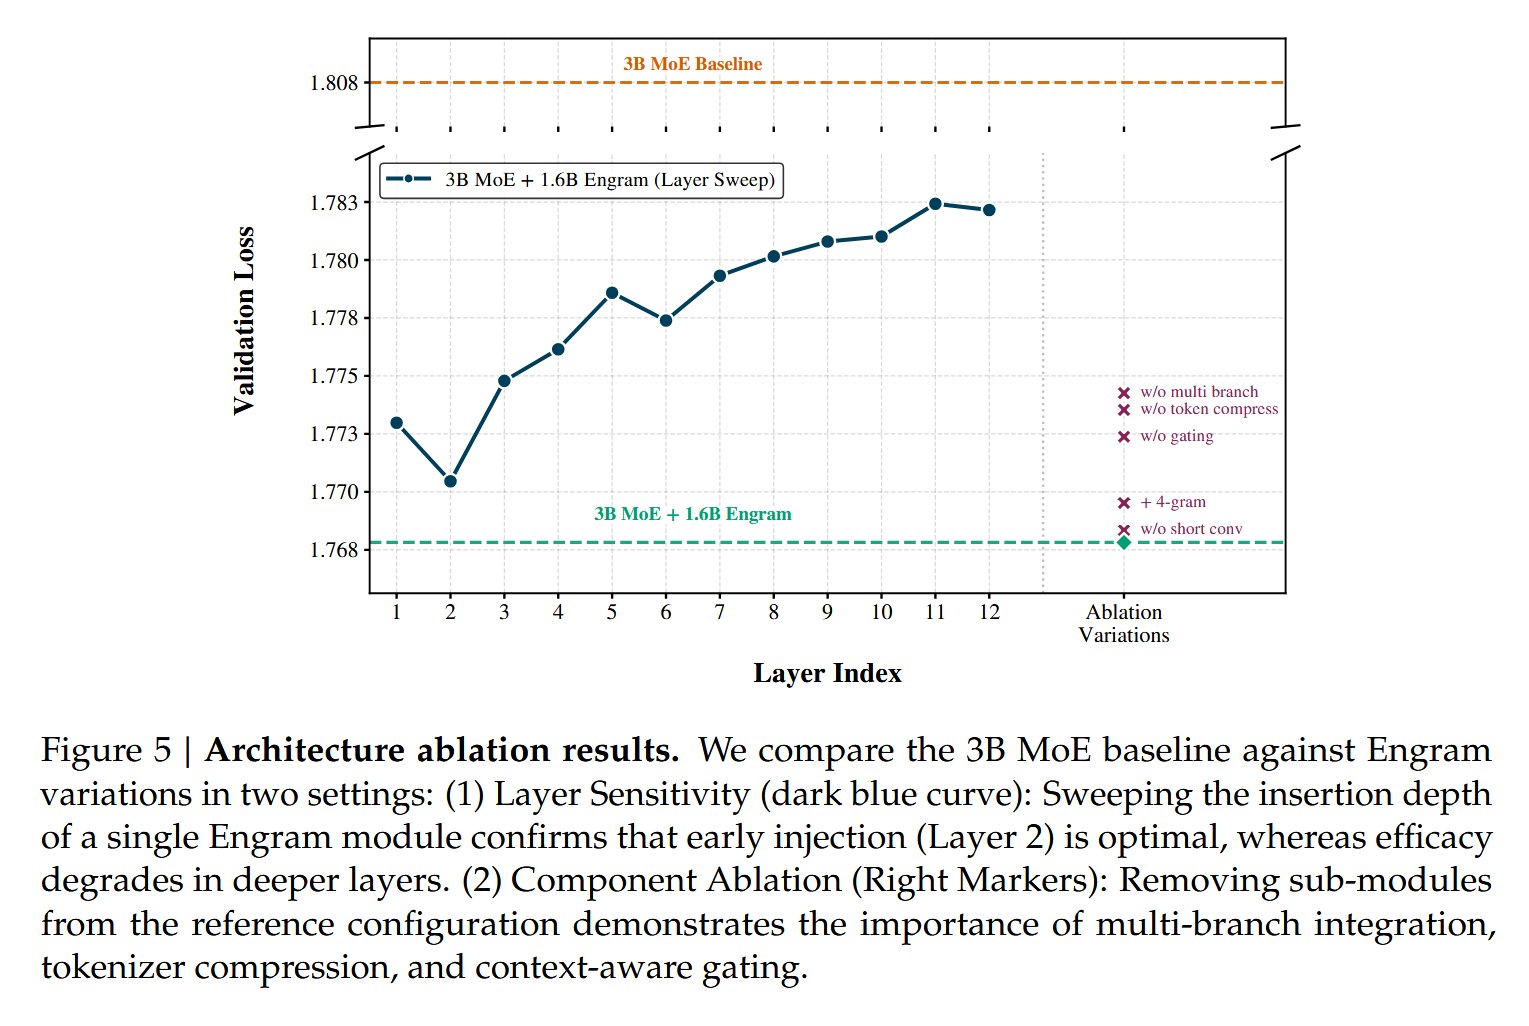
1. 挂载层数深度权衡 (Layer Sensitivity)
- 单层扫描测试(Layer 1 到 12):Layer 2 达到单层最佳性能(Val Loss = 1.770)。
- 权衡本质:挂在 Layer 1,由于缺乏注意力前序计算,缺乏全局语境做门控,哈希碰撞无法过滤;挂在太深(如 Layer 8~12),则错失了为底层卸载特征重构的最佳窗口。Layer 2 既经历了 1 次注意力聚合获得了上下文 Query,又处于浅层,刚好达成黄金平衡。
- 分层挂载更优:将同一份参数拆分挂在 Layer 2 与 Layer 6(Val Loss 进一步降至 1.768),兼顾了浅层早卸载与中层富语境门控。
2. 破坏性应力测试:事实知识与推理语境的绝对解耦
在推理阶段,强制将 Engram 模块的输出截断归零(Suppressing Engram at inference),测试各项能力留存率:
- 事实记忆型任务(Factual Knowledge)彻底瘫痪:TriviaQA 仅留存 29% 性能,PopQA、TriviaQA-ZH 仅留存 44%;
- 阅读理解型任务(Reading Comprehension)稳如泰山:C3 依然保留 93% 性能,RACE 保留 84%~89%。
- 结论:Engram 确实成为了事实性参数记忆的绝对核心容器,而语境推理逻辑则纯净地沉淀在 Transformer 主干的注意力机制中,实现了真正意义上的“记忆归记忆,计算归计算”。
4.6 真实端到端推理吞吐测试 (Inference Throughput & Offloading)
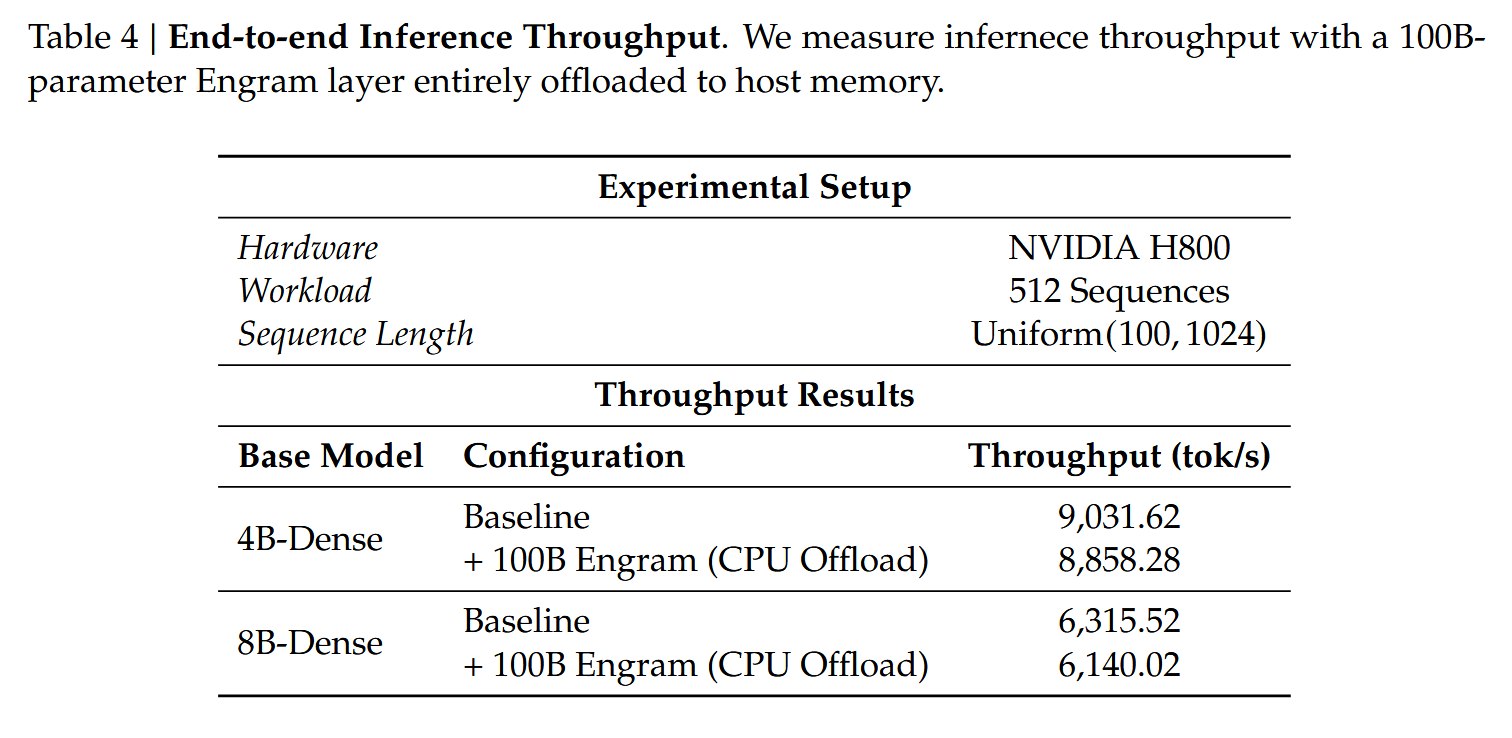
在配备单张 NVIDIA H800 的物理机上,使用 nano-vLLM 框架进行部署测试:
- 将 100B 参数的超巨型 Engram 表完全卸载至 Host CPU 内存(DRAM);
- 运行 512 序列、长度 100~1024 的高并发推理负载:
| 底座模型配置 | 模式 | 端到端吞吐量 (tokens/s) | 吞吐损耗率 |
|---|---|---|---|
| Dense-4B | 纯基线 | 9,031.62 | - |
| + 100B Engram (完全 CPU Offload) | 8,858.28 | 仅 -1.9% | |
| Dense-8B | 纯基线 | 6,315.52 | - |
| + 100B Engram (完全 CPU Offload) | 6,140.02 | 仅 -2.8% |
- 工业意义:仅需微乎其微的 1.9%~2.8% 吞吐损耗,就能在单张普通 GPU 上带动拥有千亿静态知识参数的模型。这一预取和流水线掩盖机制在工程上具有极其巨大的实用落地价值。
五、总结
Engram 证明了长期语义记忆中存在巨大的高度定型部分(Formulaic & Entity Patterns)。没有走“语义检索必须靠 Dense Embedding 算 Cosine Similarity Top-K”的思维定式。
范式基本就是 “离散精确召回 + 连续特征空间门控验证”:
- 第一阶段(极速召回):利用多头哈希在 $\mathcal{O}(1)$ 时间内精准匹配离散键值,开销为 0;
- 第二阶段(语境验算):以当前 Working Memory 的隐藏状态 $\mathbf{h}_t$ 作为 Query 进行点积门控。如果检索到的条目与当前交互语境相违背,门控值 $\alpha_t \to 0$ 自动抹杀噪声,这样一定程度上可以避免传统 RAG 的虚假召回与幻觉污染。
成本也不高,感觉可以做一些后续工作。
说些什么吧!