
零、写在前面
DeltaNet 和 TTT 本质上都是在做单层算子替换(试图把 Transformer 的 Attention 彻底换掉)。而 Titans 认为 “Attention 擅长精细的短期记忆,Neural Memory 擅长粗粒度的长期持久记忆”,二者不是替代关系,而是互补关系
一、标题
来源:NeurIPS 2025
Learning to Memorize at Test Time 有两层含义:
- 外循环训练一个模型,使其学会什么信息值得记忆、如何更新记忆;
- 在真正处理测试序列时,长期记忆网络仍然会用当前数据做 inner-loop learning。
这里的 “test time” 不是把整个大模型重新 fine-tune,而是让一个轻量的 memory module 在推理过程中更新自己的权重。
二、背景:从 attention 与 RNN 的记忆差异出发
2.1 Transformer 的 attention 可以看成关联记忆
给定输入序列 $x\in\mathbb R^{N\times d_{\mathrm{in}}}$,Transformer 先产生:
$$ Q=xW_Q,\qquad K=xW_K,\qquad V=xW_V. $$因果 softmax attention 的第 $i$ 个输出为:
$$ y_i = \sum_{j=1}^{i} \frac{\exp\left(Q_i^\top K_j / \sqrt{d_{\mathrm{in}}}\right)}{\sum_{\ell=1}^{i} \exp\left(Q_i^\top K_\ell / \sqrt{d_{\mathrm{in}}}\right)} V_j. $$从 memory 角度看:
- $K_j$ 是地址或上下文;
- $V_j$ 是与地址关联的内容;
- $Q_i$ 是检索信号;
- attention 用 query-key 相似度决定读取哪些 value。
Transformer 的优势是几乎不压缩当前 context:只要 token 仍在窗口内,就可以被精确访问。
2.2 Transformer 的代价:准确但不适合无限上下文
标准 attention 的主要问题:
- 序列内部两两交互带来近似 $O(N^2)$ 的训练代价;
- 推理时需要保存增长的 KV cache;
- 当 context 达到数十万、数百万甚至更长时,计算和内存管理都变得困难。
FlashAttention 等方法可以显著降低 I/O 浪费,但没有改变 attention 需要处理大量历史 key-value 的基本事实。
2.3 Linear attention:把历史压缩成矩阵
Linear attention 用 kernel feature map $\phi$ 替代 softmax kernel:
$$ \phi(Q_i^\top K_j) \approx \phi(Q_i)^\top\phi(K_j). $$利用结合律,可以先累计历史:
$$ M_t=\sum_{j=1}^{t}\phi(K_j)^\top V_j, $$再用当前 query 读取:
$$ y_t = \frac{ \phi(Q_t)M_t }{ \phi(Q_t)\sum_{j=1}^{t}\phi(K_j) }. $$取 identity kernel 时,最简单的递归形式可以写成:
$$ M_t=M_{t-1}+K_t^\top V_t, \qquad y_t=Q_tM_t. $$这使每个 token 的状态更新保持线性复杂度,推理可以只保存固定大小的矩阵。
但这种记忆写入是 additive:
$$ M_t=M_{t-1}+K_t^\top V_t. $$长序列中不断累加会产生两个问题:
- 过去的信息很难被主动删除;
- 多个 key-value 关系会竞争有限的矩阵状态,最终出现 memory overflow 或 collision。
2.4 RNN 的 memory perspective
这里把一般 RNN 写成:
$$ M_t=f(M_{t-1},x_t), $$$$ y_t=g(M_t,x_t). $$其中:
- $f$ 是 write operation;
- $g$ 是 read operation;
- $M_t$ 是 hidden state,也就是 memory。
从这个角度看:
- Transformer:memory 是增长的 key-value 列表,更新是 append,读取是 similarity search;
- linear attention:memory 是固定大小矩阵,更新是 additive write;
- 普通 RNN/SSM:memory 通常是固定大小向量或结构化状态;
- Titans:memory 是一个可以在序列上学习的 neural network。
2.5 现有 linear recurrent models 的两个改进方向
论文总结了两条主要路线。
路线一:加入 forgetting/gating
GLA、LRU、Griffin、xLSTM、Mamba2 等通过 data-dependent decay 或 gate 控制旧状态保留多少:
$$ M_t=\gamma_t\odot M_{t-1}+\text{new write}. $$它们缓解了记忆无限累加,但通常仍使用较简单的状态结构。
路线二:改进 write rule
Delta Rule 不直接加入新的 key-value,而是先根据当前 key 读取旧值,再根据误差修正:
$$ M_t = M_{t-1} -\beta_t(M_{t-1}K_t-V_t)K_t^\top. $$它比纯 additive update 更擅长覆盖已有关系,但如果没有额外 forgetting,长序列仍可能发生容量问题。
Titans 试图把两条路线结合起来,并进一步使用 deep memory、momentum 和 token flow。
2.6 “人类记忆”的启发
论文借鉴认知科学中的区分:
- short-term memory:保存当前正在处理的信息;
- working memory:参与当前推理;
- long-term memory:保留更久的抽象或事件;
- persistent/meta memory:保存任务和规则相关知识。
这不是说 Titans 已经模拟了人脑,而是提供了一个架构设计启发:
不同时间尺度、不同功能的 memory 不必强行塞进同一个状态;可以用不同模块协作。
三、Neural Long-term Memory:测试时学习的记忆
3.1 “直接记忆训练数据”不是好方案
一个直觉方法是训练神经网络,让它拟合过去的数据,再把网络参数当作记忆。但单纯 memorization 有问题:
- 容易过拟合;
- 可能损害泛化;
- 测试数据可能 distribution shift;
- 机械记住每个样本不等于学会有用的历史抽象。
因此 Titans 不让 memory 只做普通的静态拟合,而是让它成为一个 online meta-model:
- 外循环学会 memory 应该怎样学习;
- 测试时 memory 只用当前序列持续适应;
- surprise 和 forgetting 决定哪些内容值得保留。
3.2 Momentary surprise:用梯度衡量“意外程度”
假设历史 $x_1,\ldots,x_{t-1}$ 已被压缩到 memory 参数 $M_{t-1}$ 中。一个输入如果与已有记忆不一致,memory loss 对参数的梯度通常更大。
因此,论文把 surprise 与梯度联系起来:
$$ M_t = M_{t-1} - \theta_t\nabla\ell(M_{t-1};x_t). $$这里:
- $\ell$ 是 memory 学习目标;
- $\nabla\ell$ 是当前 token 带来的 momentary surprise;
- $\theta_t$ 是 data-dependent 写入强度。
直观解释:
- 梯度小:当前输入与已有记忆相容,更新较小;
- 梯度大:当前输入带来新模式或矛盾,写入较强。
3.3只用 momentary surprise 不够
如果一个重要事件持续多个 token:
- 第一个 token 可能产生很大梯度;
- memory 更新后,后续相关 token 的梯度变小;
- 如果只看每一步 momentary gradient,后续信息可能不会被完整存储。
论文用人类记忆作类比:一个事件最初引起注意后,后续一段相关信息即使不再“惊讶”,仍然可能属于同一个值得记忆的 episode。
3.4 Past surprise + momentary surprise:引入 momentum
论文维护一个 surprise state $S_t$:
$$ M_t=M_{t-1}+S_t, $$$$ S_t = \eta_t S_{t-1} - \theta_t\nabla\ell(M_{t-1};x_t). $$两项分别是:
- $\eta_tS_{t-1}$:past surprise,保留最近一段时间的惊讶;
- $-\theta_t\nabla\ell$:momentary surprise,当前 token 的即时更新。
这实际上类似 gradient descent with momentum,但论文赋予它新的记忆解释:
Momentum 不只是优化器技巧,而是让 surprise 沿 token flow 传播的一种短期记忆。
3.5 Data-dependent surprise decay
$\eta_t$ 是依赖输入的 surprise decay:
$$ \eta_t=\eta(x_t). $$它可以根据上下文连续性决定旧 surprise 是否继续有效:
- $\eta_t\to 0$:可能发生了 context switch,忽略先前的 surprise;
- $\eta_t\to 1$:当前 token 与近期内容相关,继续传播旧 surprise。
这比固定 momentum 更灵活,因为不同 token 的上下文关联程度不同。
3.6 Associative memory objective
Titans 的 memory 不是直接拟合原始 token,而是学习 key-value association。
对输入 $x_t$:
$$ k_t=x_tW_K, \qquad v_t=x_tW_V. $$其中 $W_K,W_V$ 是 outer-loop 学习的投影参数。
Memory 的 inner-loop loss 为:
$$ \ell(M_{t-1};x_t) = \left\|M_{t-1}(k_t)-v_t\right\|_2^2. $$这要求 memory 学会:
$$ k_t\mapsto v_t. $$重要的参数角色区分:
- inner loop 优化 $M$ 的参数;
- outer loop 优化 $W_K,W_V$ 以及整个网络的其他参数;
- $W_K,W_V$ 在 inner loss 中相当于 hyperparameters。
这使 Titans 与 TTT、fast-weight、online learning 处在同一条思想链上,但 Titans 使用更深的 memory,并加入了 momentum 与 forgetting。
3.7 Forgetting:用 weight decay 管理有限容量
为了让 memory 可以删除旧信息,论文引入 $\alpha_t\in[0,1]$:
$$ M_t=(1-\alpha_t)M_{t-1}+S_t, $$$$ S_t = \eta_tS_{t-1} - \theta_t\nabla\ell(M_{t-1};x_t). $$其中 $\alpha_t$ 是 forget gate:
- $\alpha_t\to0$:基本保留旧 memory;
- $\alpha_t\to1$:大幅清除已有 memory;
- 中间值:对旧记忆做衰减。
从优化角度看,这等价于在 inner loop 中加入 data-dependent weight decay。也就是说:
忘记历史不是额外的神秘操作,而可以被解释为对 memory 参数施加可学习的 weight decay。
3.8 训练与读取是两个不同过程
写入 memory 时,使用带权重更新的 forward/training:
$$ M_t=M_{t-1}+\text{memory update}. $$读取 memory 时,不更新权重:
$$ y_t=M^*(q_t), \qquad q_t=x_tW_Q. $$符号 $M^*$ 表示不进行 weight adjustment 的普通 forward。
因此 memory 既是:
- 一个通过 inner learning 记忆历史的模型;
- 一个通过 query 读取已学习知识的函数。
3.9 为什么需要 deep memory
如果 $M$ 是线性模型 $W\in\mathbb R^{d_{\mathrm{in}}\times d_{\mathrm{in}}}$,loss 变为:
$$ \ell(W;x_t) = \left\|Wk_t-v_t\right\|_2^2, $$本质是 online linear regression。它只能用线性映射表达历史 key-value 关系。
如果 $M$ 是至少两层的 MLP:
$$ M(k)=W_L\sigma(\cdots\sigma(W_2\sigma(W_1k))\cdots), $$那么它可以表达更丰富的非线性关系。论文的设计选择是:
- $L_M=1$:线性 memory;
- $L_M\ge2$:deep neural memory;
- 通过实验研究 memory depth 与效果/效率的关系。
需要谨慎理解:深度增加的是函数表达能力,不等于可以无限存储信息;它仍然需要在有限参数和更新机制下进行压缩。
四、如何并行训练 Neural Memory
4.1 顺序更新成为硬件瓶颈
理论上,逐 token 更新 memory 的 FLOPs 可以是线性的:$O(N)$
但 GPU/TPU 更擅长大规模矩阵乘法,而逐 token 更新会产生:
- 时间依赖;
- 大量小矩阵操作;
- 参数和梯度频繁读写;
- 较低的 accelerator utilization。
因此论文需要把 inner-loop learning 重新写成可 tensorize 的形式。
4.2 Mini-batch gradient descent
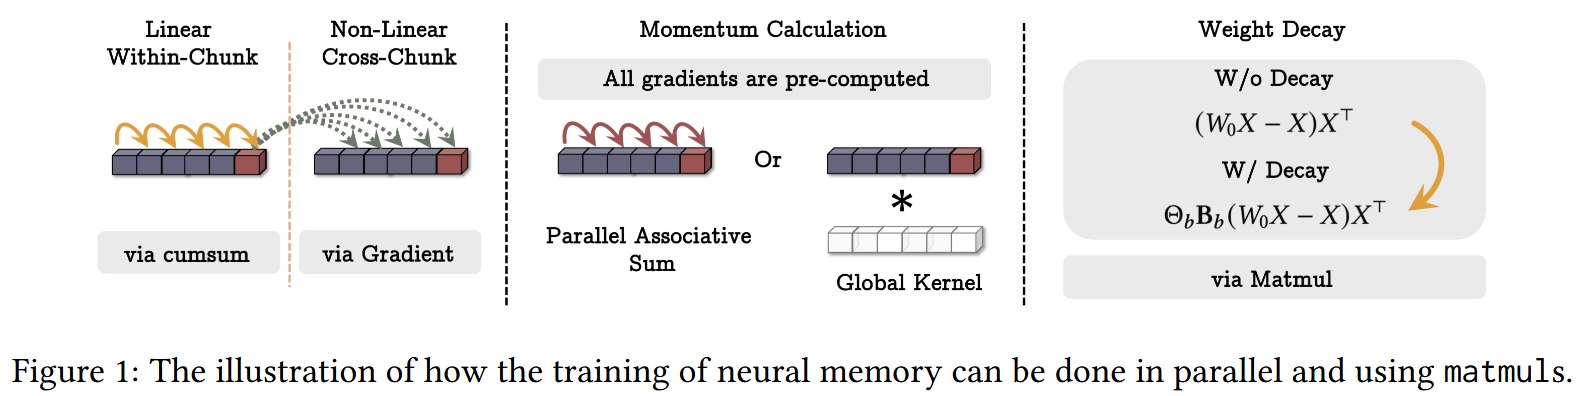
论文把序列切成大小为 $b$ 的 chunk。一个 chunk 内的 token 使用 chunk 开始时的 memory 状态计算 gradient,因此可以并行:
$$ M_t = (1-\alpha_t)M_{t-1} - \theta_t\nabla\ell(M_{t'};x_t), $$其中:
$$ t'=t-\operatorname{mod}(t,b). $$也就是说,梯度在 mini-batch 内共享同一个参考状态 $M_{t'}$,而 chunk 之间仍然顺序传递状态。
4.3 Weight decay 的展开
令:
$$ \beta_t=\prod_{j=1}^{t}(1-\alpha_j). $$则递归可以展开成:
$$ M_t = \beta_tM_0 - \sum_{i=1}^{t} \frac{\beta_t}{\beta_i} \theta_i\nabla\ell(M_{t'};x_i). $$这个形式揭示了:
- 初始 memory 会被累计 decay;
- 不同时间位置的 gradient 会被不同程度地保留;
- weight decay 与历史更新的线性组合可以用矩阵操作组织。
4.4 线性 memory 的矩阵化
对于 $M_t=W_t$,令:
$$ X=[x_1,\ldots,x_b]. $$在第一 chunk 中,梯度可以组合为:
$$ \sum_{t=1}^{b} \frac{\beta_b}{\beta_t}\theta_t\nabla\ell(W_0;x_t) = \Theta_bB_b(W_0X-X)X^\top, $$其中 $\Theta_b$ 与 $B_b$ 是由 data-dependent 系数组成的对角矩阵。
这一步把逐 token 的 outer products 变成了矩阵乘法。
4.5 Momentum 项可以用 parallel associative scan
记:
$$ u_t=\nabla\ell(M_{t'};x_t). $$Momentum 递推为:
$$ S_t=\eta_tS_{t-1}-\theta_tu_t. $$这是一个带输入 $u_t$、转移系数 $\eta_t$ 的线性递归,因此可以使用 parallel associative scan 计算 chunk 内的 $S_t$。
论文的关键工程思想是:
只要把递归拆成可以结合的状态转移,仍然可以使用 parallel scan;而不是把所有时间依赖都当成无法并行。
4.6 Chunk-level parameters 的进一步简化
论文还讨论一种更快但表达能力稍弱的版本:
- $\alpha,\theta,\eta$ 不依赖每个 token;
- 而是在一个 chunk 内共享;
- 这样部分递归变成线性时不变系统;
- 可以使用 global convolution 等方式加速。
本文实验使用 token-dependent 参数,chunk-dependent 参数留作未来方向。
4.7 训练复杂度的直觉
Titans 的内循环依然需要沿 chunk 传递 memory,但 chunk 内可以并行:
- chunk 内:matmul、sum、scan;
- chunk 间:传递 memory state;
- backward:需要对 inner update 求梯度。
因此它不是完全没有递归,而是把递归粒度从 token 级降低到 chunk 级,同时用 accelerator 友好的操作覆盖 chunk 内大部分工作。
五、Persistent Memory:任务相关的长期知识
5.1 contextual memory 还不够
Neural long-term memory 是 contextual memory:
- 它完全依赖当前输入序列;
- 不同输入序列会形成不同的 memory 参数;
- 它负责记住当前 episode 的历史。
但一个有效模型还需要 task-related memory,例如:
- 如何完成任务;
- 任务中的稳定规则;
- 不依赖具体输入的知识;
- 训练过程中积累的抽象。
因此 Titans 引入 persistent memory。
5.2 Persistent memory 的实现
取 $N_p$ 个可学习、与输入无关的向量:
$$ P=[p_1,p_2,\ldots,p_{N_p}]. $$将它们拼接到输入序列开头:
$$ x_{\mathrm{new}} = [p_1,p_2,\ldots,p_{N_p}]\Vert x. $$这些向量在训练时学习,在推理时不随当前输入变化。
5.3 三个动机
Memory perspective
长期记忆系统需要:
- contextual memory:记住当前上下文;
- persistent/meta memory:记住任务抽象。
Feedforward perspective
Transformer 的 feedforward layer 可以被理解为数据无关的 key-value memory:
$$ \mathrm{FFN}(x) \approx W_V\operatorname{Softmax}(W_Kx). $$其中 $W_K,W_V$ 类似固定的 key-value 表。
Persistent tokens 也可以承担类似的输入无关 memory 功能。
Technical perspective
Causal attention 对序列开头 token 存在 implicit bias,早期 token 可能获得异常高的注意力。Persistent memory token 可以帮助重新分配 attention pattern,减弱这种位置偏置。
六、Titans 的三种架构
Titans 的三个 hyper-head 是:
- Core:处理当前上下文的短期记忆;
- Long-term memory:学习并保存长历史;
- Persistent memory:保存与具体输入无关的任务知识。
论文提出三种组合方式。
6.1 MAC:Memory as a Context
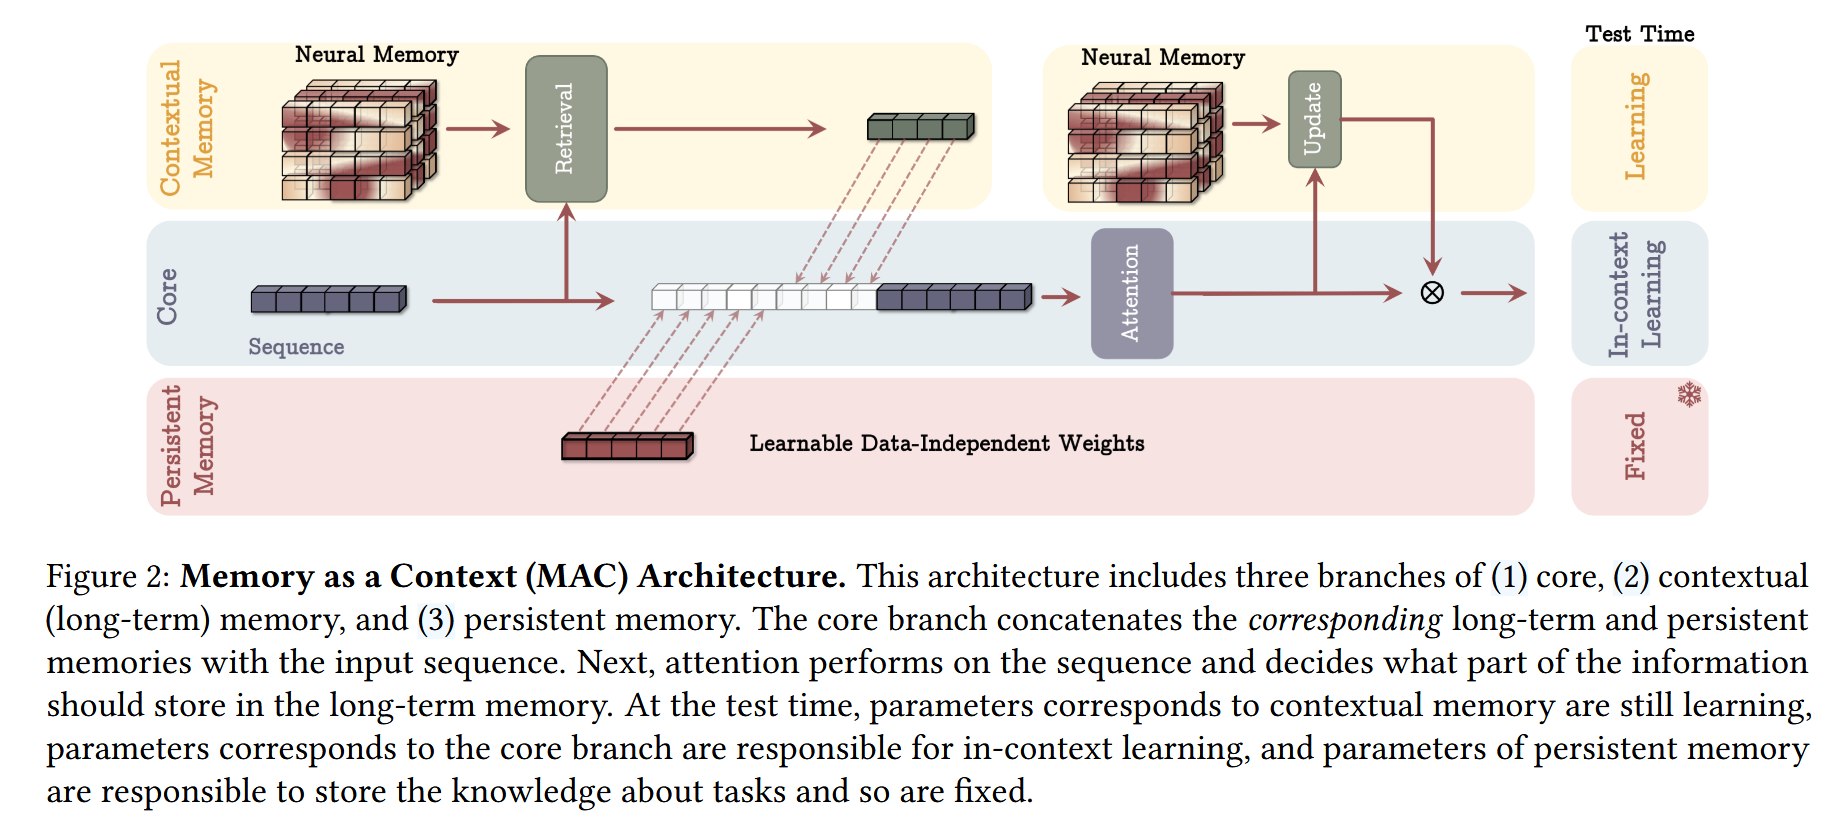
MAC 把 long-term memory 读取结果作为 attention 的历史上下文。
将长序列切成 segment $S^{(1)},S^{(2)},\ldots$。处理第 $t$ 个 segment 时,先用当前 segment 的 query 从上一个 memory state 读取:
$$ q_t=S^{(t)}W_Q, $$$$ h_t=M_{t-1}^*(q_t). $$然后把 persistent memory、长期记忆检索结果和当前 segment 拼接:
$$ \widetilde S^{(t)} = [p_1,\ldots,p_{N_p}] \Vert h_t \Vert S^{(t)}. $$对该上下文执行 causal attention:
$$ y_t=\mathrm{Attn}(\widetilde S^{(t)}). $$再用 attention 输出更新 neural memory:
$$ M_t=M_{t-1}(y_t), $$并得到最终输出:
$$ o_t=y_t\otimes M_t^*(y_t). $$这里 $\otimes$ 表示融合操作。
MAC 的直觉
MAC 中 attention 先看到:
- 从长期 memory 检索出的历史摘要;
- 当前 segment;
- persistent task memory。
因此 attention 可以决定:
- 哪些长期信息与当前问题有关;
- 当前 segment 中哪些内容值得写入长期 memory;
- 如何把短期与长期信息组合。
MAC 的优点
- 能显式让短期 attention 判断长期记忆是否有用;
- attention 输出帮助过滤当前 segment 中不值得记忆的 token;
- 对较长依赖和跨 segment 推理通常更强。
MAC 的代价
- 需要 segment 化;
- 每个 segment 都要执行 attention;
- memory retrieval、attention、memory update 的数据流更复杂。
6.2 MAG:Memory as a Gate
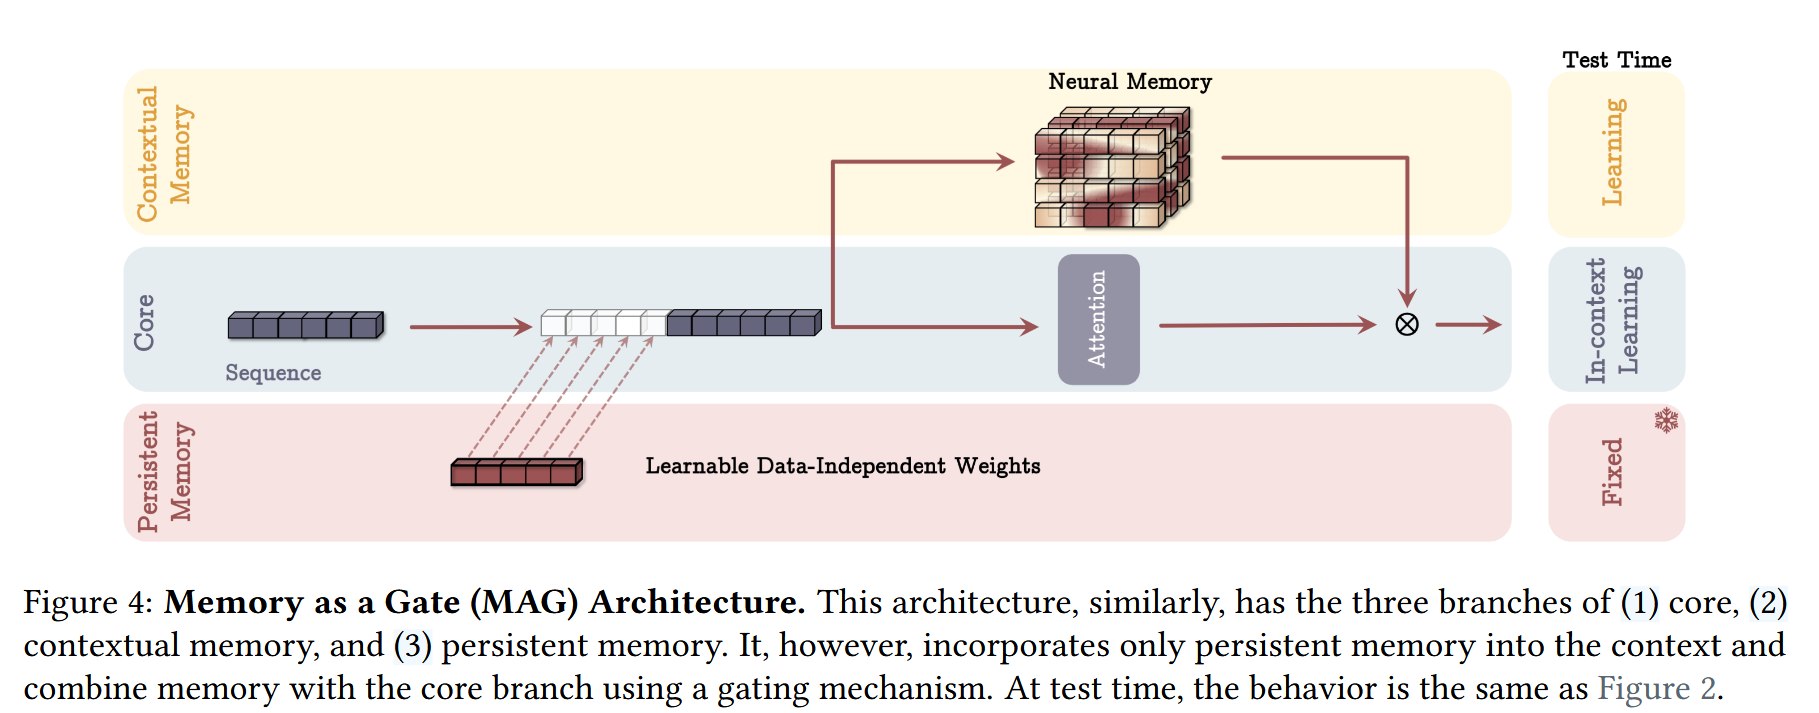
MAG 使用 sliding-window attention 作为短期记忆,neural memory 作为长期/衰减记忆,并用 gate 融合。
先将 persistent memory 加到输入:
$$ \widetilde x=[p_1,\ldots,p_{N_p}]\Vert x. $$短期分支:
$$ y=\mathrm{SWA}^*(\widetilde x). $$长期分支:
$$ o=y\otimes M^*(\widetilde x). $$论文实现中,会对 $y$ 和 $M(\widetilde x)$ 使用带可学习向量权重的 normalization,再经过非线性函数实现 gating。
MAG 的直觉
- SWA 精确处理最近窗口内的 token;
- neural memory 以可学习方式保存更久的信息;
- gate 决定两种记忆在输出中的混合比例。
MAG 不把 long-term memory 作为 attention 的显式输入,而是把它作为 parallel branch,因此更像两个不同时间尺度的 head。
6.3 MAL:Memory as a Layer
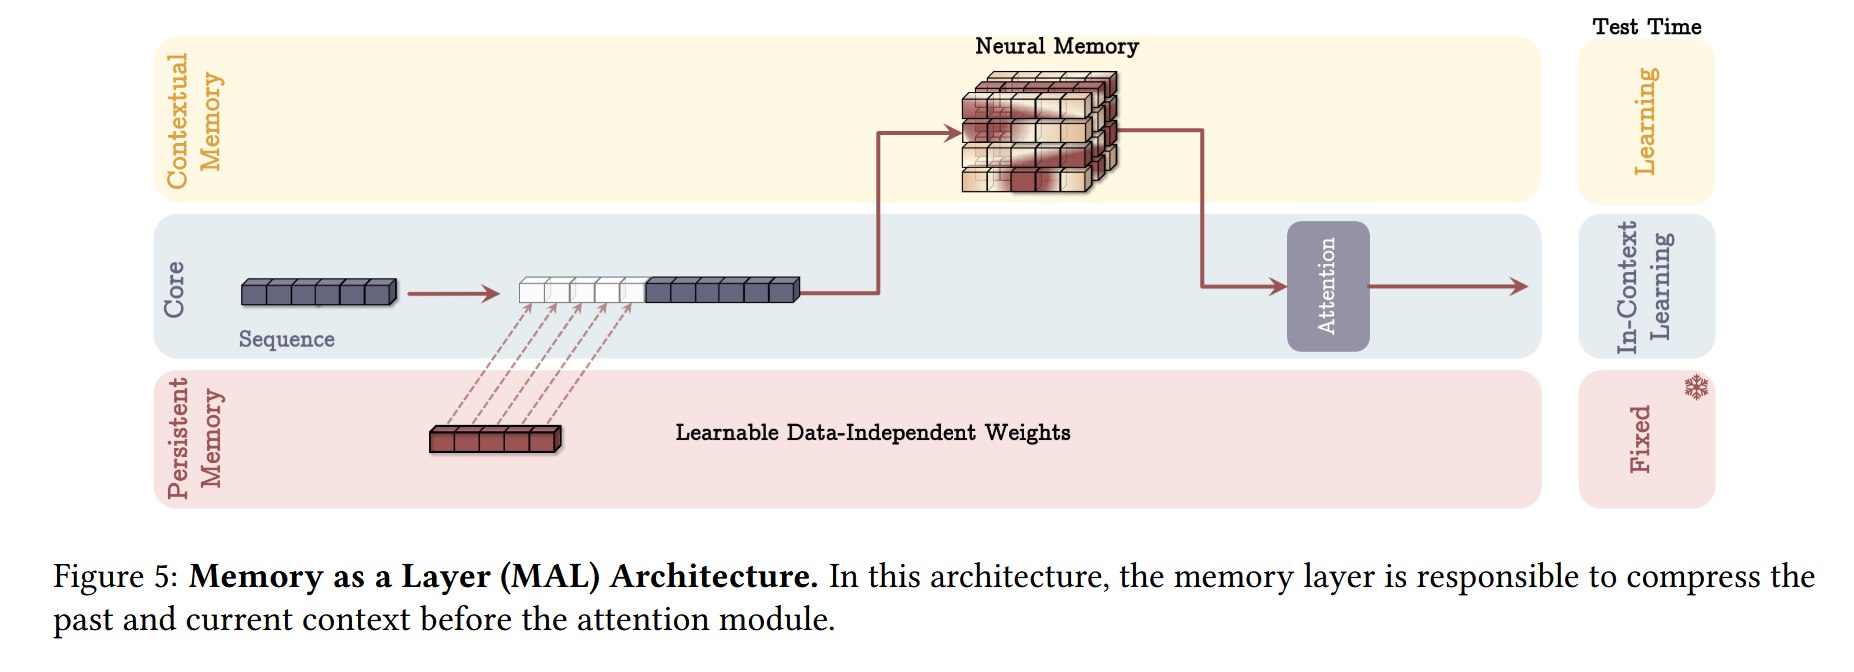
MAL 将 neural memory 作为序列模型层,再接 sliding-window attention:
$$ \widetilde x=[p_1,\ldots,p_{N_p}]\Vert x, $$$$ y=M(\widetilde x), $$$$ o=\mathrm{SWA}(y). $$这是一种常见的 sequential hybrid:
$$ \text{long-term memory layer} \rightarrow \text{short-term attention layer}. $$MAL 的优点
- 结构简单;
- 便于堆叠;
- 可以复用已有 recurrent + attention 架构。
MAL 的局限
长期 memory 必须先压缩和变换信息,attention 只能读取 memory 输出;两种模块不能像 MAC/MAG 那样直接并行地互相选择信息。
6.4 LMM:只使用 Neural Memory
论文还单独评估 neural long-term memory module:
$$ \mathrm{Titans\ (LMM)}. $$它没有 attention,目的是检验:
long-term memory 本身是否具有足够的序列建模能力,而不是只能依附于 attention。
论文将其看成独立的 sequence model。这个实验也帮助区分:
- memory module 的能力;
- hybrid architecture 的能力。
6.5 统一比较
| 变体 | 短期模块 | 长期模块如何接入 | 关键特性 |
|---|---|---|---|
| LMM | 无 attention | neural memory 独立处理序列 | 检验 memory 本身 |
| MAC | full attention on segment | 作为 attention context | 更强的跨 segment 选择 |
| MAG | sliding-window attention | 与 memory branch gating 融合 | 两个并行时间尺度 |
| MAL | sliding-window attention | memory layer 在前 | 最简单的串行 hybrid |
七、架构实现细节
7.1 Query/key/value projection
论文使用 SiLU 作为 query、key、value projection 后的非线性,并对 query/key 使用 $\ell_2$ normalization。
7.2 Short convolution
在 query、key、value projection 后加入 1D depthwise-separable convolution:
- 提供局部 token mixing;
- 计算成本较低;
- 与 Mamba、Gated DeltaNet 等现代 recurrent model 保持一致。
论文指出 convolution 对总体性能提升不大,但通常有正向作用。
7.3 Residual 与 gating
所有 block 使用 residual connection。输出 projection 前使用 normalization 和线性 gating,以控制不同分支的融合。
7.4 Theoretical expressivity claim
论文给出 Theorem 4.1,声称 Titans 能够解决超出 $TC^0$ 的部分 state-tracking 问题,而 Transformers、diagonal linear recurrent models 和 DeltaNet 被归入 $TC^0$ 限制范围。
对这条理论结论应谨慎理解:
- 它讨论的是特定计算模型下的理论表达能力;
- 并不等于 Titans 在所有实际任务上都必然优于 Transformer;
- 论文实验的主要证据仍然是经验结果,而不是该定理本身。
八、实验
8.1 实验问题与设置
论文实验主要回答:
- Titans 在语言建模和 common-sense reasoning 上是否优于现代 recurrent models 与 Transformer?
- 它的 effective context length 到底有多长?
- 能否在超过 2M context 上工作?
- memory depth 是否真的有效?
- neural memory 在时间序列和 DNA 等非语言任务上是否泛化?
- surprise、momentum、forgetting、convolution、persistent memory 各自贡献多大?
- MAC、MAG、MAL 三种架构的效率/效果 trade-off 如何?
模型规模与数据:
主要语言实验使用:
- 170M;
- 340M;
- 400M;
- 760M 参数。
其中:
- 170M、340M、400M 训练 15B tokens;
- 760M 训练 30B tokens;
- 训练数据来自 FineWeb-Edu;
- tokenizer 为 Llama 2 tokenizer,词表大小 32K;
- 默认训练长度为 4K tokens;
- batch size 为 0.5M tokens;
- AdamW;
- learning rate 为 $4\times10^{-4}$;
- cosine annealing;
- weight decay 为 0.1。
Baselines:
语言任务比较:
- Transformer++;
- RetNet;
- GLA;
- Mamba;
- Mamba2;
- DeltaNet;
- TTT;
- Gated DeltaNet;
- Samba;
- Gated DeltaNet-H2。
长上下文 NIAH/BABILong 还比较:
- GPT-4;
- GPT-4o-mini;
- Llama 3/3.1;
- Llama with RAG;
- Mistral;
- RecurrentGemma;
- RWKV;
- Qwen2.5;
- RMT。
8.2 语言建模与 common-sense reasoning
Table 1 报告 Wikitext、LAMBADA、PIQA、HellaSwag、WinoGrande、ARC-e、ARC-c、SIQA 和 BoolQ。
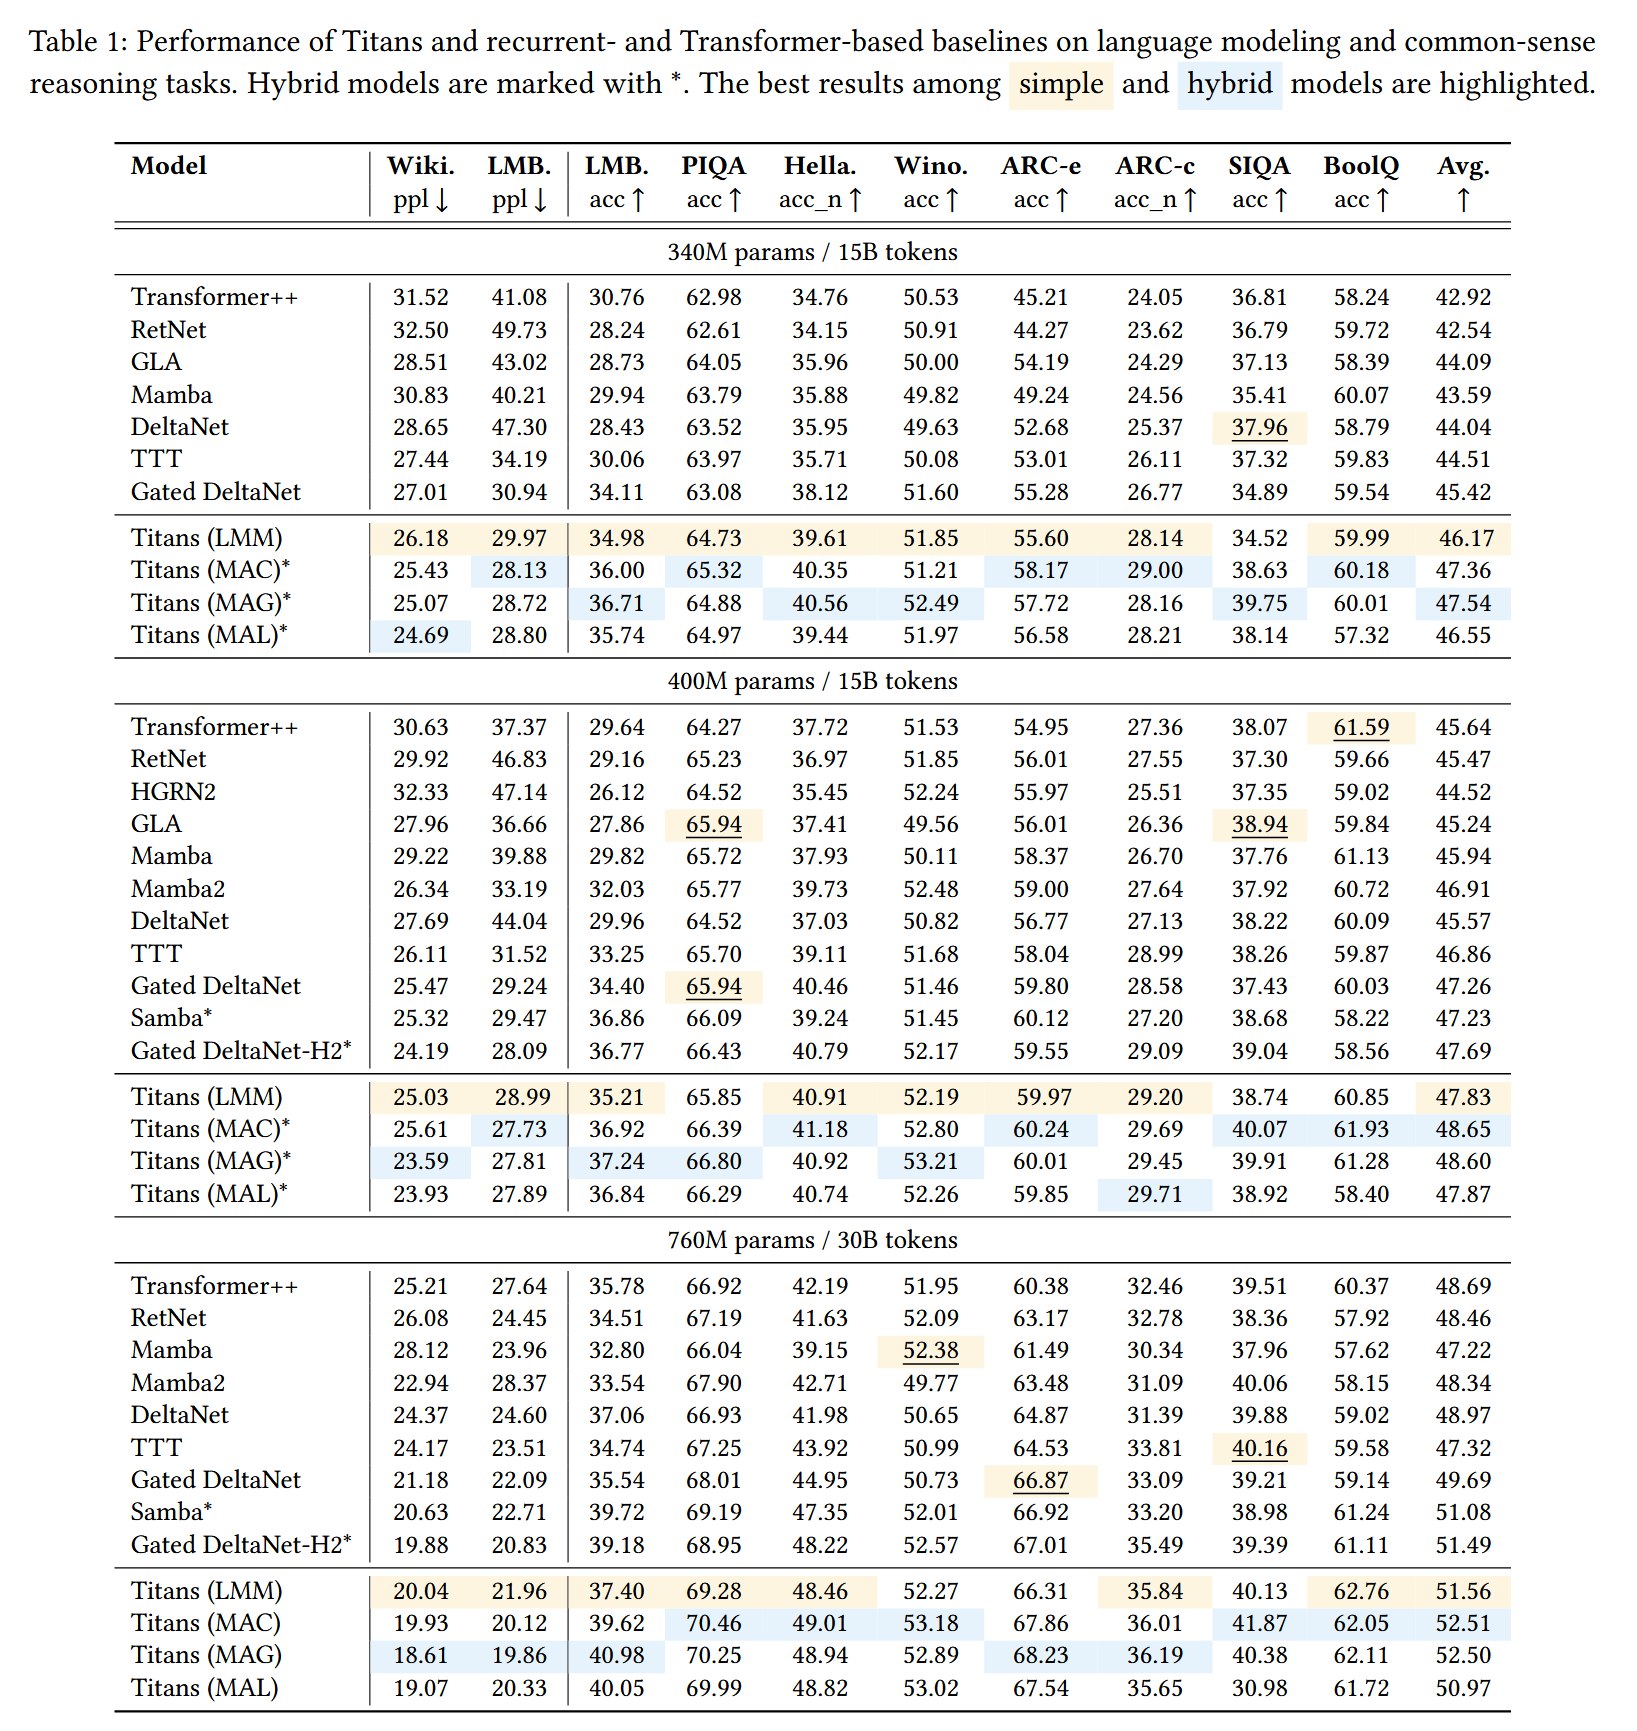
340M / 15B tokens
观察:
- LMM 已经优于大多数 non-hybrid baselines;
- MAC、MAG、MAL 在语言建模上进一步提升;
- MAG 的 common-sense 平均分最高;
- MAL 的 Wikitext PPL 最低,但整体平均 reasoning 不一定最高;
- hybrid 的收益不仅来自 memory module,也来自组合方式。
400M / 15B tokens
在 400M 设置中:
- Titans (MAG) 的 Wikitext PPL 为 23.59;
- Titans (MAC) 的 commonsense average 为 48.65;
- 两者均优于主要 recurrent baseline;
- hybrid Titans 整体优于 Samba 和 Gated DeltaNet-H2。
760M / 30B tokens
760M 设置中:
- Titans (MAG) 的 Wikitext PPL 为 18.61;
- Titans (MAC) 的 commonsense average 为 52.51;
- Titans (MAC/MAG) 在多项指标上超过大多数 recurrent/hybrid baseline;
- Titans (MAL) 的 SIQA 数值出现明显异常低点,说明不同任务上架构收益并不一致,不能只看一个指标。
8.3 如何解释 LMM 优于 TTT
论文重点比较 LMM 与 TTT:
- 二者都使用 gradient-based recurrent memory;
- LMM 额外使用 weight decay/forget gate;
- LMM 使用 momentum,把 surprise 传播到相邻 token;
- LMM 使用 deep non-linear memory。
因此作者将性能提升归因于三点:
- Forgetting:有能力清除过时信息;
- Momentum:保留一个事件的 token flow;
- Deep memory:比线性矩阵能表示更复杂的 key-value 关系。
这是合理的机制解释,但需要注意:LMM 与 TTT 不只差一个组件,实验中的架构、实现和训练细节也可能共同影响结果。
8.4 NIAH:effective context length
论文使用 RULER 的 Single Needle in a Haystack,测试 2K、4K、8K、16K。
三个任务:
- S-NIAH-PK;
- S-NIAH-N;
- S-NIAH-W。
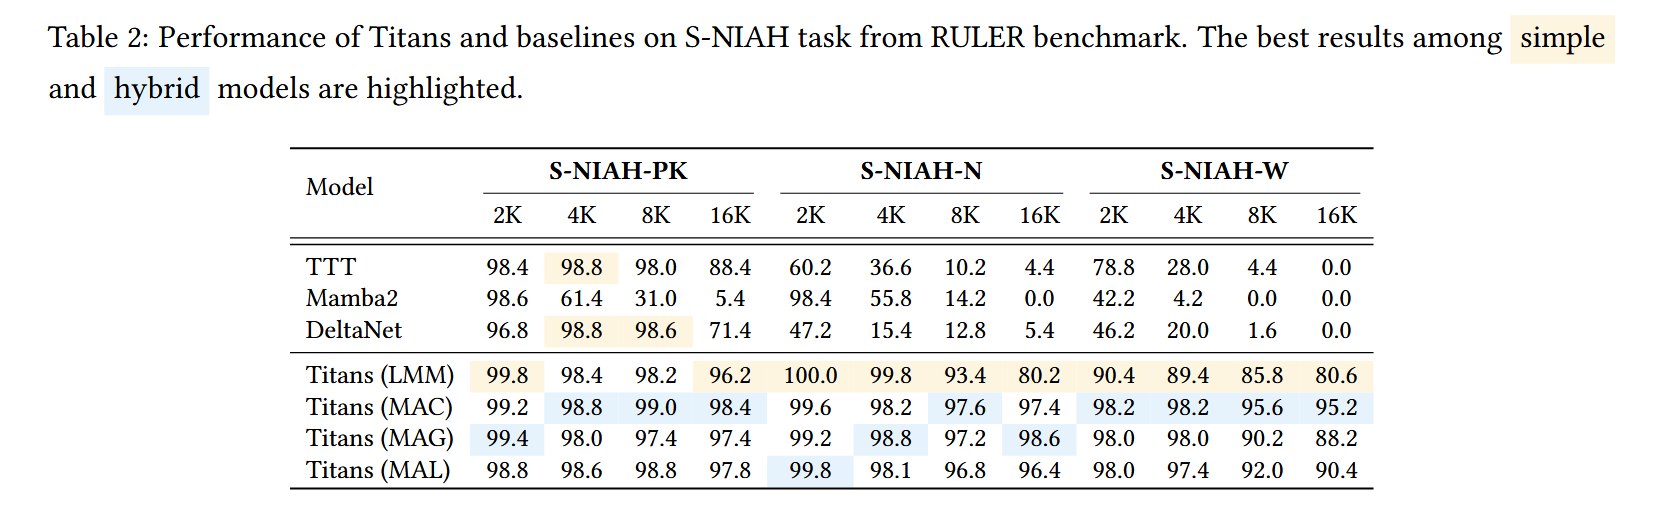
关键趋势:
- TTT、Mamba2 和 DeltaNet 的性能随长度增加明显下降;
- Titans 的下降更慢;
- LMM 已经有较强的长期检索能力;
- MAC 在三类任务中整体最稳定;
- Titans 不只是“支持更长输入”,而是在长输入中仍然能检索到 needle。
因此论文强调:context window size 不等于 effective context length。
8.5 BABILong:长文档中的多步推理
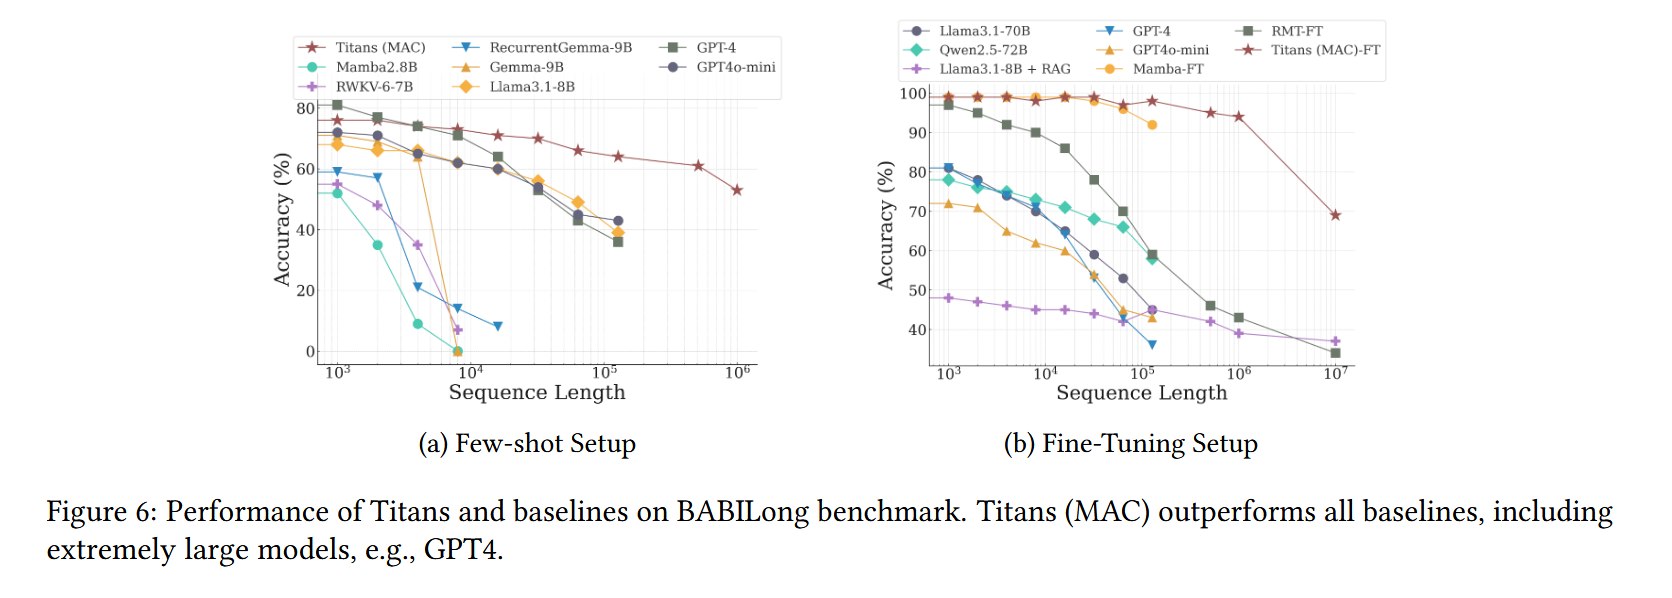
NIAH 只要求找一个 needle,BABILong 更难:
- 事实分布在长文档不同位置;
- 模型需要组合多个事实;
- 需要跨长距离进行推理。
论文报告:
- few-shot 设置中,Titans (MAC) 超过 Mamba2.8B、RWKV-6-7B、RecurrentGemma-9B、Gemma-9B、Llama3.1-8B、GPT-4 和 GPT-4o-mini;
- fine-tuning 设置中,小型 Titans (MAC) 超过 fine-tuned Mamba、RMT、带 RAG 的 Llama3.1-8B,以及 GPT-4、GPT-4o-mini、Qwen2.5-72B、Llama3.1-70B 等 baseline;
- 论文特别指出,Llama3.1-8B + RAG 仍不如参数量约小 70 倍的 Titans MAC。
这组结果很强,但横向比较应注意:
- 部分 baseline 是预训练大模型;
- 部分是 RAG;
- 部分是 fine-tuned 模型;
- 任务和评测协议由 benchmark 提供;
- Titans 的结果与其他模型可能并非完全同一训练条件。
更稳妥的解读是:Titans 的在线长期记忆对分布在超长文档中的多事实组合尤其有效。
8.5 Memory depth 的影响
论文比较 $L_M=1,2,3,4$ 的 memory depth。
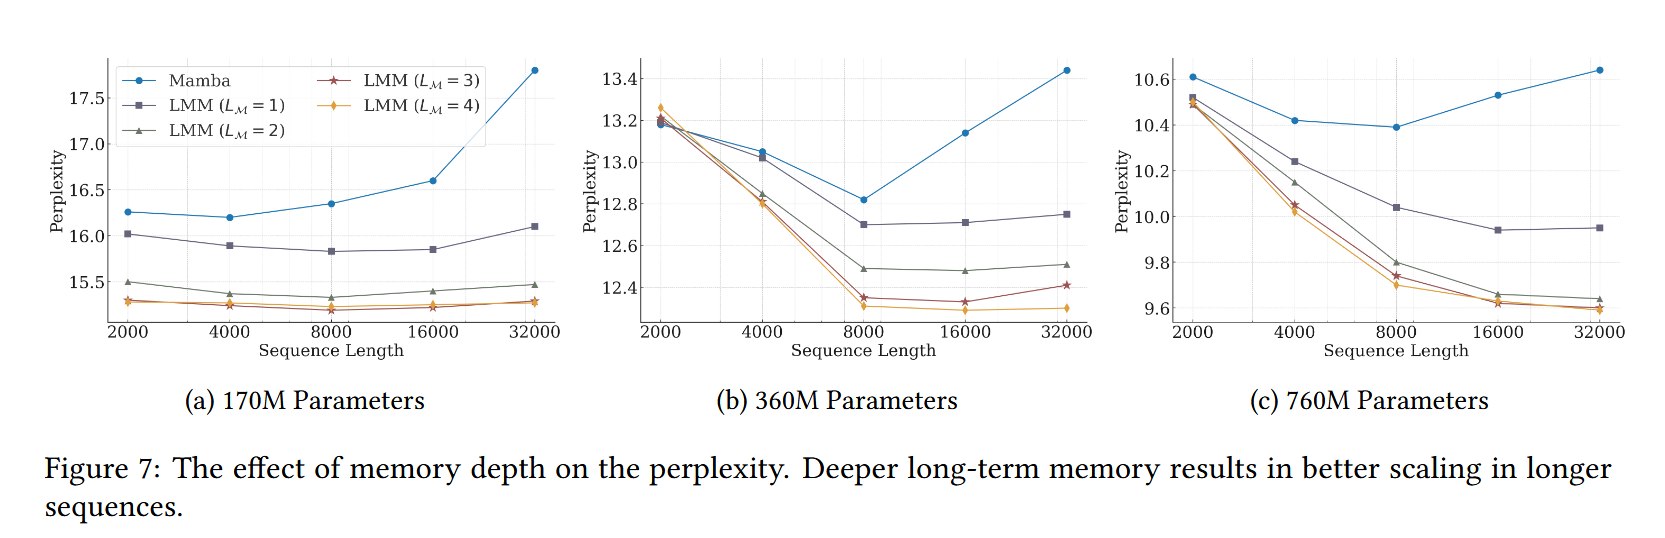
- memory 越深,perplexity 通常越低;
- 在较小模型上,deep memory 对长序列更鲁棒;
- 模型参数增加后,各模型都能更好地处理长序列;
- 深度带来的收益不是只在短上下文有效,而是在长上下文更加明显。
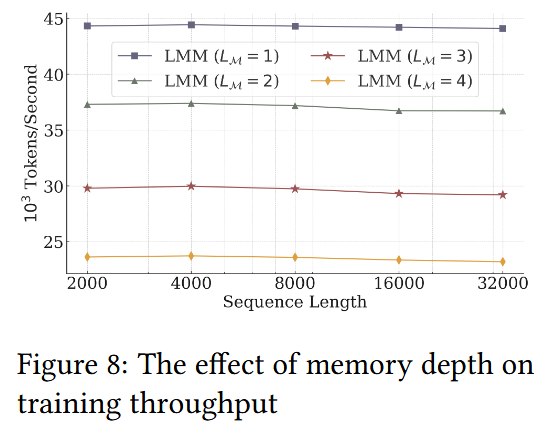
Figure 8 显示训练吞吐:
- 所有模型随着 context length 增长保持线性规模关系;
- memory depth 增加会近似线性降低 tokens/sec;
- 表达能力与训练效率存在明显 trade-off。
结论:
Deep memory 确实提升了记忆能力,但不能免费获得;它直接增加 inner-loop 的计算和 memory update 成本。
8.6 长期时间序列预测
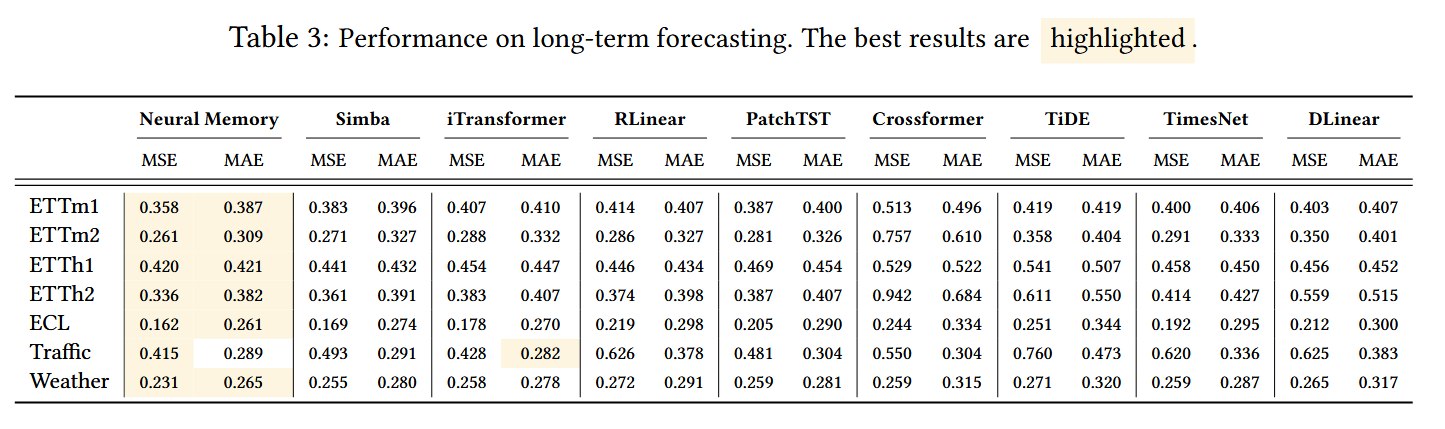
Table 3 在 ETTm1、ETTm2、ETTh1、ETTh2、ECL、Traffic 和 Weather 上比较 MSE/MAE。
论文中的 Neural Memory 在这些数据集上整体优于:
- Simba;
- iTransformer;
- RLinear;
- PatchTST;
- Crossformer;
- TiDE;
- TimesNet;
- DLinear。
代表性结果:
| Dataset | Neural Memory MSE | Neural Memory MAE |
|---|---|---|
| ETTm1 | 0.358 | 0.387 |
| ETTm2 | 0.261 | 0.309 |
| ETTh1 | 0.420 | 0.421 |
| ETTh2 | 0.336 | 0.382 |
| ECL | 0.162 | 0.261 |
| Traffic | 0.415 | 0.289 |
| Weather | 0.231 | 0.265 |
这说明论文提出的 memory mechanism 不完全依赖语言 token 的语义结构,也可能适用于长期趋势与模式记忆。
8.7 DNA modeling
论文在 GenomicsBenchmarks 上使用预训练模型做 downstream classification。
Neural Memory 与 CNN、DNABERT、GPT、HyenaDNA、Transformer++、Mamba、Based 比较。
它在不同任务上具有竞争力:
- Enhancer Cohn:75.2;
- Enhancer Ens:89.6;
- Human Reg.:89.3;
- Non-TATA Promoters:96.6;
- Human OCR Ens:79.9。
它不在每一项都最高,但说明 memory mechanism 可以迁移到非自然语言序列。
8.8 Training efficiency
论文比较不同序列模型的 throughput:
- Neural memory 略慢于 Mamba2 和 Gated DeltaNet;
- 原因是 deep memory 和更复杂的 transition;
- Mamba2 还有高度优化的 kernel;
- Titans MAL 反而可能比若干 baseline 更快;
- 原因是 MAL 使用 FlashAttention 优化的 SWA/full attention。
因此必须区分:
- memory module 单独的速度;
- 完整 Titans architecture 的速度;
- training throughput;
- inference latency;
- 任务效果。
Titans 并不是每个维度都胜出。
8.9 组件消融
Table 5 以 LMM 为基线,依次移除组件:
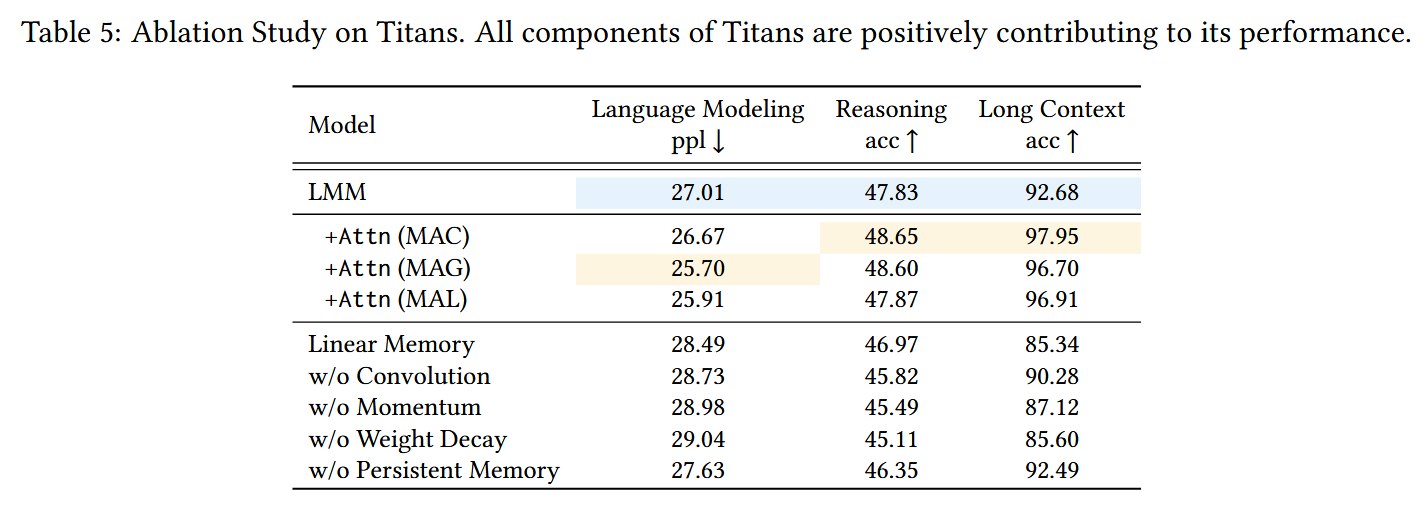
逐项解读:
- Attention:改善局部精确建模和短期信息处理;
- Deep memory:比 linear memory 更强;
- Convolution:提供局部混合,贡献中等;
- Momentum:让 surprise 跨 token 传播;
- Weight decay:对长期容量管理尤其重要;
- Persistent memory:提供任务级、输入无关的先验。
论文认为最大贡献来自 weight decay、momentum、convolution 和 persistent memory,但具体贡献大小仍依赖任务。
8.10 架构消融:MAC、MAG、MAL
论文观察:
- MAC 与 MAG 在语言建模和 common-sense reasoning 上比较接近;
- MAC 在长依赖和 NIAH 上通常更强;
- MAC、MAG 都优于 MAL;
- MAL 虽然结构简单、吞吐较好,但其串行组合限制了两个模块之间的信息交互。
这说明架构设计本身十分重要:
即使使用完全相同的 neural memory 和 attention,放置方式不同也会改变长期记忆效果。
九、总结
9.1 实验结论
- 长期记忆不一定只能是一个 vector/matrix state。 一个小型 deep network 可以作为更 expressive 的 memory。
- Memory update 的质量与 memory structure 同样重要。 surprise、momentum 和 forgetting 共同决定什么被记住。
- Weight decay 可以充当可学习的忘记机制。 它是解决长期容量管理的关键组件之一。
- Momentum 的作用不仅是优化加速。 在 Titans 中它是 surprise 的 temporal memory。
- 短期 attention 与长期 neural memory 具有互补性。 Hybrid Titans 通常优于单独 LMM。
- MAC、MAG、MAL 的差异说明组合方式很重要。 “把两个模块顺序堆起来”不是唯一或最优方案。
- Titans 在 NIAH/BABILong 上展现出较强有效上下文能力。 它不是单纯接受更长输入,而是能够使用长历史。
- Deep memory 的效果可以跨任务迁移。 时间序列和 DNA 实验支持这一点。
9.2 局限性与未来方向
Deep memory 的计算成本
MLP memory 越深,表达力越强,但:
- 每次 inner update 更昂贵;
- 需要保存或重算更多中间激活;
- memory bandwidth 和 kernel fusion 更难优化;
- throughput 下降。
未来需要设计专门的硬件友好 deep memory。
Memory capacity 仍然有限
Weight decay 可以缓解容量溢出,但不是无限存储。实际表现取决于:
- memory 参数量;
- key/value 投影;
- forget rate;
- surprise 的尺度;
- sequence distribution;
- 是否有 attention 协助筛选。
Surprise metric 不是唯一合理定义
论文用 loss gradient 作为 surprise,但这只是一个可行定义。未来可以探索:
- Fisher information;
- prediction uncertainty;
- novelty detection;
- token-level information gain;
- 与任务目标直接相关的 surprise;
- 分层或多尺度 surprise。
长上下文的训练公平性
在不同模型之间比较长上下文,需要严格控制:
- 训练 token 数;
- context length;
- tokenizer;
- 参数量;
- 预训练或 fine-tuning 方式;
- inference kernel;
- memory state size。
Titans 的结果很有吸引力,但需要更多统一协议的大模型复现。
架构组合仍有较大搜索空间
MAC、MAG、MAL 只是三种原型。还可以研究:
- 多层 attention 与 memory 的交错;
- 不同时间尺度的多个 neural memory;
- memory-to-memory communication;
- 动态选择 MAC/MAG/MAL;
- memory read 与 write 的不同网络;
- retrieval-augmented neural memory。
Persistent memory 的角色尚未完全分离
Persistent memory 同时可能承担:
- 任务知识;
- position bias 修正;
- 类似 FFN 的静态 key-value 表;
- 初始上下文提示。
需要更细致的实验来区分这些功能。
说些什么吧!