
零、写在前面
LiveMem 选择把 memory 做成 backbone 的一个旁路,然后里面有一个 GDN2 side 来做记忆的维护。然后对这个模块做 SFT + RL,来获得某种经验性记忆的技能?然后 GDN2 又能做 TTT,但是效果确实也一般。
一、标题
代码:https://github.com/cafeii/LiveMem
模型:https://huggingface.co/chen-l/LiveMem-RL
数据集:见代码仓中数据下载脚本
LiveMem: Maintaining Memory State Continuity in Long-Running LLM Inference
即,在长周期 LLM 推理中保持记忆状态连续性。
论文关注的不是“如何把某段历史重新检索出来”这一单一问题,而是:
当一个长生命周期系统不断更换工作上下文时,模型内部的计算状态能否跨越上下文边界连续传递?
作者将这种能力命名为 state continuity under context turnover,即“上下文更替下的状态连续性”。
二、 背景
2.1 长周期 Agent 的上下文问题
传统 LLM 通常接收一个输入、生成一个输出,任务完成后推理结束。但长期运行的 assistant 或 agent 会持续经历:
- 多轮对话;
- 工具调用;
- 环境反馈;
- 多个任务之间的切换;
- 很长的 reasoning 或执行轨迹。
因此,生命周期累计 token 数可以远超模型的 context window。工作上下文必然要被压缩、替换、淘汰或迁移。
标准 attention-only decoder 可以抽象为:
$$ y_t\sim p_\theta(y_t\mid C_t), \tag{1} $$其中 $C_t$ 是当前位置可见的 attention context。对 Transformer 来说,$C_t$ 主要由 KV cache 表示;当历史 token 超出窗口并被丢弃后,它们对后续预测的直接影响也随之消失。
2.2 现有方案解决的是 historical access,而非 state continuity
现有长上下文和 Agent memory 方法大体可以分为两类。
外部文本或检索式记忆
RAG、MemGPT、MemoryBank、Mem0、A-Mem、MemOS 等方法把历史保存为文本、向量、结构化记录或 memory object,再在需要时检索并重新放入当前上下文。
这类方法擅长 historical access:给定当前 query,系统选择过去的某些记录重新提供给模型。它们像一个持久化的 notebook 或外部数据库。
但它们通常存在两个特点:
- 检索是 query-driven 的,模型主要根据当前问题决定读什么;
- 历史只有在被重新取回并放入当前计算时,才重新影响模型。
内生或潜在状态记忆
另一条路线直接把历史信息写入模型内部状态,例如:
- Recurrent Memory Transformer 的 memory tokens;
- Infini-attention 的 compressive memory;
- MemoryLLM、M+、Larimar 的 latent/episodic memory;
- Test-Time Training、Titans、Nested Learning 的可更新状态;
- δ-Mem 的 associative side state。
这些方法更接近 LiveMem 的目标,但仍有一个关键验证问题:如果历史证据始终对主 attention 可见,模型可能学会直接使用 attention,而不是写入和读取 memory state。因此,仅仅在模型中放置一个名为 memory 的 tensor,并不能证明它具有真正的记忆功能。
2.3 Reconstructive inference 与 continual inference
论文用两个形式区分两种推理范式。
Reconstructive inference
**当旧上下文离开窗口后,系统从外部显式记录中检索一部分历史,重新构造模型的工作状态。**这是 RAG、文本 memory 和很多 KV retrieval 方法的共同抽象。
Continual inference with an accompanying memory state
令 $M_t$ 为模型处理到时间 $t$ 后的 memory state:
$$ M_{t+1}=U_\phi(M_t,X_{t+1}), \tag{2} $$$$ y_t\sim p_{\theta,\phi}(y_t\mid C_t,M_t). \tag{3} $$这里:
- $C_t$ 提供近期信息的高精度访问;
- $M_t$ 提供容量固定的历史压缩状态;
- $U_\phi$ 是在线运行的、可学习的状态转移。
它不要求逐 token 无损重建历史,而要求计算和有用信息能跨多个工作上下文持续演化。
2.4 Living memory state 的三个必要条件
论文给出了一个非常有用的操作性标准。一个 recurrent state 只有同时满足以下条件,才可以被称为 living memory state:
- Online update:随输入 token 持续更新;
- Cross-context persistence:上下文切换、KV 更替后仍然存在;
- Behavioral influence:其中的信息能影响后续决策。
第三条是最关键的。论文因此把测试重点放在:支持性证据已经完全被移出当前 attention window 后,模型还能否回答问题。
2.5 LiveMem 的动机
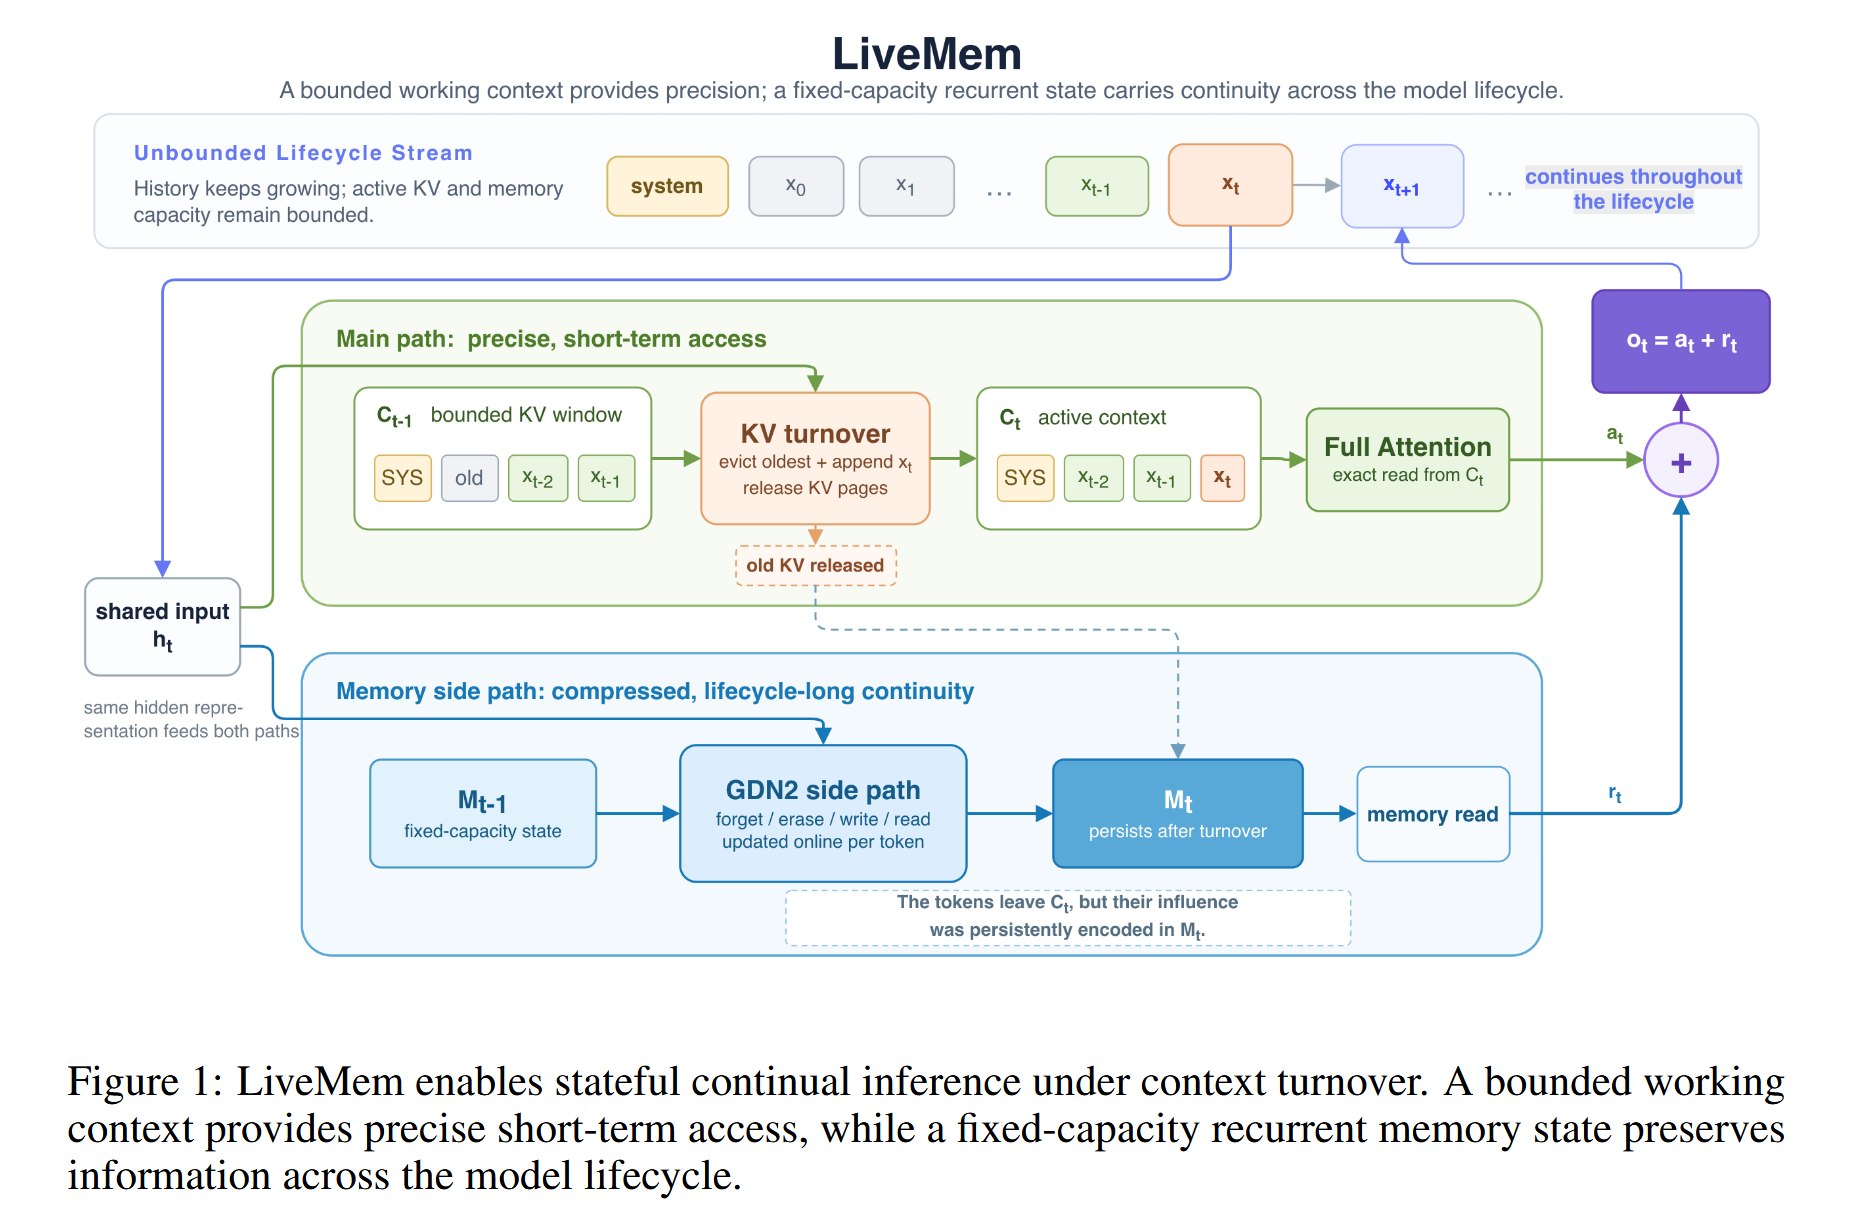
LiveMem 的设计逻辑可以写成:
$$ \text{Full attention} \xrightarrow{\text{KV 随长度增长}} \text{Bounded attention} \xrightarrow{\text{历史被丢失}} \text{Recurrent state} \xrightarrow{\text{可能被绕过}} \text{Turnover-aware post-training}. $$主路径保留短期精确能力,memory branch 负责长期状态连续性;context turnover 则故意制造“必须使用 memory”的训练条件。
三、方法
3.1 总体架构:主 attention + GDN2 side path
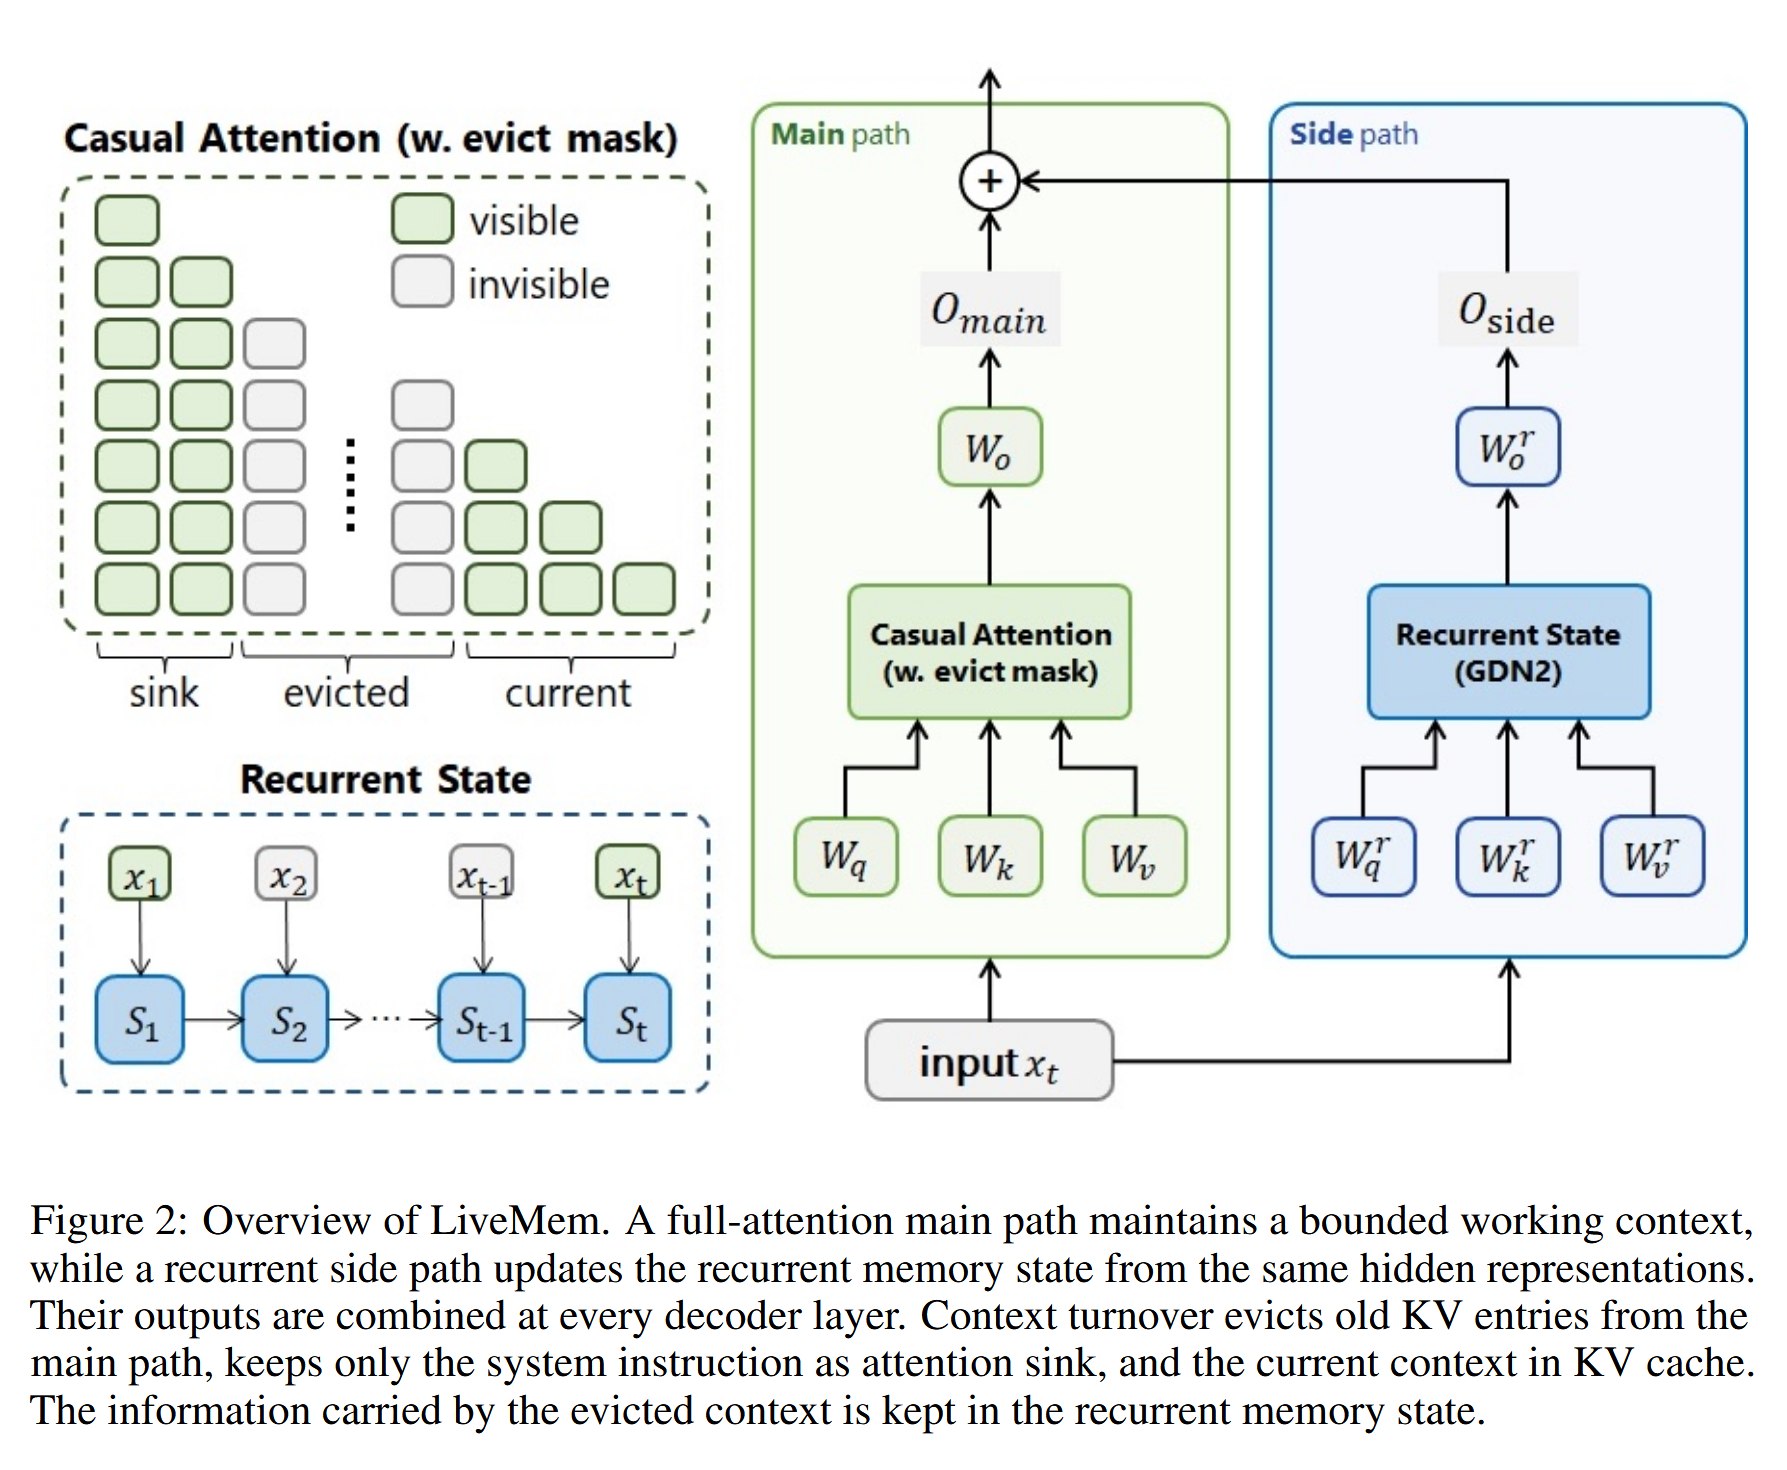
LiveMem 不替换原来的 Transformer attention,而是在每一个 attention layer 增加并行侧分支。
对第 $ell$ 层,令 $h_t^\ell$ 是归一化后的当前 hidden representation,$S_t^\ell$ 是该层的 recurrent memory state:
$$ a_t^\ell=\operatorname{Attn}_\ell(h_{\leq t}^\ell;C_t), \tag{4} $$$$ (r_t^\ell,S_t^\ell)=\operatorname{GDN2}_\ell(h_t^\ell,S_{t-1}^\ell), \tag{5} $$$$ o_t^\ell=a_t^\ell+r_t^\ell. \tag{6} $$其中:
- $a_t^\ell$:主 attention 对当前有限窗口的精确读取;
- $r_t^\ell$:memory branch 从 recurrent state 产生的读取结果;
- $S_t^\ell$:跨 token、跨 chunk、跨上下文 turnover 持续存在的状态。
这种加法融合的好处是:初始时可以保留原始模型行为,memory branch 在 post-training 中逐步学会发挥作用。
3.2 GDN2 的单头状态更新
对一个 recurrent head,令:
- $S_t\in\mathbb{R}^{d_k\times d_v}$:矩阵状态;
- $q_t,k_t\in\mathbb{R}^{d_k}$:query、key;
- $v_t\in\mathbb{R}^{d_v}$:value;
- $g_t\leq 0$:log-decay;
- $b_t\in[0,1]^{d_k}$:erase gate;
- $w_t\in[0,1]^{d_v}$:write gate。
GDN2 分为四个可解释步骤。
Step 1:forget
$$ \bar S_t=\operatorname{Diag}(\exp(g_t))S_{t-1}. \tag{7} $$这是按 key/channel 方向对旧状态衰减。由于 $g_t\leq0$,$exp(g_t)$ 位于 $(0,1]$ 范围。
Step 2:erase and prepare
$$ \rho_t=w_t\odot v_t-\bar S_t^\top(b_t\odot k_t). \tag{8} $$第二项读取旧状态在被选中 key 方向上的内容,并从待写入的 value 中扣除它;因此它不仅是简单写入,还能先擦除冲突的旧关联。
Step 3:write
$$ S_t=\bar S_t+k_t\rho_t^\top. \tag{9a} $$这是一个 rank-1 更新,将修正后的 value 沿 key 方向写回状态。
Step 4:read
$$ r_t=S_t^\top q_t. \tag{9b} $$于是 GDN2 同时实现了:forget、selective erase、write 和 read。与只使用一个 recurrent state 相比,GDN2 将“遗忘旧信息”和“写入新信息”拆成更细的控制信号。
论文在附录 C 中给出等价形式:
$$ S_t=\left(I-k_t(b_t\odot k_t)^\top\right) \operatorname{Diag}(\exp(g_t))S_{t-1} +k_t(w_t\odot v_t)^\top. \tag{15} $$3.3 参数初始化与稳定训练
LiveMem 采用以下初始化策略:
- memory branch 的 $q,k,v$ projection 从 backbone 对应 attention projection 初始化;
- decay、erase、write、output gate 和 short convolution 参数独立随机初始化;
- memory branch 最终输出 projection 初始化为全零。
因此,训练开始时 side branch 输出为 0,整个模型近似等价于原始 pretrained backbone;随着 post-training,side branch 逐渐被打开。这比随机加入一个强输出的 recurrent branch 更稳定。
附录 C 的具体实现还包括:
- GDN2 的 $q,k$ 在 recurrent kernel 内做 $ell_2$ normalization;
- q/k/v projection 前使用 width-4 causal short convolution;
- readout $S_t^\top q_t$ 经过 gated RMSNorm 和 output projection;
- Qwen3-4B backbone 有 36 layers、32 query heads、8 KV heads、head dimension 128;
- memory path 在每一层使用 32 个 query/key/value heads,每个 head dimension 为 128;
- 每个 request、每一层的 recurrent matrix state 形状为 $32\times128\times128$,状态使用 FP32。
仅计算 matrix state,单 request 的状态规模约为:
$$ 36\times32\times128\times128\times4\text{ bytes} \approx75.5\text{ MB}\approx72\text{ MiB}, $$这还不包括 short-convolution state 和其他运行时开销。这个数字说明 LiveMem 降低的是随历史长度线性增长的 KV cache,而不是让 memory state 完全免费。
3.4 Context turnover:让旧 KV 真正离开主路径
LiveMem 将输入划分为有序 chunks:
$$ X_0,X_1,X_2,\ldots. $$系统 prompt 永久保留,作为 attention sink;其他 chunk 放进一个 bounded FIFO queue。新 chunk 到达后,如果 chunk 数量或 live-token budget 超限,就从最旧端驱逐 chunk。
主 attention 的可见性定义为:
$$ \operatorname{visible}(i,j) =\mathbf{1}[i\leq j] \mathbf{1}[\operatorname{in\_mem}(\operatorname{chunk}(i),j)]. \tag{10} $$含义是:token $i$ 必须因果可见,并且它所在的 chunk 在当前位置 $j$ 仍处于 live window。
最重要的设计点是:
- 公式(10)只限制主 attention;
- GDN2 仍然扫描完整输入序列的每个 token;
- 被驱逐 chunk 的 KV 对主 attention 不再可见,但它已经影响了 recurrent state;
- 训练时用 dynamic attention mask;
- serving 时真正释放被驱逐 KV pages。
因此,训练与推理必须使用同样的 turnover 语义,否则训练时模型可能依赖推理时不存在的历史 KV,memory state 就会失效。
3.5 Memory-oriented post-training
仅增加 side branch 不足以让模型学会依赖它。若训练时所有历史都直接可见,模型会走捷径:只使用 full attention,不向 recurrent state 写入有用信息。
LiveMem 的训练样本包含:
- 一段历史 memory text;
- 一个或多个 query;
- 参考答案。
训练过程中强制执行 turnover,使 query 到来时,大部分历史已经被移出主 attention。
3.5.1 Answer-based SFT
历史、query、answer 拼成一个 causal stream,但交叉熵只作用于 answer token 集合 $A$:
$$ \mathcal{L}_{\mathrm{SFT}} =-\frac1{|A|}\sum_{t\in A} \log p_{\theta,\phi}(x_t\mid C_t,S_t). \tag{11} $$训练过程分两步:
- 先使用 long-document QA,激活并冷启动 memory branch;
- 再混合 QA、classification、multiple-query 等数据,训练记忆维护和读取。
默认训练完整 memory branch,backbone 参数冻结;论文同时消融了 side-path LoRA 和部分解冻主路径。
3.5.2 Memory-oriented RL
RL 阶段使用 GRPO,并采用 DAPO 风格技巧:
- clip-higher;
- token-level loss;
- dynamic sampling;
- 移除 KL penalty。
每个 prompt 采样 $G=8$ 个 responses,并用 group normalization 计算 advantage:
$$ \hat A_i=\frac{R_i-\mu_R}{\sigma_R}, \qquad \mu_R=\frac1G\sum_{j=1}^{G}R_j. \tag{12} $$概率比率为:
$$ \rho_{i,t} =\frac{\pi_\theta(o_{i,t}\mid q,o_{i,对包含多个问题的 prompt,令 $n_i$ 为问题数,$k_i$ 为回答正确数:
$$ a_i=\frac{k_i}{n_i}. $$若全部答对,额外奖励 0.5;若格式错误,惩罚 0.5:
$$ R_i=a_i+0.5\mathbf{1}[k_i=n_i]-0.5\mathbf{1}[F_i=0]. \tag{14} $$动态采样只保留 response accuracy 方差大于 0 的 group,避免没有学习信号的样本组。判分优先 exact match,负例再交给 LM judge 判断语义等价。
3.6 Serving 与状态生命周期
LiveMem 的 serving 不是把 memory state 作为全局共享变量,而是按 request 管理:
- ordinary attention manager 只持有 system sink 与近期 live chunks 的 KV pages;
- separate state slot 持有每层的 convolution state 和 GDN2 matrix state;
- turnover 时完整的中间 KV pages 归还 allocator;
- recurrent state slot 不受 KV eviction 影响;
- prefill slice 被限制到下一个 chunk boundary,避免 scheduler 在一个 slice 内提前应用未来的 eviction;
- request 结束后释放 recurrent slot,防止不同 request 之间状态泄漏;
- whole-state reset 是系统操作,和 GDN2 的逐 token decay/erase 不同。
3.6.1 RL serving 的固定步长策略
RL rollout 和训练重算使用相同的 fixed-stride turnover。论文给出的规则为:
| $L_p+M$ 范围 | Chunk size | Live-token budget | 生成上限 $M$ |
|---|---|---|---|
| [1K, 2K) | 64 | 512 | 256 |
| [2K, 8K) | 256 | 1,024 | 512 |
| [8K, 16K) | 512 | 2,048 | 1,024 |
| [16K, 32K) | 512 | 4,096 | 2,048 |
| [32K, 64K) | 512 | 8,192 | 4,096 |
chunk boundary 对齐 32-token serving page;benchmark inference 则使用 chunk size 1,024 和 8K/32K live-token budget 以对应正文评测设置。
四、实验
4.1 问题
- LiveMem 与文本 memory、RAG 和其他 intrinsic memory 相比,综合性能如何?
- 当证据离开 active window 后,recurrent state 是否真的保留了它?距离继续变远时还能保留多久?
- memory branch 应该训练哪些参数,采用什么数据 curriculum?
4.2 评测设置
Backbone 与上下文限制
所有方法使用 Qwen3-4B-Instruct-2507 作为 backbone。
- 常规任务 active context 上限:32K tokens;
- Wiki QA 和 LoCoMo 等较短套件:8K tokens;
- 超过上限的无记忆 baseline 从 memory 文档最老端截断;
- 统一采样:temperature 0.7、top-p 0.8、top-k 20。
对比系统
- Qwen3-4B:直接 full-attention baseline,超窗后 head truncation;
- RAG:Qwen3-Embedding-0.6B 检索相关证据;
- Recurrent:参考 MemAgent,以文本 memory context 进行轮次式摘要和更新;
- Context2LoRA:为每个 memory instance 建立 LoRA 参数记忆;
- δ-Mem:带 side-path state 的 intrinsic memory 方法;
- LiveMem-SFT:只经过 memory-oriented SFT;
- LiveMem-RL:在 SFT 后继续进行 memory-oriented RL。
任务套件
| 套件 | 数据集 | 主要能力 |
|---|---|---|
| Wiki QA | 2WikiMultiHopQA、HotpotQA、MuSiQue | 多跳知识问答;另构造多问题 MQ |
| Conversation QA | LoCoMo、LongMemEval、FactConsolidation | 长期对话记忆 |
| TTL | Banking77、CLINC150、NLU、TREC-coarse/fine、ReDial | 测试时从历史样例归纳模式 |
| Long QA | ∞Bench-QA、EventQA、NarrativeQA | 从超长文本分散证据中回答问题 |
开放式 QA 使用 Qwen3.6-35B-A3B judge 做二值语义判定;分类任务使用 normalized exact match;ReDial 使用 Recall@5。
公平性与 baseline 实现细节
附录 D 还明确了若干容易影响结论的实现细节:
- RAG:少于 20 个 memory documents 时使用 top-1,否则使用 top-3;没有明确文档边界的 Long QA 按 512-token chunk 切分;由于 MQ 需要同时覆盖多条证据,论文不报告 RAG 的 MQ 结果。
- Context2LoRA:每个数据集使用独立 LoRA,rank=4、alpha=8、learning rate $5\times10^{-4}$;TTL 直接用 text-label pairs 训练,因此它在 TTL 上的优势部分来自任务形式与方法假设的匹配。
- Recurrent:memory context 上限为 8K,每轮最多处理约 16K memory text,处理后将完整 memory context 注入下一轮。
- δ-Mem:论文按其 released code 的实际行为评测;超过配置 budget 的历史会直接丢弃,而不是按论文文字描述的理想机制继续处理。
- 输入截断:所有方法都保留 system instruction、task template 和 query;超限时只从 memory prefix 的最老端截断。LiveMem 可以扫描最多 256K 输入,但只维持实验指定的 live KV budget。
- 生成预算:单问题最多生成 1,024 tokens,多问题最多生成 8,192 tokens;多问题样本不会通过删除问题来缩短输入。
4.3 主结果:bounded-context 协议
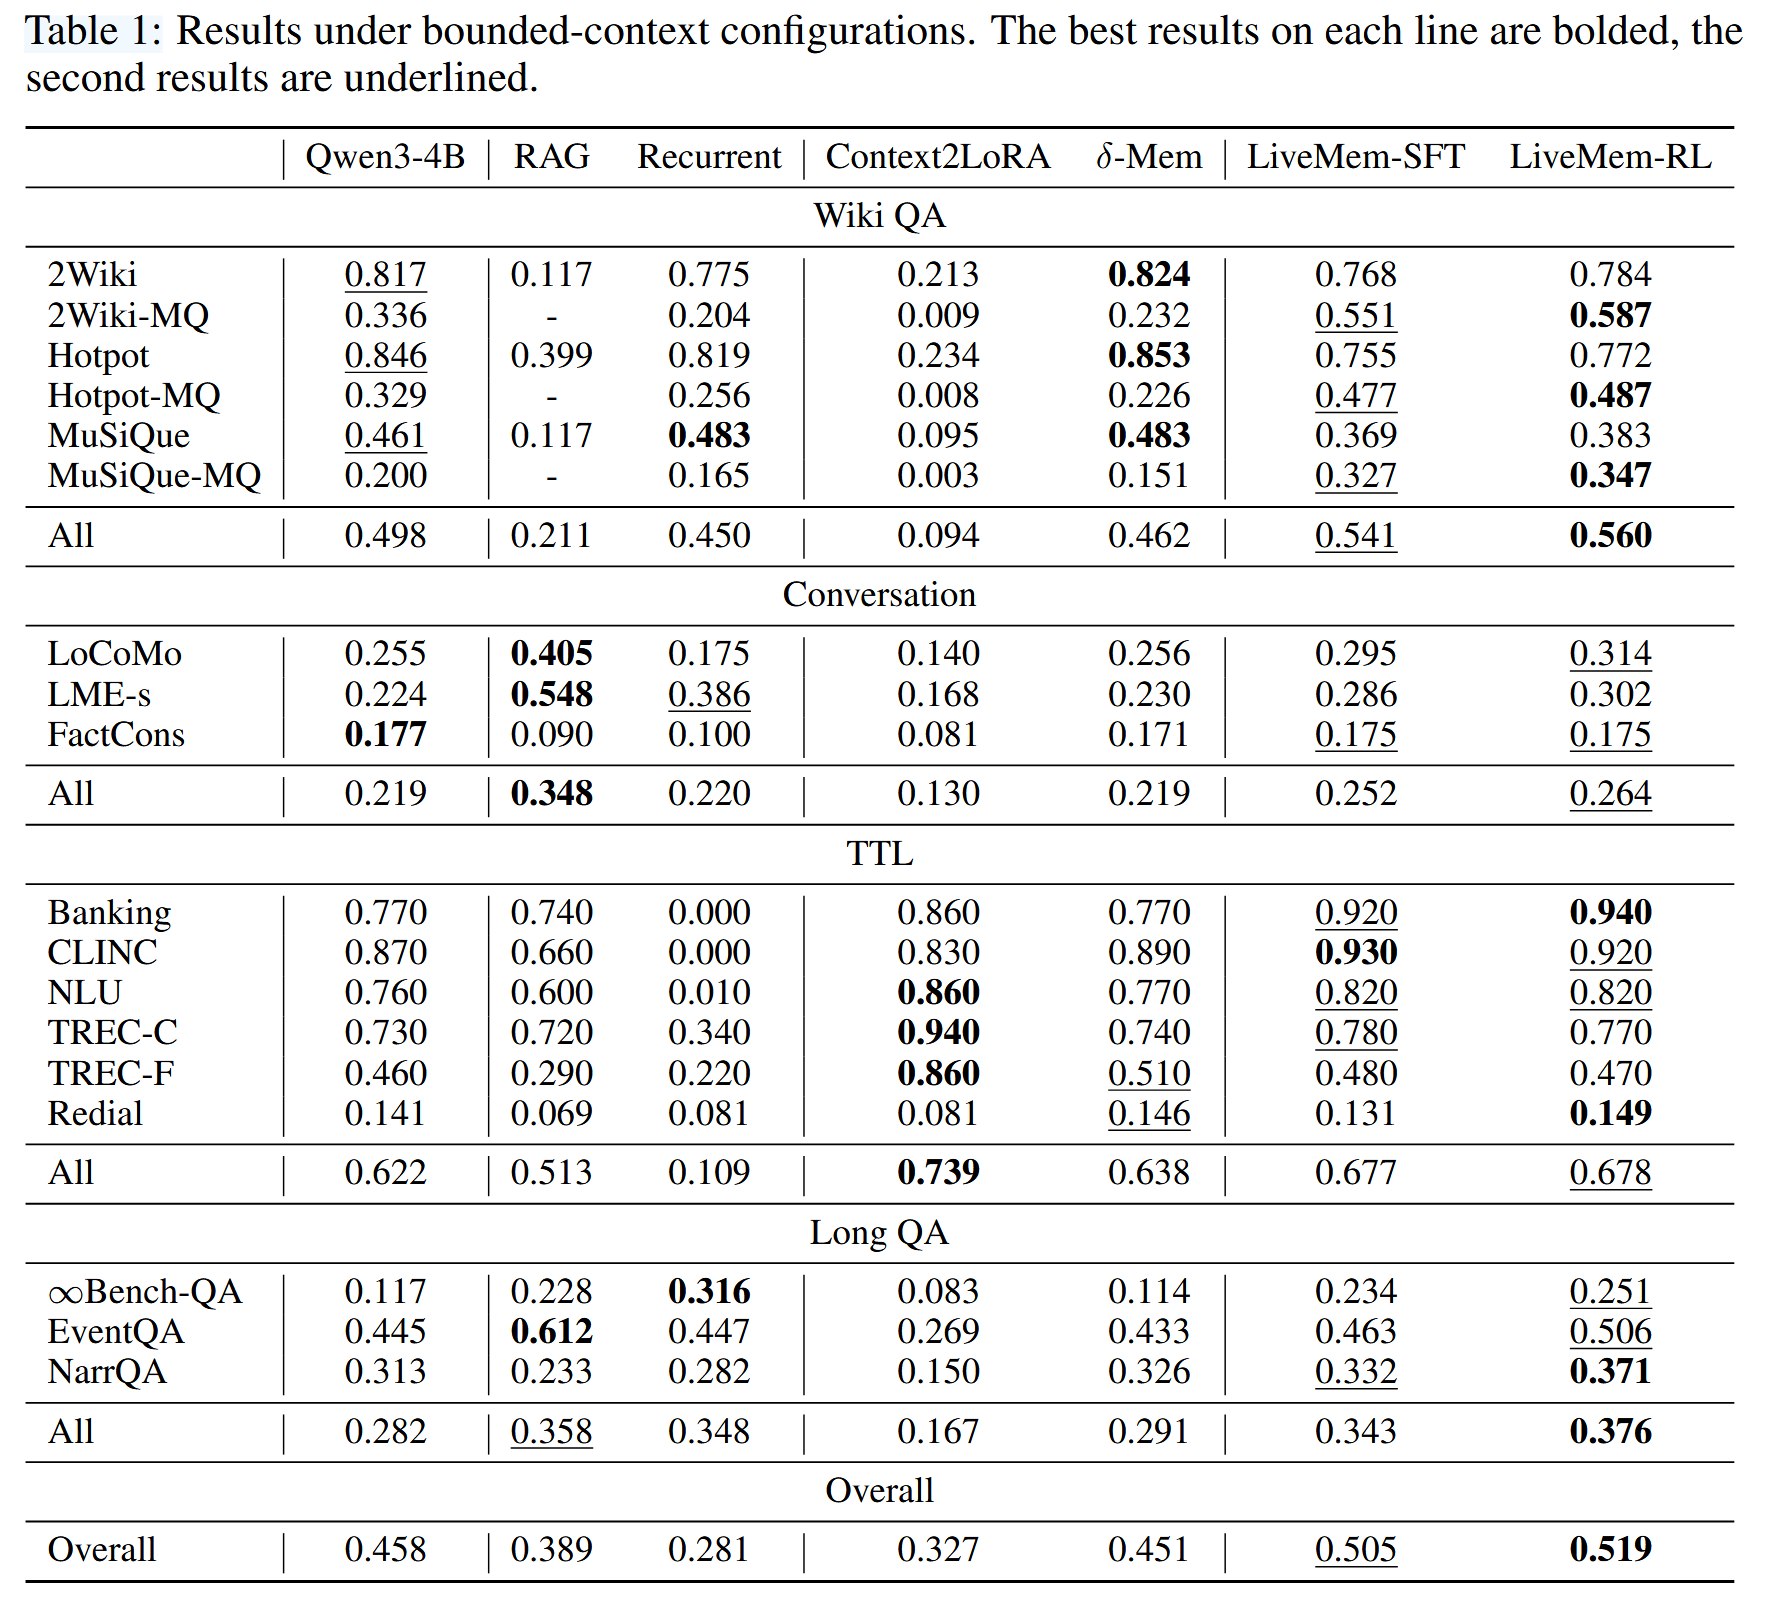
1. Wiki QA:多问题 MQ 是关键。
单问题任务中,原始 Qwen3 和 δ-Mem 已经很强;但将多个独立样本打包成 MQ 后,大多数方法显著下降。LiveMem-RL 在 2Wiki-MQ、Hotpot-MQ、MuSiQue-MQ 上分别达到 0.587、0.487、0.347,说明它更能维护多个并行问题共享的历史信息。
2. RAG 和 Context2LoRA 是强但偏科的 baseline。
RAG 在 Conversation 平均 0.348 最好,Context2LoRA 在 TTL 平均 0.739 最好,但它们在其他套件上明显下降。LiveMem 的优势不是每个子任务都第一,而是跨任务更均衡。
3. Long QA:LiveMem-RL 最高。
LiveMem-RL 的 Long QA 平均为 0.376,高于 Recurrent 的 0.348 和 RAG 的 0.358;它在 ∞Bench-QA、EventQA、NarrativeQA 三项上都保持有竞争力。
4. Overall:LiveMem 的主要卖点是综合性。
LiveMem-RL 的 0.519 高于 LiveMem-SFT 的 0.505、Qwen3 的 0.458 和 δ-Mem 的 0.451。但在 Conversation 和 TTL 上,RAG 或 Context2LoRA 仍然更高。因此论文的结论应表述为“综合表现领先、跨任务更稳健”,而不是“所有任务都领先”。
4.4 被驱逐的证据是否真的进入了 state
论文比较两种设置:
- State:先完整处理历史,让它写入 recurrent state,再在截断窗口上回答;
- Trunc.:只处理当前后缀,recurrent state 从零开始。
$Δ=\text{State}-\text{Trunc.}$。
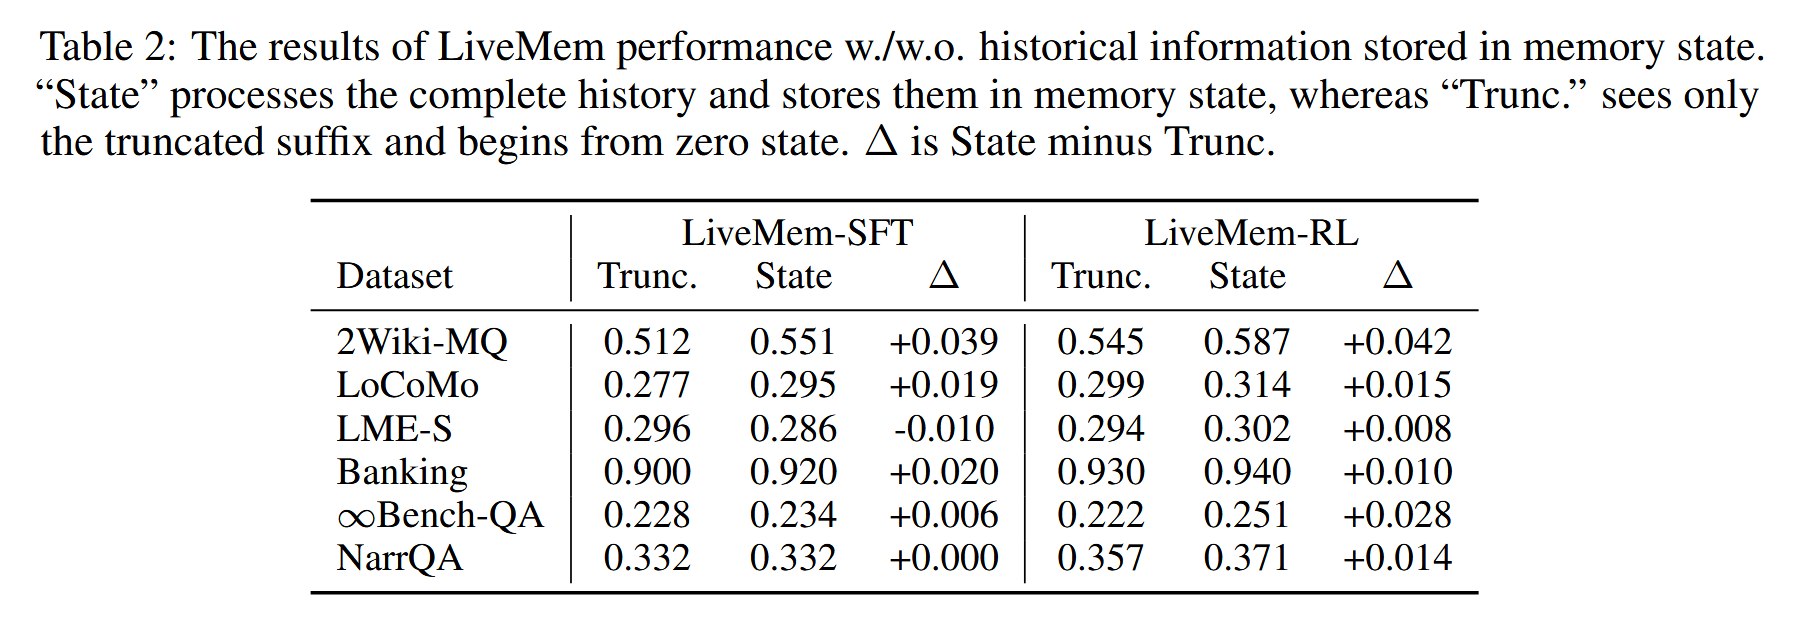
SFT 在 LongMemEval-S 上出现 -0.010 的例外;RL 则在所有报告数据集上是正增益,幅度为 +0.008 到 +0.042。这支持一个重要判断:RL 后模型更会利用历史 state,而不仅是拥有一个 state tensor。
4.5 LongMemEval 的证据移除实验
论文进一步把 LongMemEval-S 划分为:
- Fully evicted:所有关键支持证据都离开 active window;
- Partially evicted:部分关键证据离开 active window。
准确率如下:
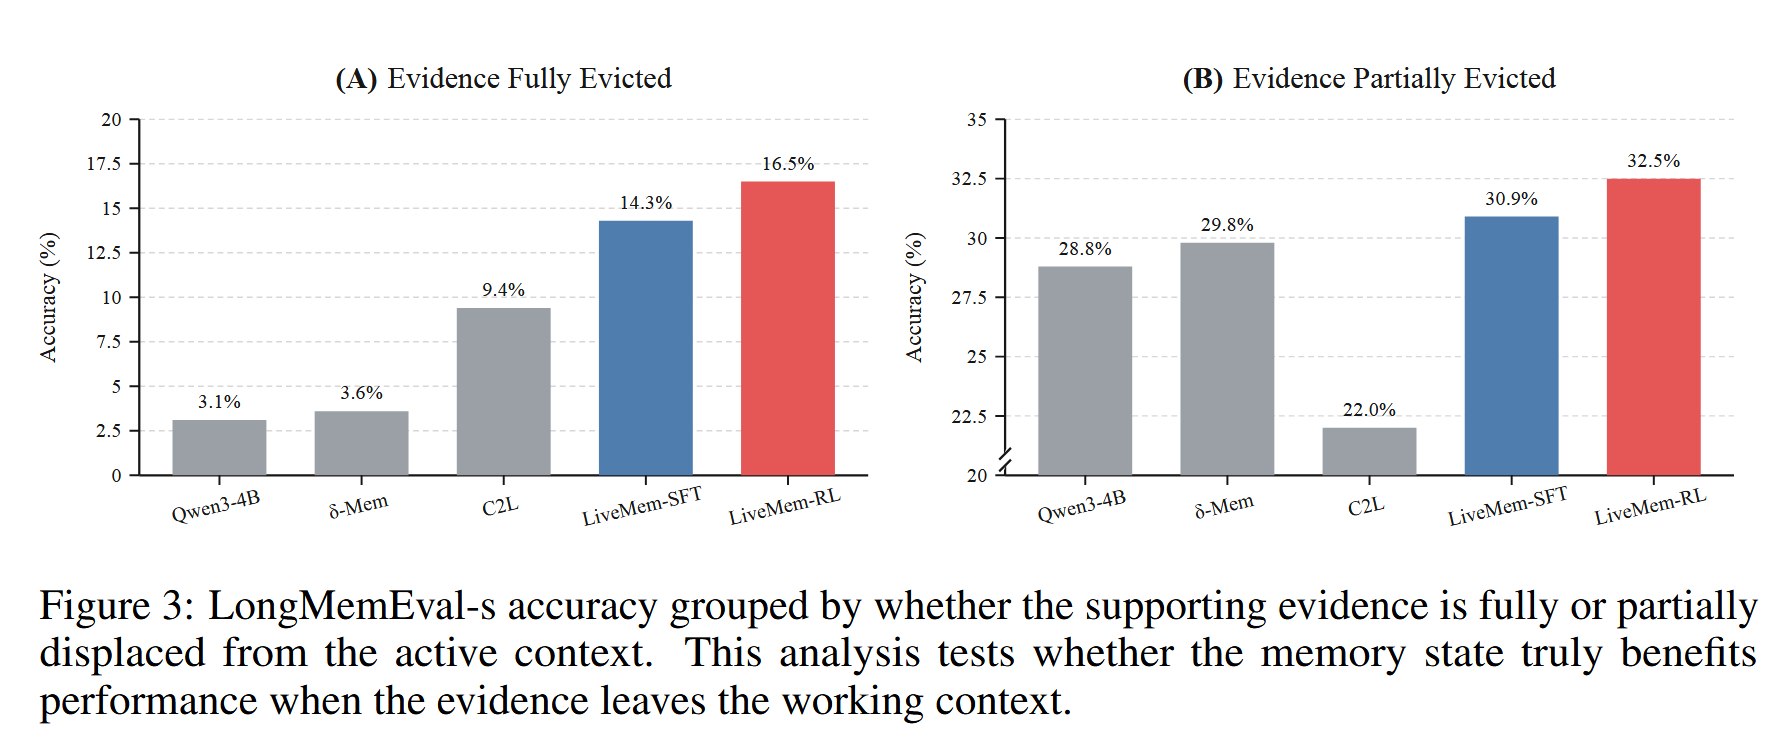
Fully evicted 条件是本文最关键的行为证据:Qwen3 和 δ-Mem 没有可访问的历史,因此准确率接近崩溃;LiveMem 仍能超过它们 10 个百分点以上。但 16.5% 也说明它不是无损记忆,仍有大量问题无法回答。
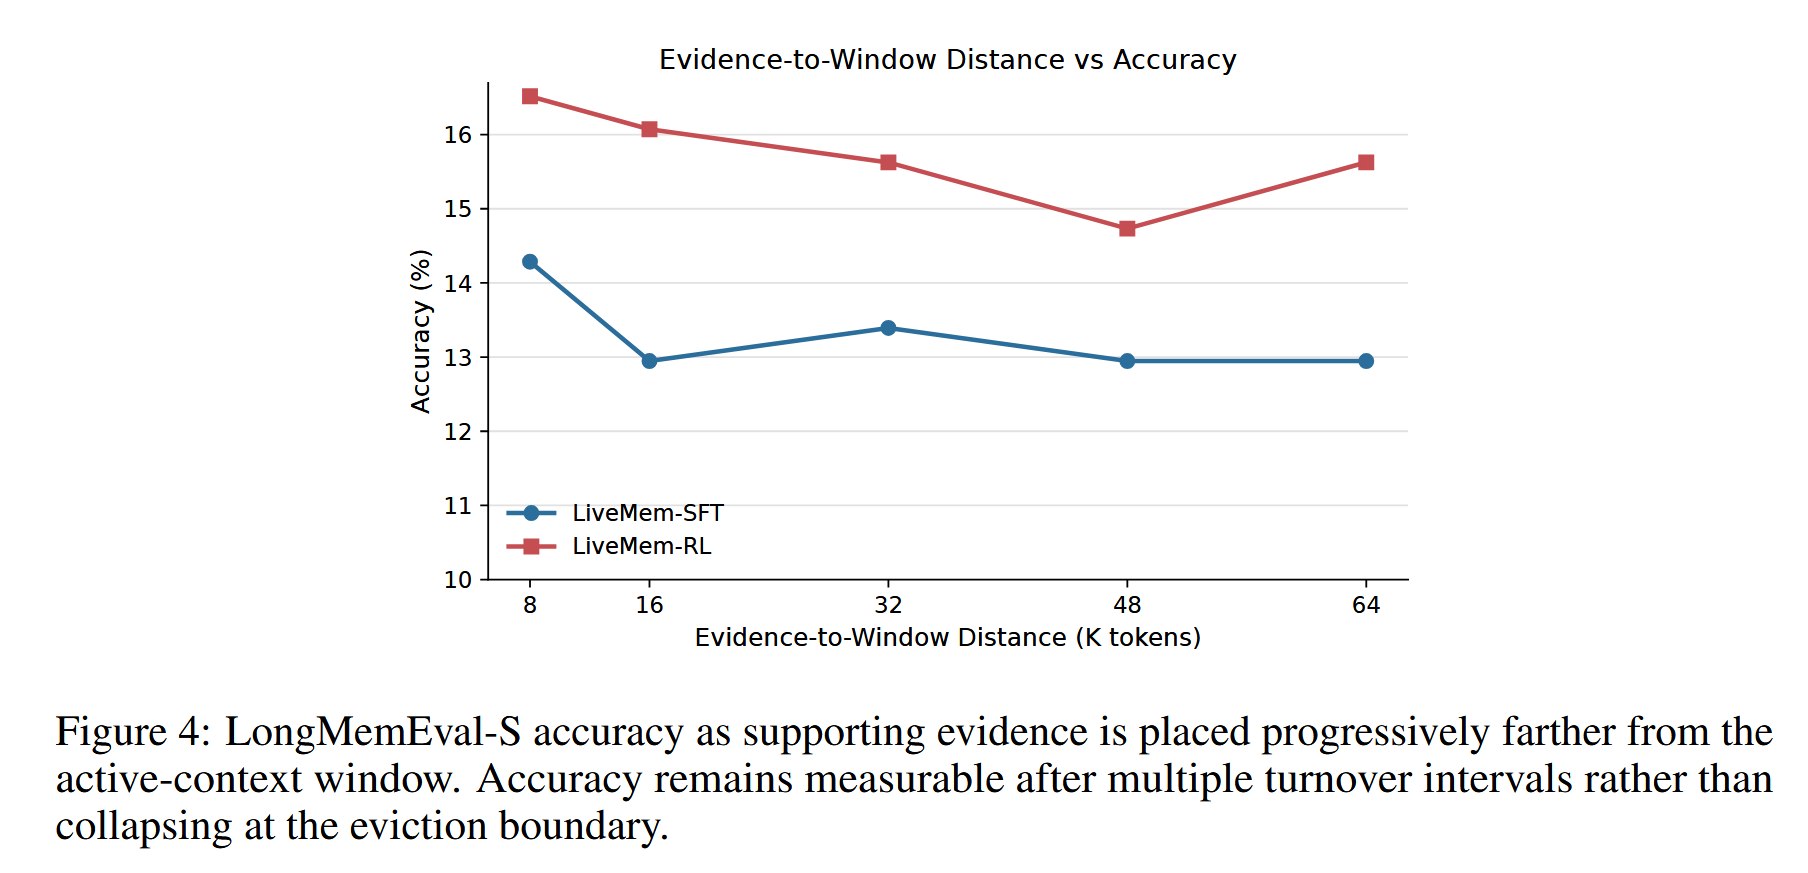
论文还把证据与当前窗口的距离从 8K 增加到 64K。准确率总体缓慢下降,但没有在第一次 eviction 边界出现断崖式下降。这说明 GDN2 的衰减会损失信息,却能让一部分任务相关信息跨越多次 turnover。
4.6 架构和训练消融
4.6.1 可训练参数容量
| 设置 | 2Wiki-MQ | LoCoMo | LME-S | Banking | TREC-F | ∞Bench-QA | EventQA |
|---|---|---|---|---|---|---|---|
| LoRA side | 0.479 | 0.256 | 0.362 | 0.880 | 0.440 | 0.214 | 0.490 |
| Full side | 0.551 | 0.234 | 0.286 | 0.920 | 0.480 | 0.234 | 0.463 |
| Full side + main-path LoRA | 0.520 | 0.220 | 0.280 | 0.910 | 0.540 | 0.236 | 0.412 |
论文默认选择 full side。解释是 attention hidden representation 与 GDN2 dynamics 之间存在分布差异,LoRA 的低维更新空间可能不足以让 side path 充分适配。给主路径增加 LoRA 也没有稳定收益,甚至可能让主路径学会吸收本应由 memory branch 承担的信息。
4.6.2 数据混合与 curriculum
| 训练课程 | 2Wiki-MQ | LoCoMo | LME-S | Banking | TREC-F | ∞Bench-QA | EventQA |
|---|---|---|---|---|---|---|---|
| Direct mixture | 0.439 | 0.261 | 0.298 | 0.740 | 0.420 | 0.222 | 0.448 |
| Rebalanced mixture | 0.452 | 0.263 | 0.326 | 0.770 | 0.260 | 0.208 | 0.412 |
| Long warmup + rebalanced | 0.479 | 0.256 | 0.362 | 0.880 | 0.440 | 0.214 | 0.490 |
两阶段 curriculum 最好:
- 先用 long-form QA warm up,激活 side path;
- 再用 rebalanced mixture 强化记忆维护和多任务能力。
直接混合时,长文本数据的召回要求可能不够强,模型没有动力学习 memory state;只使用 rebalanced data 又可能数据量不足,导致 side path 没被充分激活。
4.7 NIAH实验
论文没有回避 LiveMem 的失败场景,而是用 RULER 的 Needle-in-a-haystack 测试检查固定状态能否恢复任意随机字符串。
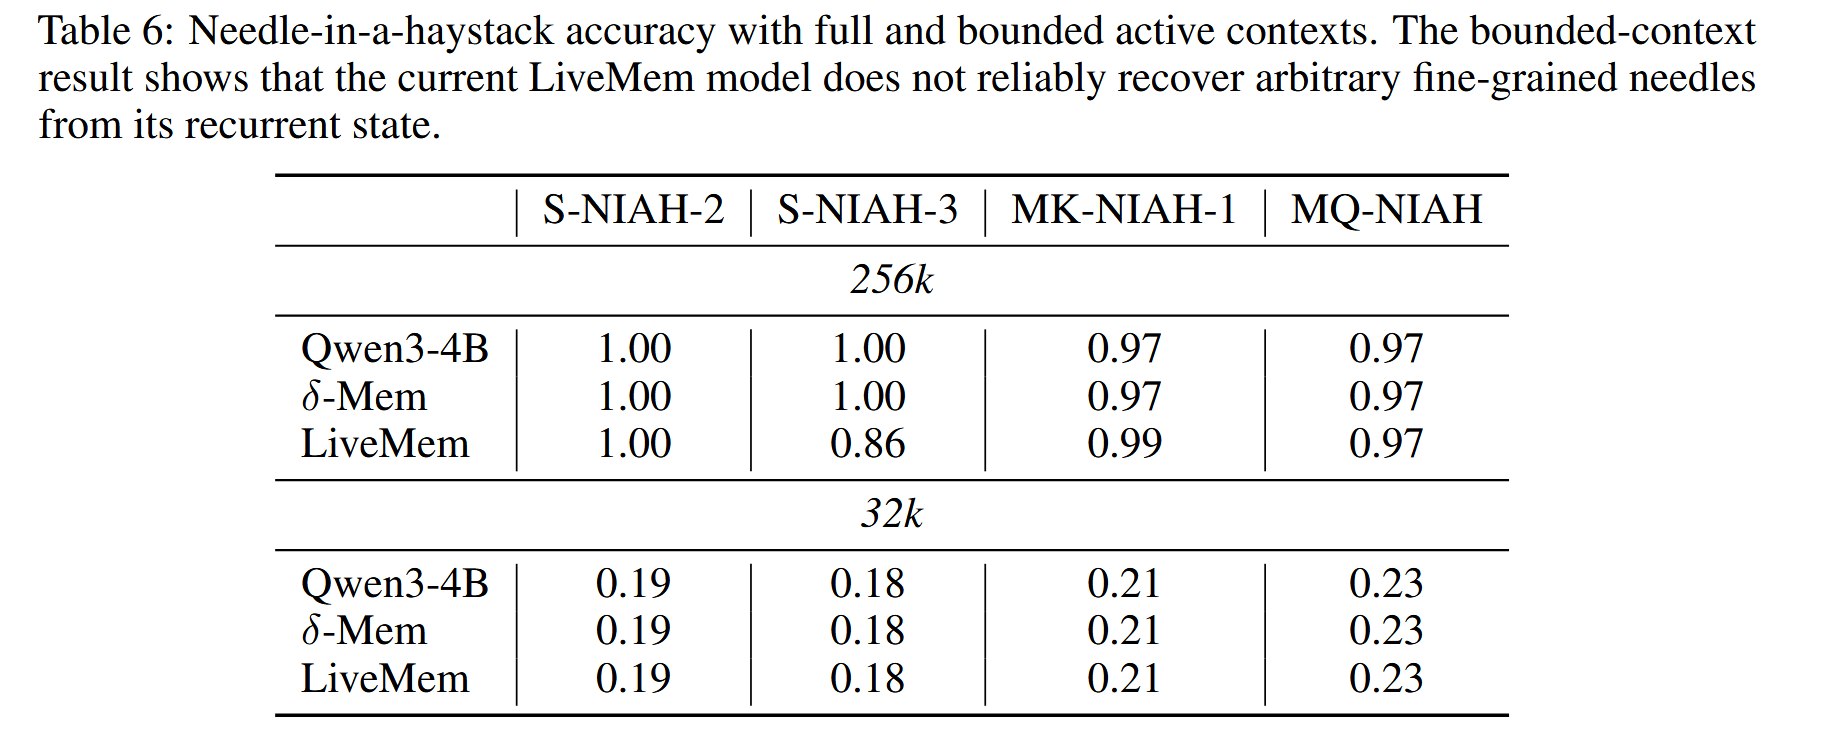
结论非常明确:
- 256K 全量物化时,needle 仍在 attention 中,所有方法大致接近上限;
- 32K bounded context 下,needle 离开 KV 后,LiveMem 与 baseline 一样低;
- 当前 LiveMem 的 state 不能可靠地无损重建任意 token-level needle。
因此,LiveMem 适合承载有用的语义、任务线索和生命周期状态,不适合代替外部数据库做 exact archival recall。需要字面精确回忆时,应与 RAG、外部 store 或 query-aware KV retention 组合。
五、总结
5.1 理解
1、LiveMem 记住的是行为相关状态,不是所有原文
GDN2 state 是固定大小的矩阵。输入流越长,单位 token 能写入的空间相对越少,因此它必然是有损压缩。
它更适合保留:
- 用户长期偏好;
- 已建立的任务状态;
- 多轮交互形成的语义关联;
- 对后续决策有帮助的类别、规则和线索;
- 多个问题共享的背景信息。
它不适合保证:
- 任意未来 query 需要的随机字符串;
- 每个历史 token 的逐字重建;
- 无限长度下的无损文档归档。
2、为什么 MQ 任务对 LiveMem 更友好
MQ 任务把多个问题打包到同一历史中,要求模型先压缩共享背景,再同时回答多个 query。纯 RAG 的 top-k 选择可能无法覆盖所有问题所需证据,文本 recurrent baseline 的摘要也可能丢失细节。
LiveMem 的 state 在处理历史时不依赖最终 query,可以持续写入多个相关线索;当多个问题共享同一背景时,固定 state 的压缩反而能发挥优势。
3、为什么 context turnover 必须进入训练
如果训练时历史全部留在 attention 中,存在 shortcut:
$$ \text{看到原文} \Rightarrow \text{直接 attention} \Rightarrow \text{不写 memory}. $$LiveMem 在训练时把旧 chunk 从主 attention mask 中移除,迫使模型优化:
$$ \text{history} \xrightarrow{\text{GDN2 update}} \text{state} \xrightarrow{\text{memory read}} \text{answer}. $$这也是论文中“training-inference consistency”比单纯增加一个 memory module 更重要的原因。
4、LiveMem 与 RAG 是互补而非替代
两者处理的时间尺度不同:
| 机制 | 主要问题 | 优势 | 弱点 |
|---|---|---|---|
| RAG / external memory | 现在应该重新读取哪段历史? | 可寻址、可解释、适合 exact recall | 依赖索引、query 和外部系统 |
| LiveMem state | 历史处理过后,模型状态如何连续? | 在线、固定容量、query-independent | 有损、难以精确还原任意 token |
实际系统可以让 RAG 负责稀疏精确证据,让 LiveMem 负责持续的用户模型、任务状态和全局语义背景。
5.2 Limitation
1、State 的资源成本
一个比较明显的问题就是 gdn2 分支会导致参数显著增大的风险,backbone 是 4b,引入的 gdn2 就有 3b 了,而且在一些场景上的表现有限。
2、“无限上下文”在当前实现中并非字面意义上的无限
memory state 和 live KV budget 不随已处理 token 总数增长,但 Qwen3 backbone 使用 RoPE,配置的最大 position 约为 262,144。KV eviction 保留原始绝对 position,超过训练和配置范围后,位置外推质量没有保证。
不过现在 KIMI K3 走的是 Linear Attention + NOPE 路线,把位置编码拿掉了,说不定未来会有一些别的可能性。
说些什么吧!