
零、写在前面
这篇主要就是提出一个框架吧,把传统 RNN 的隐状态替换成一个在线学习的模型,这个模型可以作为一个插件模块,不一定是MLP,可以换成其他更强的内部model,加上更好的优化器,算是后续一些工作的起点。
一、标题
来源:ICML 2025
Learning to (Learn at Test Time):
- 外循环训练一个网络,使它学会如何设计和使用内循环;
- 网络在处理每个新序列时,仍然利用序列中的 token 做一次小规模学习。
因此,TTT 不是在测试时把整个 LLM 重新 fine-tune 一遍,而是把一个轻量的学习过程写进序列建模层的状态转移中。
副标题 RNNs with Expressive Hidden States 指出论文真正想改变的是 RNN 的隐状态。传统 RNN 的状态通常是向量,Mamba 等现代 RNN 也往往使用结构化的固定大小状态;TTT 则让隐状态成为一个模型的参数,例如线性模型或两层 MLP 的权重。
本文概括就是:
TTT 把“历史上下文”压缩成一个会在当前序列上继续训练的小模型,使 RNN 的固定大小状态拥有比普通向量状态更强的表达能力;论文进一步提出 mini-batch TTT 和 dual form,把这个嵌套学习过程改造成更适合 GPU/TPU 的矩阵运算。
本文的贡献可以分成四层:
- 概念框架:把所有序列建模层统一看成“初始状态、更新规则、输出规则”三部分,并把隐状态设计为一个可学习模型。
- TTT 层:提出用自监督重构损失训练隐状态模型,实例化出 TTT-Linear 与 TTT-MLP。
- 效率方法:用 mini-batch gradient descent 暴露 token 级并行性,用 dual form 把大量小 outer product 改写成矩阵乘法。
- 实验验证:在 125M–1.3B 参数、2k–32k context 的语言模型实验中,验证 TTT 对长上下文的潜力,并与 Transformer、Mamba 比较。
论文并没有证明 TTT 在所有任务上全面超过 Transformer。更准确的结论是:相比具有固定表达结构的传统 RNN,TTT 提供了一条让状态表达能力随学习器复杂度扩展的路径;但这种表达能力仍要付出 wall-clock 和 memory I/O 成本。
二、背景:为什么需要 TTT
2.1 用统一视角看序列建模层
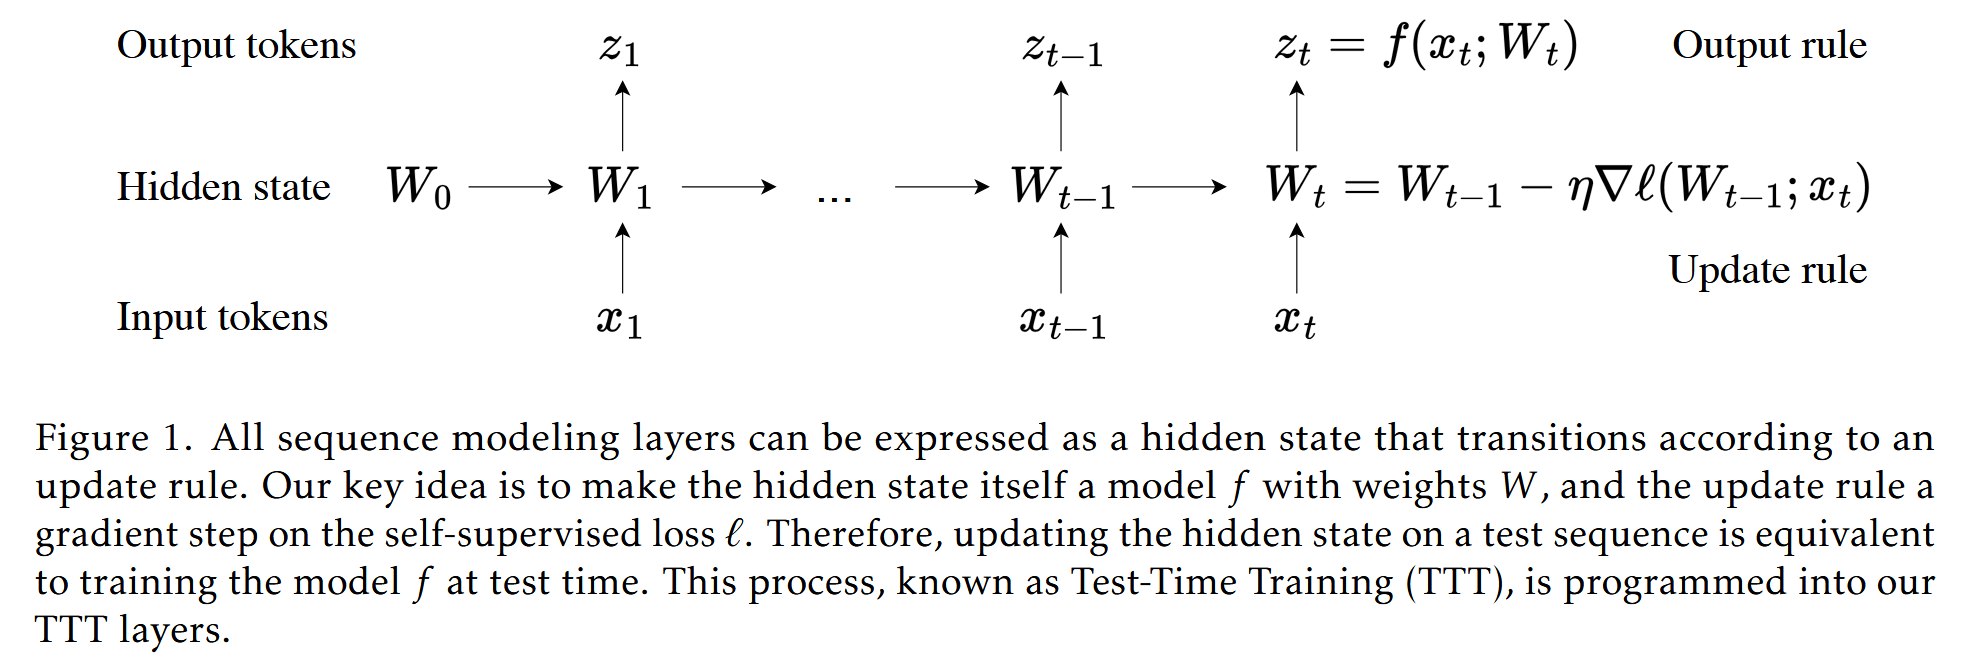
论文把一个自回归序列建模层写成三部分:
- Initial state:序列开始时的状态;
- Update rule:读入当前 token 后如何更新状态;
- Output rule:如何由当前 token 和更新后的状态产生输出。
设输入为 $x_1,\ldots,x_T$,状态为 $s_t$,输出为 $z_t$,则可抽象为:
$$ s_t = \operatorname{Update}(s_{t-1},x_t), \qquad z_t = \operatorname{Output}(s_t,x_t). $$这个抽象可以覆盖不同模型:
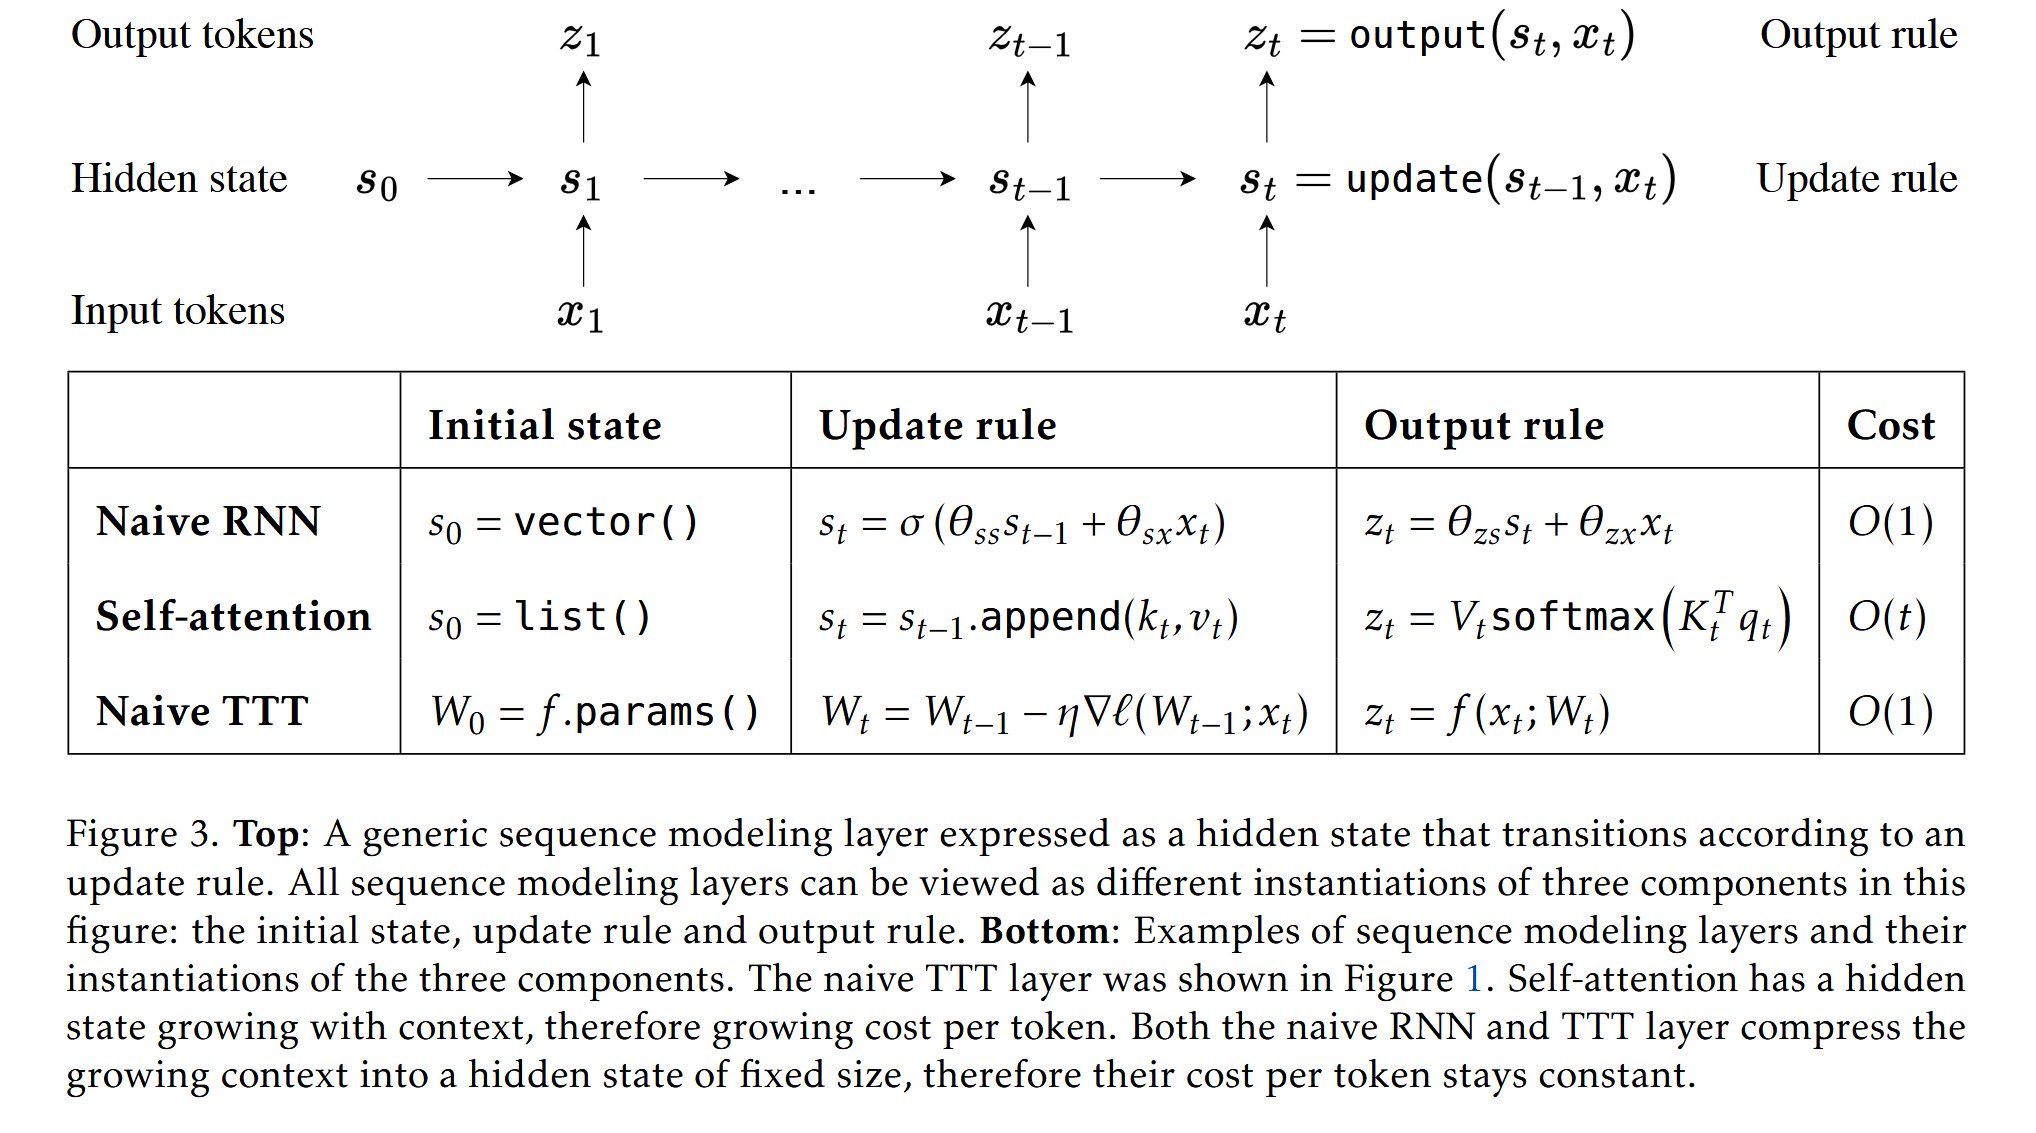
关键不是把所有模型都叫成 RNN,而是明确:模型之间的根本区别在于它们如何存储历史、如何更新存储、如何从存储中读出信息。
2.2 Transformer:表达能力强,但 KV cache 随上下文增长
Self-attention 可以显式保存历史 token 的 key-value:
$$ z_t = V_t\operatorname{softmax}(K_t^\top q_t). $$它的优势是:
- 历史信息几乎不需要被压缩;
- 当前 query 可以直接检索任意历史位置;
- 对复制、局部比较、长距离依赖和内容寻址很强;
- 训练时充满矩阵乘法,适合现代加速器。
代价是:
- 训练时 attention 的计算通常随序列长度呈二次增长;
- 自回归生成需要保存不断增长的 KV cache;
- 长上下文时每个新 token 的读取成本会增加。
2.3 RNN/Mamba:计算线性,但固定状态可能压缩过度
RNN 把历史压缩成固定大小的状态:
$$ s_t=\operatorname{Update}(s_{t-1},x_t). $$因此它具有:
- 线性序列复杂度;
- 常数大小的推理状态;
- decode 时不需要保存完整 KV cache;
- 对长序列更友好的渐近复杂度。
但固定大小状态也带来根本问题:当上下文从几千 token 增加到几万、几百万 token 时,模型必须不断决定哪些信息值得留下、哪些信息可以丢弃。这个过程不是简单的缓存,而是一个困难的压缩问题。
论文强调:RNN 的长上下文能力不是只由 FLOPs 决定,而是由隐状态的表达能力和更新规则共同决定。
2.4 Mamba 不能持续利用更长上下文
论文先重新检查 scaling law 中关于 RNN 的旧结论(RNN 不像 self-attn 那样 scalable),给出两个重要观察:
计算规模视角
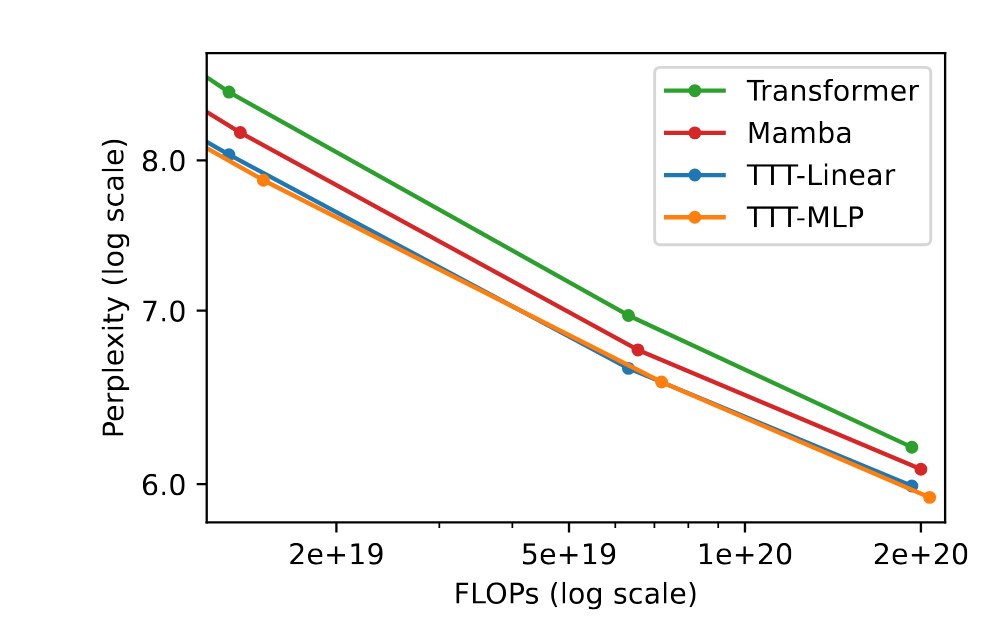
在 Pile、8k context 上,Mamba、TTT-Linear、TTT-MLP 与 Transformer 都可以取得有竞争力的 perplexity。现代 RNN 相比早期 LSTM 已经有明显进步。
token index 视角
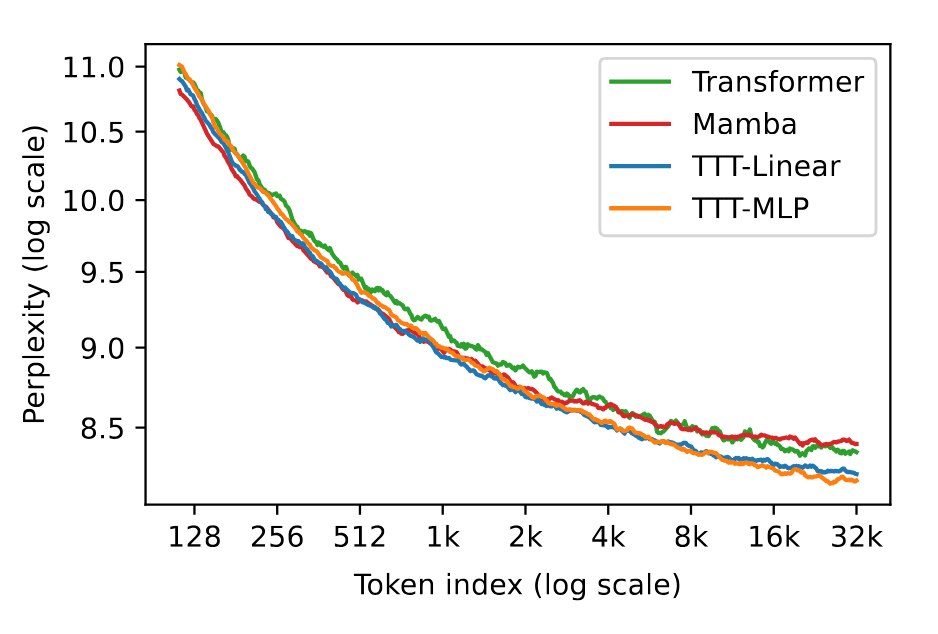
把每个位置的平均 perplexity 单独画出来:
- Transformer 随着 token index 增大,平均 perplexity 持续下降;
- TTT-Linear 和 TTT-MLP 也能继续从更多历史中受益;
- Mamba 大约在 16k token 之后趋于平台。
直观上,序列后面的 token 能看到更多上下文,理论上应该更容易预测。Mamba 的平台说明:它虽然计算上能处理更长序列,但固定状态并没有把新增信息有效转化为预测能力。
2.5 动机:把“启发式压缩”升级为“可学习模型”
自监督学习已经展示过一种强大的压缩方式:把大量数据中的结构和关系压缩进模型参数。一个 LLM 的权重不是逐条保存互联网文本,但可以通过参数化函数编码大量统计规律和语义关系。
论文的关键类比是:
- 普通 RNN 的隐状态:一个固定结构的存储容器;
- TTT 的隐状态:一个正在学习的模型;
- 历史 token:这个小模型的内循环训练集;
- 更新规则:在当前 token 上执行自监督梯度下降;
- 输出规则:用更新后的模型对当前输入进行预测。
因此,TTT 试图让状态不再只是“一个更大的向量”,而是一个具有内部结构、能学习关系的函数。
2.6 相关工作
Test-Time Training
传统 Test-Time Training 的一般形式是:测试样本本身定义一个无标签学习问题,模型先在测试样本上做自监督适应,再进行预测。此前工作主要应用于视觉、视频和分布偏移场景。
本文的区别在于:
- 自监督任务不是手工固定,而是由外循环端到端学习;
- TTT 不是对完整模型做一次昂贵的测试时 fine-tuning;
- 学习过程被写进每个 token 的状态转移,因此天然具有自回归形式。
Dynamic evaluation
在语言模型中,dynamic evaluation 通常直接用测试序列继续 fine-tune 语言模型。TTT 只把一个轻量的 inner model 放到层内部,因而更像一种可重复调用的局部自适应层。
Fast weights 与 fast-weight programmers
Fast weights 的思想是:一组慢参数控制一组快参数,快参数只在局部数据上快速更新。TTT 中:
- $W$ 是 fast state;
- $\theta$ 是 outer-loop 的 slow parameters;
- 内循环在当前序列上更新 $W$;
- 外循环通过语言建模损失学习如何初始化、投影和更新 $W$。
现代线性 RNN
Linear attention、DeltaNet、GLA、RWKV、Mamba 等都可被视为对历史构造一个固定大小的矩阵或结构化状态。TTT-Linear 与这一脉络关系尤其紧密,论文明确承认:
- DeltaNet 可以看作 TTT-Linear 在 inner-loop mini-batch size 为 1、没有 Layer Norm 和 residual 时的一个特例;
- 论文的主要新增点不是第一个提出矩阵状态,而是提出一个能把更一般的神经网络作为状态的框架。
三、方法:把隐状态变成一个正在学习的模型
3.1 Naive TTT 的基本形式
令状态不再是向量 $s_t$,而是一个模型 $f$ 的参数 $W_t$。当前 token 先触发一次更新:
$$ W_t=W_{t-1}-\eta\nabla\ell(W_{t-1};x_t), $$然后使用更新后的模型输出:
$$ z_t=f(x_t;W_t). $$这里:
- $W_t$ 是 inner-loop state;
- $\eta$ 是 inner-loop learning rate;
- $\ell$ 是 self-supervised loss;
- 外循环不直接把 $W_t$ 当作普通训练参数;
- 对每个输入序列,都会产生一条独立的 $W_1,\ldots,W_T$ 轨迹。
注意更新顺序:论文使用的是先更新、再预测。这样当前 token 既参与状态学习,也由更新后的状态产生输出。
3.2 为什么不能直接用 next-token prediction 作为 inner loss
在测试时,当前 token 的下一个 token 还没有标签,无法直接使用外循环的 next-token label 来更新状态。TTT 因而需要一个只依赖当前 token 的自监督任务。
最初的简单选择是重构当前 token:
$$ \ell(W;x_t)=\|f(\widetilde{x}_t;W)-x_t\|_2^2. $$其中 $\widetilde{x}_t$ 是由 $x_t$ 破坏得到的输入。重构迫使 $f$ 学习输入不同维度之间的相关性,而不是简单复制输入。
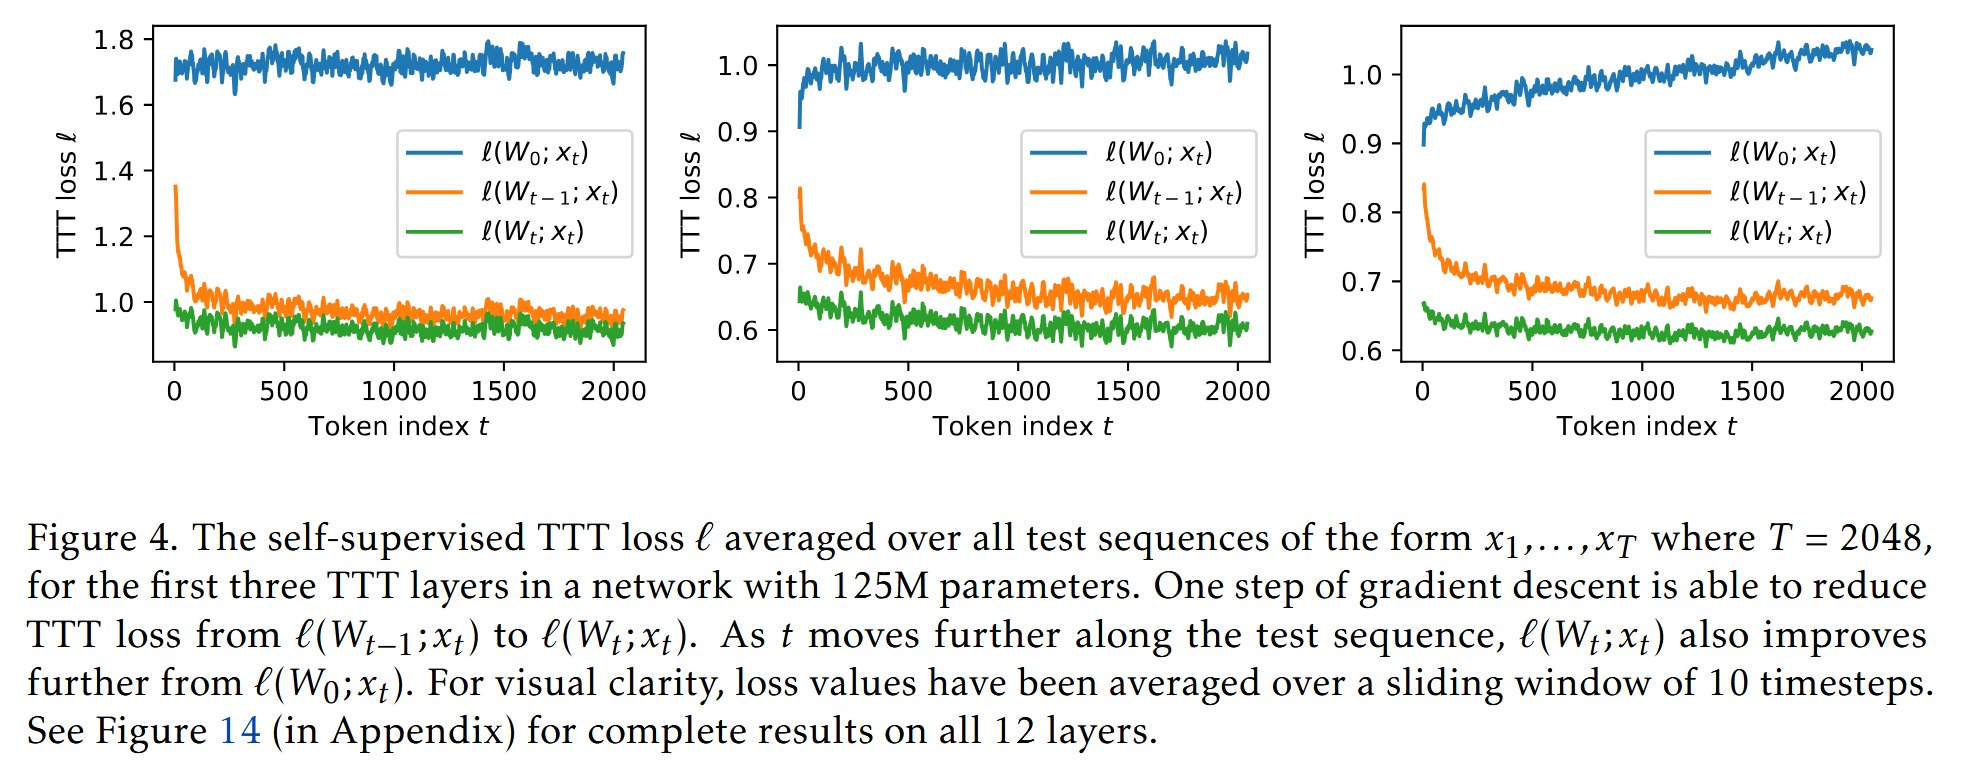
Figure 4 说明了这一过程:一次梯度更新可以让当前 token 的 TTT loss 从 $\ell(W_{t-1};x_t)$ 降到 $\ell(W_t;x_t)$;随着序列推进,$W_t$ 相比共享的初始状态 $W_0$ 对当前数据的重构也会越来越好。
3.3 Multi-view reconstruction:让自监督任务由外循环学习
论文没有手工指定“哪些维度值得重构”,而是引入三个可学习的线性视图:
- training view:$\theta_Kx_t$;
- label view:$\theta_Vx_t$;
- test view:$\theta_Qx_t$。
内循环损失是:
$$ \ell(W;x_t) = \left\|f(\theta_Kx_t;W)-\theta_Vx_t\right\|_2^2. $$输出规则改为:
$$ z_t=f(\theta_Qx_t;W_t). $$这三个视图的职责不同:
| 视图 | 作用 | 类比 |
|---|---|---|
| $\theta_Kx_t$ | 提供 inner model 的输入 | key / training signal |
| $\theta_Vx_t$ | 提供重构目标 | value / label |
| $\theta_Qx_t$ | 产生当前输出所需的查询 | query / test input |
这样,outer loop 会同时学习:
- 哪些输入信息被写入 $W_t$;
- 哪些信息被当作重构目标;
- 当前输出应该从 $W_t$ 中查询什么。
因此,TTT 的 inner loss 不需要人工设计成“对语言最合理”的形式;outer loop 会通过最终的 next-token prediction 自动选择有用的重构任务。
3.4 Inner loop 与 outer loop
TTT 包含两个嵌套学习过程:
Inner loop
对每一个 token 执行自监督学习:
$$ W_t \leftarrow W_{t-1}-\eta\nabla_W\ell(W_{t-1};x_t). $$梯度只对 $W$ 求。
Outer loop
把整个网络放在普通语言模型训练中,用 next-token prediction 优化:
- 主干网络参数;
- $\theta_K,\theta_V,\theta_Q$;
- 可学习的初始状态 $\theta_{\mathrm{init}}$;
- 可学习的 learning-rate 参数;
- 其他 backbone 参数。
外循环梯度需要穿过 inner-loop 的更新轨迹,因此本质上是 higher-order differentiation 或 meta-learning 风格的反向传播。
论文强调:虽然有两个 loop,但 outer loop 仍然是普通的监督语言模型训练。每条序列本身是 inner loop 的数据集,而整个语料库是 outer loop 的数据集。
3.5 Mini-batch TTT:暴露序列内并行性
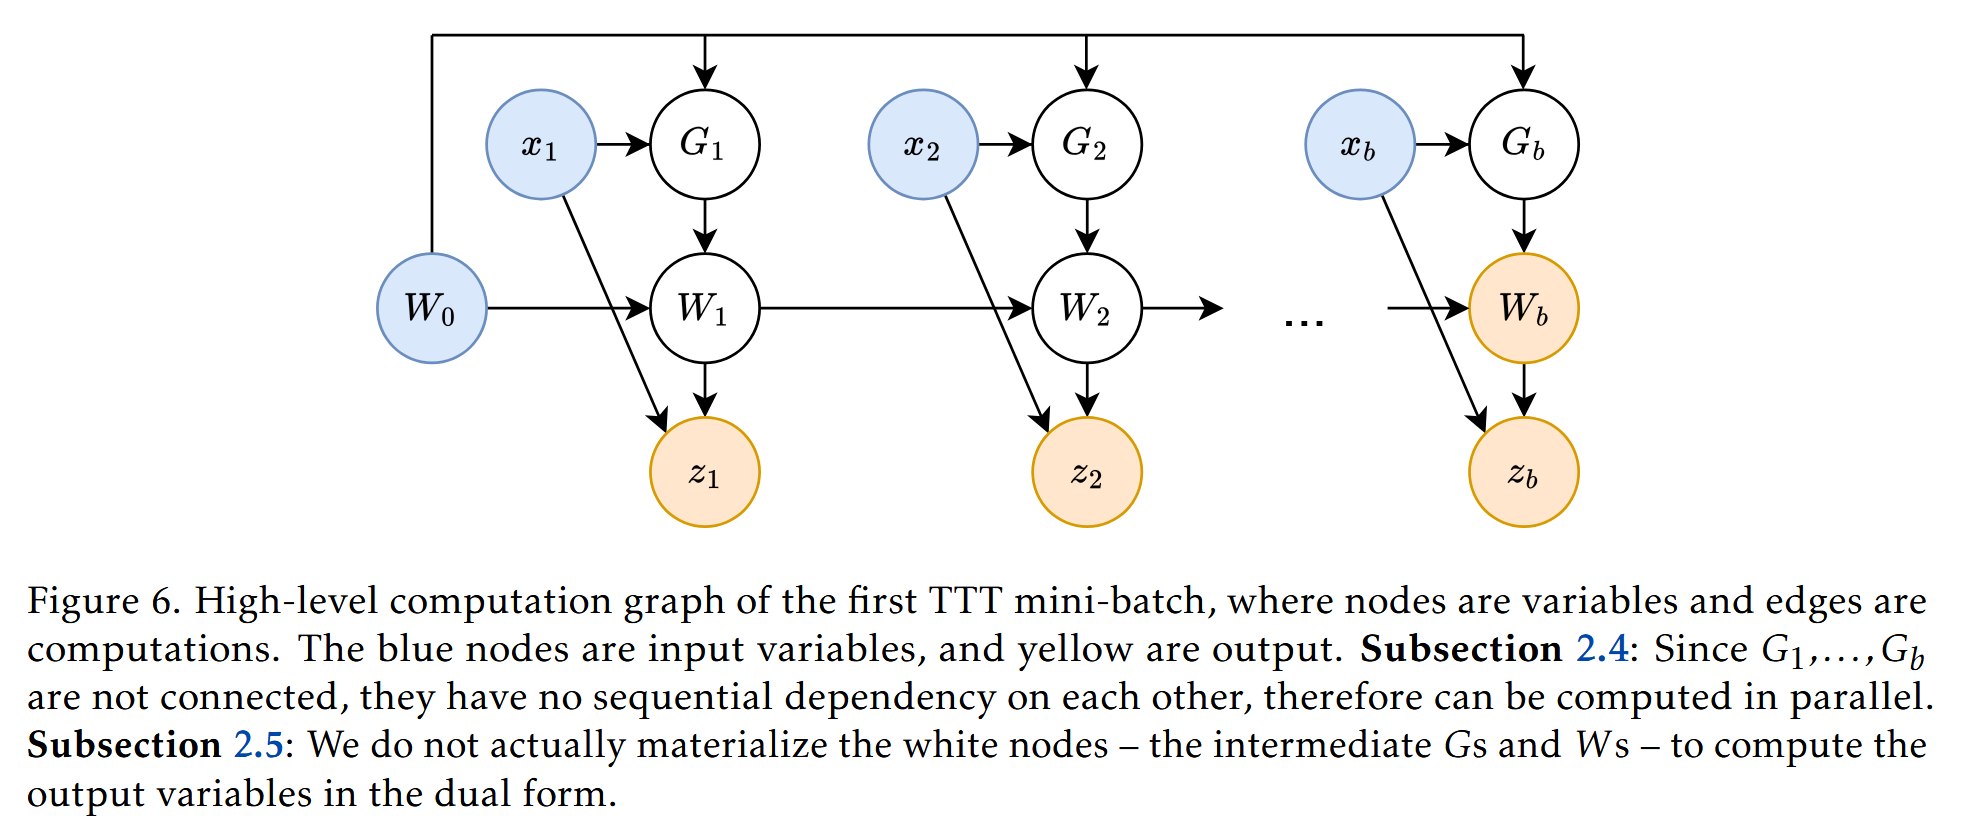
在线 GD 的串行瓶颈
最直接的 online gradient descent 是:
$$ G_t=\nabla\ell(W_{t-1};x_t), \qquad W_t=W_{t-1}-\eta G_t. $$因为 $G_t$ 依赖 $W_{t-1}$,而 $W_{t-1}$ 又依赖所有前面的 token,所以 token 之间存在严格串行依赖。
Batch GD 的另一种极端
也可以固定使用 $W_0$ 计算全部梯度:
$$ G_t=\nabla\ell(W_0;x_t), \qquad W_t=W_0-\eta\sum_{s=1}^{t}G_s. $$此时 $G_1,\ldots,G_T$ 可以并行计算,但每个 $W_t$ 实际上只离 $W_0$ 一步,inner model 的有效搜索空间太小,语言建模性能会下降。
Mini-batch GD 的折中
把序列切成大小为 $b$ 的 mini-batch。令 $t'$ 为当前 batch 开始前的最后一个时间位置,则:
$$ G_t=\nabla\ell(W_{t'};x_t), \qquad W_t=W_{t-1}-\eta G_t. $$在同一个 mini-batch 中,所有 token 都使用同一个 $W_{t'}$ 计算梯度,因此 $G_t$ 可以并行;但更新仍然通过累积和作用到每个 $W_t$。
这一设计保留两条信息传播路径:
- cumsum 路径:每个梯度更新都会累加进后续状态;
- gradient 路径:只有跨 mini-batch 时,后面的梯度才看到前一批更新后的 $W$。
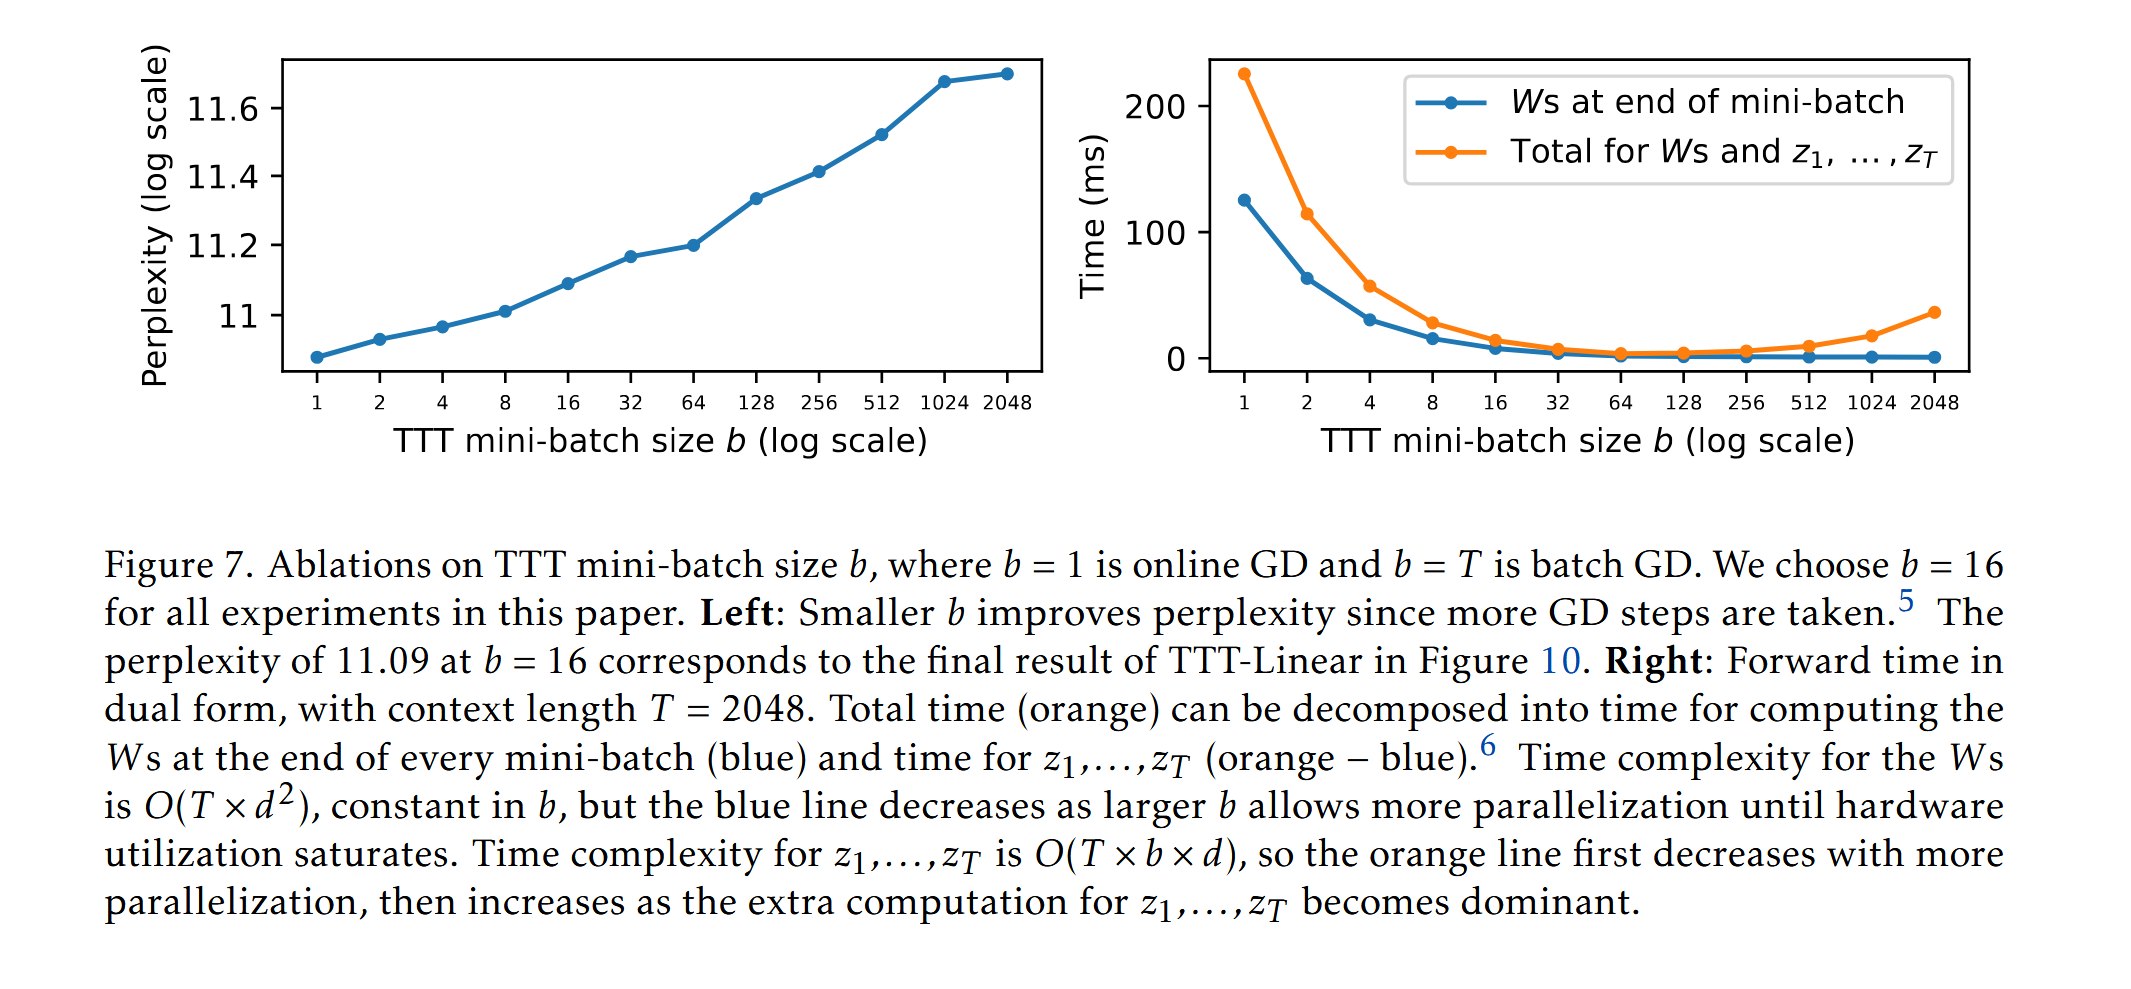
论文实验发现:
- $b=1$ 是 online GD,质量最好但最慢;
- $b=T$ 是 batch GD,并行度高但质量差;
- $b=16$ 在质量和速度之间取得较好折中,论文后续实验统一采用 $b=16$。
3.6 Dual form:把小梯度操作改成大矩阵乘法
Mini-batch 只解决了梯度之间的依赖,但没有解决硬件效率问题。现代 GPU/TPU 擅长矩阵乘法,而 naive/primal TTT 会产生大量:
- 单 token outer product;
- 小矩阵更新;
- 每一步不同的中间权重;
- 大量 memory I/O。
论文因此推导 dual form。它不显式物化每个 token 的梯度 $G_t$ 和中间状态 $W_t$,而是直接计算:
- mini-batch 末尾的状态;
- 当前 mini-batch 内每个输出 token。
线性模型的简化推导
先考虑:
$$ f(x;W)=Wx,\qquad \theta_K=\theta_V=\theta_Q=I. $$第一 mini-batch 中:
$$ \ell(W_0;x_t)=\|W_0x_t-x_t\|_2^2, $$$$ G_t=2(W_0x_t-x_t)x_t^\top. $$令 $X=[x_1,\ldots,x_b]$,则 batch 末尾权重可以直接写成:
$$ W_b =W_0-2\eta\sum_{t=1}^{b}(W_0x_t-x_t)x_t^\top =W_0-2\eta(W_0X-X)X^\top. $$这一步只需要矩阵乘法,不必逐个生成 $G_t$。
当前 mini-batch 内第 $t$ 个输出仍然需要看到前 $t$ 个更新。令 $\Delta=[\delta_1,\ldots,\delta_b]$,论文把它写成:
$$ \Delta=(W_0X-X)\operatorname{mask}(X^\top X), $$其中 mask 是遵循因果顺序的三角掩码。于是:
$$ Z=W_0X-2\eta\Delta. $$Primal 与 dual 的区别
| 形式 | 计算方式 | 优点 | 缺点 |
|---|---|---|---|
| Primal | 显式构造每个 $G_t,W_t$ | 公式直观,理论复杂度低 | 大量小操作与 memory I/O |
| Dual | 直接用矩阵乘法得到 batch 状态和输出 | 硬件利用率高 | 引入 batch 内二次项 |
复杂度上,mini-batch 内:
- primal 约为 $O(bd^2)$;
- dual 计算末状态仍约为 $O(bd^2)$;
- 输出还需要约 $O(b^2d)$。
虽然 dual 的理论 FLOPs 不一定更低,但实际 $b$ 只有 16 左右,而 $d$ 是几百,因此矩阵乘法带来的硬件收益更重要。论文在 JAX 实现中观察到 dual form 比 primal form 快 5 倍以上。
3.7 任意神经网络作为 inner model
Dual form 不只适用于线性模型。附录 A 对任意深度、带逐元素非线性激活的 MLP 推导了对应形式。
对第 $k$ 层:
$$ Z^k=W_0^k\widehat X^k, \qquad \widehat X^{k+1}=\sigma_k(Z^k). $$首先在初始权重上做一次标准的 batch forward/backward,得到对 mini-batch 总 loss 的梯度:
$$ \nabla_{W_0^k}\ell = \left(\nabla_{Z^k}\ell\right)\left(\widehat X^k\right)^\top. $$于是 batch 末尾权重可以直接更新:
$$ W_b^k=W_0^k-\nabla_{W_0^k}\ell. $$随后,输出 token 的第二次 forward 通过一个因果 mask 把每个 token 之前的梯度贡献施加到对应的初始权重上。附录中的关键事实是:
$$ \widehat V =V\cdot\operatorname{mask}(A^\top Q), $$其中第 $t$ 列正好累积 $s\le t$ 的贡献。
这说明 dual form 可以处理 nonlinear inner model,但也有边界:
- matmul、sum、mask 和逐元素激活都可以较好地硬件化;
- 非线性内部的复杂算子及其 VJP 不会自动获得同样的加速;
- inner model 越复杂,wall-clock 和 memory I/O 代价越明显。
四、理论等价性与具体实例
4.1 TTT-Linear 可以退化为 linear attention
论文 Theorem 1 的设置是:
- inner model 是 $f(x)=Wx$;
- 使用 batch GD;
- $\eta=1/2$;
- $W_0=0$;
- 使用多视图 reconstruction。
在 $W_0=0$ 时:
$$ \nabla\ell(W_0;x_t) = -2(\theta_Vx_t)(\theta_Kx_t)^\top. $$因此:
$$ W_t = \sum_{s=1}^{t} (\theta_Vx_s)(\theta_Kx_s)^\top. $$输出为:
$$ z_t = f(\theta_Qx_t;W_t) = \sum_{s=1}^{t} (\theta_Vx_s) (\theta_Kx_s)^\top (\theta_Qx_t). $$这正是最简单的 linear attention:
$$ z_t = \sum_{s=1}^{t} v_sk_s^\top q_t. $$定理的意义不是说 TTT 没有新东西,而是说明:
TTT 是一个更大的设计空间;linear attention 是其中“线性 learner + batch GD”的一个特例。
4.2 Nadaraya-Watson estimator 可以恢复 self-attention
TTT 的 learner 不一定有显式参数 $W$。论文考虑:
$$ f(x;x_1,\ldots,x_t) = \frac{ \sum_{s=1}^{t}\kappa(x,x_s)y_s }{ \sum_{s=1}^{t}\kappa(x,x_s) }. $$其中:
$$ y_s=\theta_Vx_s, \qquad \kappa(x,x') \propto \exp\left((\theta_Kx)^\top(\theta_Qx')\right). $$把它代入输出规则后,就得到 self-attention 的 softmax 权重。因此,TTT 的统一抽象可以同时表达:
- 固定状态的 RNN;
- 参数化 learner 的 TTT;
- linear attention;
- 非参数 learner 形式的 self-attention。
区别在于,非参数 learner 的状态是历史样本列表,输出时仍要扫描历史,因此失去固定状态和常数 decode 成本。
4.3 Learner abstraction
为统一 parametric learner 与 nonparametric learner,论文把 learner 抽象成两个接口:
- train:接收当前 token,更新内部存储;
- predict:使用更新后的内部存储产生输出。
对 parametric learner,内部存储可以包括:
- $W$;
- optimizer state;
- 其他自适应变量。
这为未来引入 Adam、momentum 或 weight decay 留下了接口。
4.4 TTT-Linear 与 TTT-MLP
TTT-Linear
$$ f_{\mathrm{lin}}(x)=Wx. $$它是最接近 linear attention/DeltaNet 的版本,计算开销较小。
TTT-MLP
$$ f_{\mathrm{MLP}}(x) = W_2\operatorname{GELU}(W_1x), $$隐藏维度为输入维度的 4 倍,类似 Transformer 中的 MLP。
为了稳定 inner-loop 学习,二者实际使用:
$$ f(x)=x+\operatorname{LN}(f_{\mathrm{res}}(x)). $$LayerNorm 和 residual 是 inner model 的一部分,而不是仅仅在外部 backbone 上做的普通归一化。
4.5 Learnable initial state
如果固定 $W_0=0$,所有序列从同一个空状态开始。论文改为学习一个共享的 $\theta_{\mathrm{init}}=W_0$:
- $W_0$ 在所有序列之间共享;
- $W_1,\ldots,W_T$ 仍然随每条输入序列不同;
- $\theta_{\mathrm{init}}$ 通过 outer loop 学习;
- 参数量很小,因为 inner model 的输入输出维度较低。
单独学习 $W_0$ 会轻微变差,但后续的 LayerNorm、residual 和 mini-batch TTT 在没有它时无法稳定训练。因此它更像训练稳定性基础设施,而不是单独带来收益的组件。
4.6 Learnable inner learning rate
论文让 learning rate 依赖当前输入:
$$ \eta(x) = \eta_{\mathrm{base}}\sigma(\theta_{\mathrm{lr}}^\top x). $$其中:
- $\theta_{\mathrm{lr}}$ 是 outer-loop 学习的向量;
- $\sigma$ 是 sigmoid;
- $\eta_{\mathrm{base}}=1$ 用于 TTT-Linear;
- $\eta_{\mathrm{base}}=0.1$ 用于 TTT-MLP。
它也可以理解成一个 gradient gate:当前 token 不是必须以相同强度写入状态。
4.7 Backbone architecture
论文比较两种 backbone:
- Transformer backbone:Llama 风格的 RoPE、SwiGLU、RMSNorm;
- Mamba backbone:在 TTT 层前加入 temporal convolution,并沿用 Mamba/Griffin 风格的结构。
实验中 TTT-Linear 和 TTT-MLP 默认使用 Mamba backbone,图中标记为 M;放入 Transformer backbone 的版本标记为 T。
作者观察到:
- temporal convolution 对表达能力较弱的 TTT-Linear 帮助更明显;
- TTT-MLP 已经更 expressive,因此在 Transformer backbone 下反而表现出更大的潜力;
- 当 inner model 足够强时,未来可能不再需要 Mamba backbone 的 convolution。
五、实验
5.1 问题设置
论文实验围绕以下问题展开:
- TTT-Linear/MLP 是否能在短上下文保持竞争力?
- 随着 context 变长,TTT 是否比 Mamba 更能利用新增信息?
- TTT-MLP 的表达能力是否能在长上下文中转化为收益?
- mini-batch size 对质量和速度的 trade-off 是什么?
- TTT 的 FLOPs 优势是否也能转化为 wall-clock 优势?
- TTT 与 Transformer 的比较在 scratch pretraining 和 long-context fine-tuning 下是否一致?
5.2 数据集
Pile
遵循 Mamba 的设置,论文在 Pile 上评估:
- 2k context;
- 8k context。
Pile 中超过 8k 的序列相对较少,因此它不适合充分检验超长上下文。
Books3
为了研究长上下文,论文使用 Pile 的 Books3 子集,context length 为:
$$ 1k,\;2k,\;4k,\;8k,\;16k,\;32k. $$Books3 被广泛用于长上下文训练,因此可以更直接观察模型是否从更远的 token 中获益。
符号:
- TTT-Linear (M):TTT-Linear + Mamba backbone;
- TTT-MLP (M):TTT-MLP + Mamba backbone;
- TTT-Linear (T):TTT-Linear + Transformer backbone;
- TTT-MLP (T):TTT-MLP + Transformer backbone;
- TF pretrain:Transformer 从头训练到目标 context;
- TF finetune:先在 Books 2k 训练,再在目标长上下文上 fine-tune。
5.3 Mini-batch size ablation
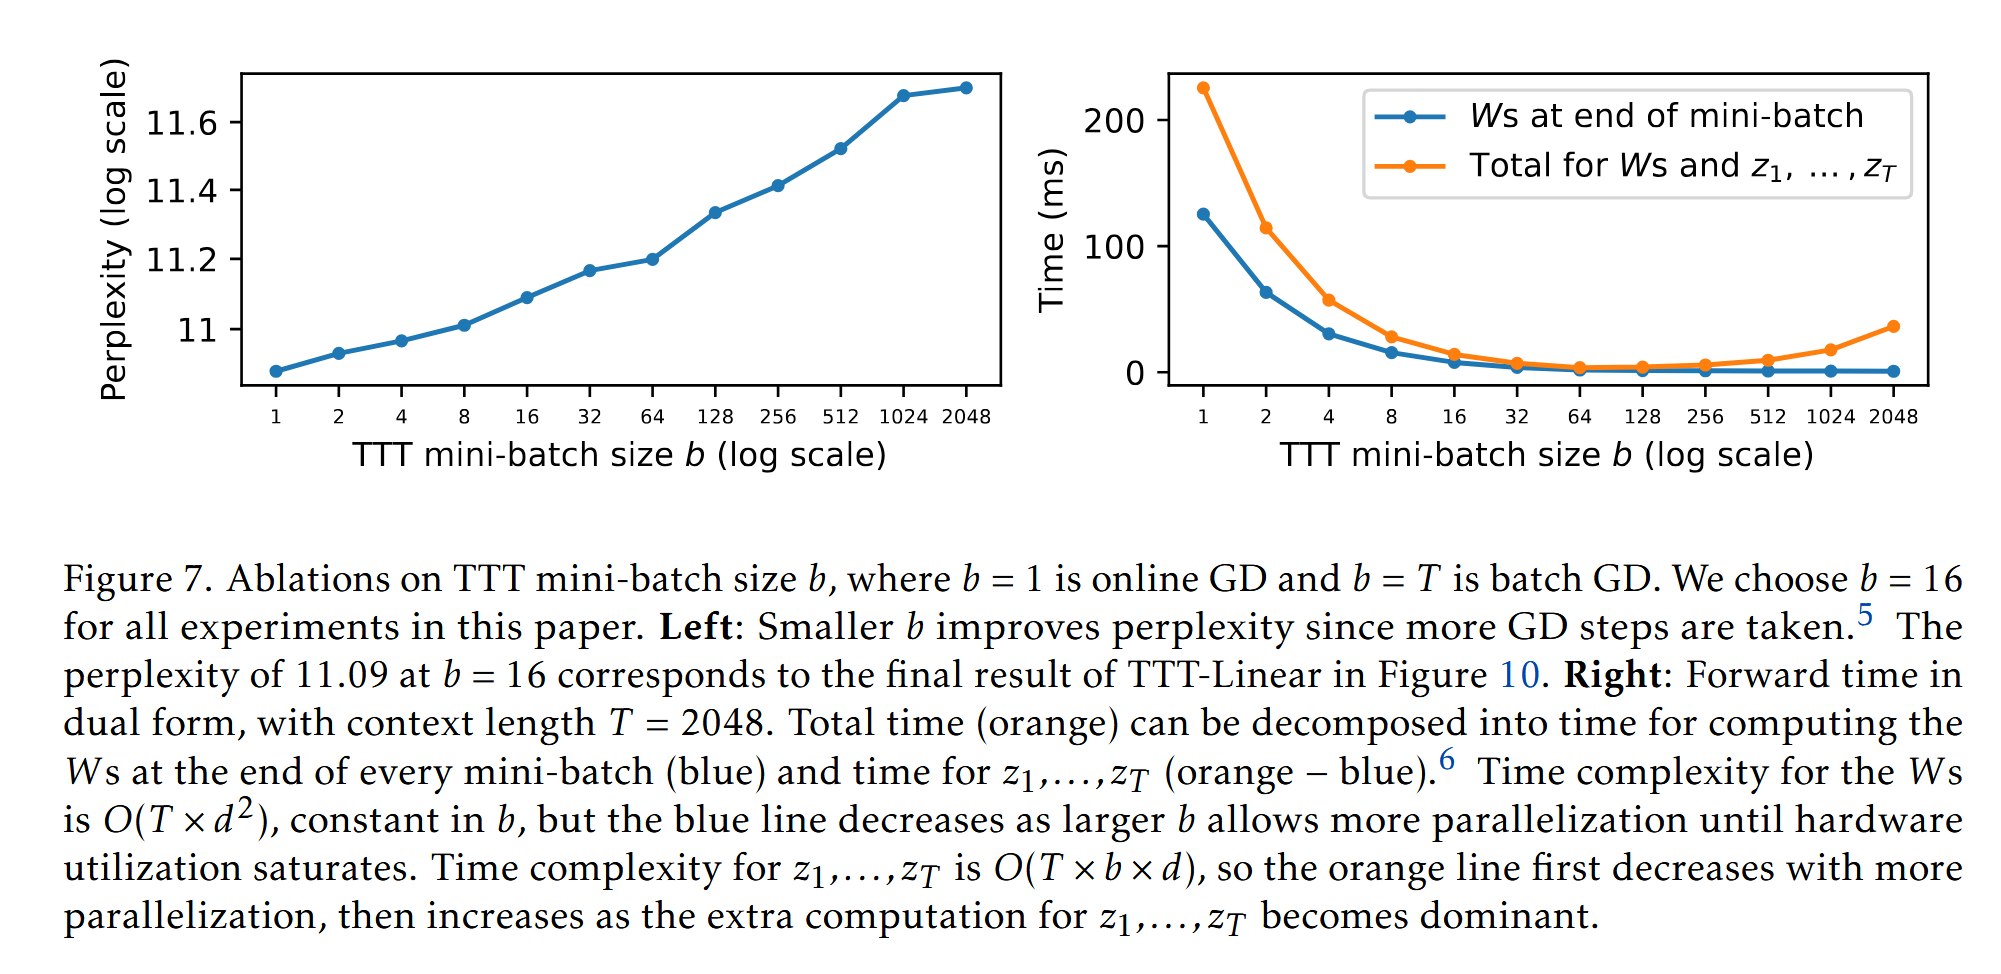
Figure 7 左图显示 TTT mini-batch size $b$ 对 perplexity 的影响:
- $b=1$:online GD,inner-loop 更新最多,质量最好,但序列并行性最差;
- $b=T$:batch GD,最容易并行,但有效更新步数太少,质量下降;
- $b=16$:质量和速度平衡最好,论文后续统一使用。
右图把 forward time 拆成:
- 每个 mini-batch 末尾状态 $W$ 的计算;
- 当前 mini-batch 内所有输出 token 的计算。
计算 $W$ 的理论复杂度对 $b$ 基本不变,但 batch 越大越容易使用矩阵乘法;计算所有输出的成本约为 $O(Tbd)$,因此 $b$ 太大时又会增加。
这张图体现出 TTT 的核心工程矛盾:
更小的 batch 带来更强的 inner-loop 学习,但更大的 batch 才能把计算交给加速器。
6.2 Table 1:从 linear attention 到 TTT-Linear
以下是 125M 模型的逐步消融。指标是 perplexity,越低越好。
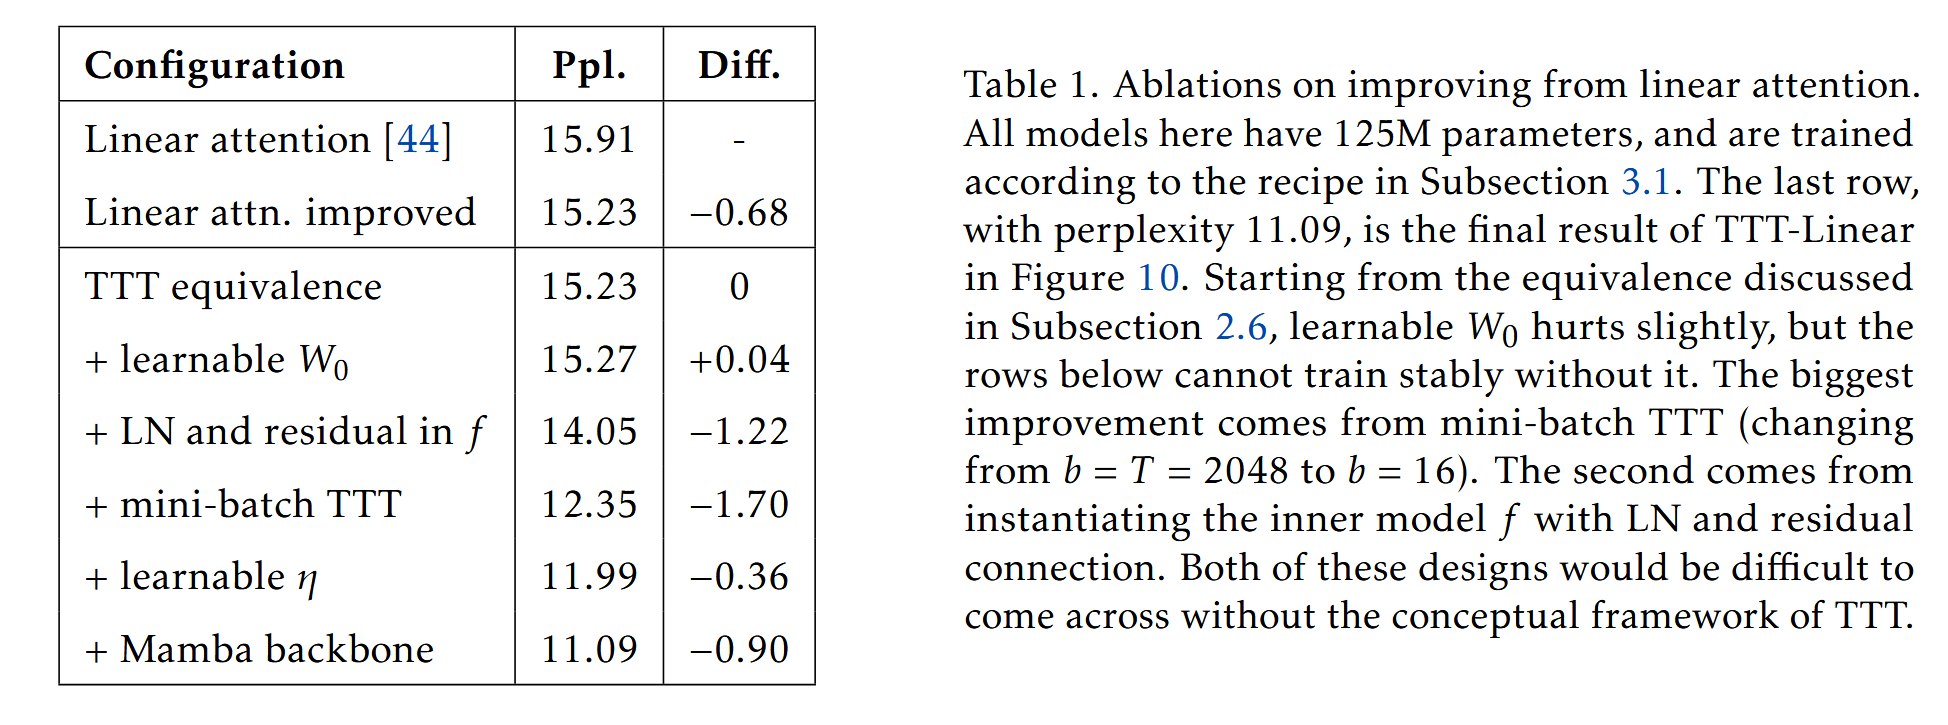
- Linear attention → improved linear attention:论文先修正/改进 baseline 实现,得到 0.68 PPL 的收益。
- Improved linear attention → TTT equivalence:理论等价得到实验验证,PPL 完全一致。
- Learnable $W_0$:单独看略有损失,但它改善后续训练稳定性。
- LN + residual:inner model 更稳定、更容易优化,收益显著。
- Mini-batch TTT:除了效率改变,也改变了 inner-loop 的学习行为;这是最大单项提升。
- Learnable $\eta$:让不同 token 自适应地决定写入强度。
- Mamba backbone:局部 temporal convolution 进一步帮助 TTT-Linear。
可以看出论文的设计是一个逐层构造过程:理论等价性提供起点,真正的性能来自状态模型、更新粒度、学习率和 backbone 的共同设计。
6.3 Pile 2k:短上下文中 TTT 不一定占优
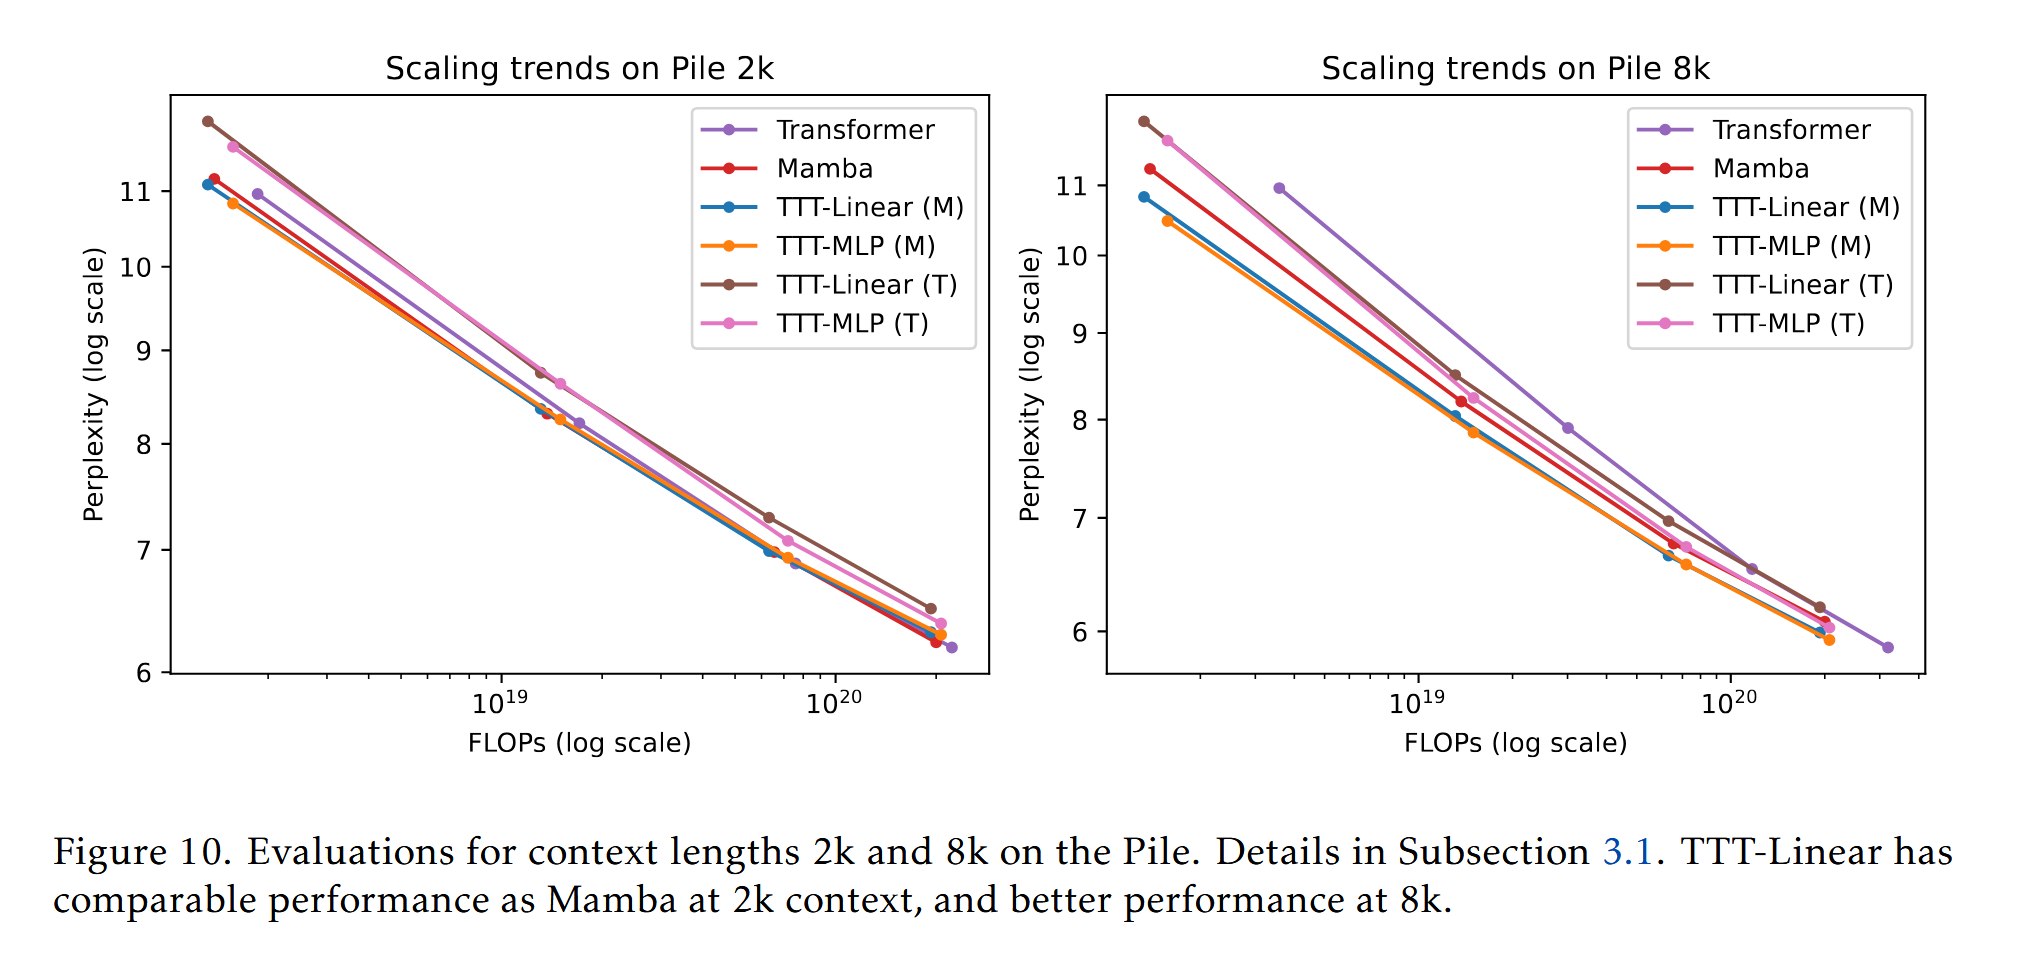
Figure 10 左图显示:
- TTT-Linear (M)、Mamba 和 Transformer 的曲线大体重叠;
- TTT-MLP (M) 在大 FLOP budget 下略差;
- TTT-MLP 的单模型 perplexity 可能更好,但它的 inner model 更贵,在 matched FLOPs 比较中优势被抵消。
这说明 TTT 的核心卖点并不是“所有上下文长度都更好”。在短上下文中:
- Transformer 的显式检索很有优势;
- Mamba/TTT 的线性复杂度还没有完全兑现;
- TTT-MLP 的额外表达能力可能尚未被充分利用。
6.4 Pile 8k:TTT 相对 Mamba 的优势扩大
Figure 10 右图显示:
- TTT-Linear (M) 明显优于 Mamba;
- TTT-MLP (M) 也明显优于 Mamba;
- TTT-MLP (T) 在约 1.3B 时甚至略优于 Mamba;
- Transformer 仍有很强 perplexity,但它的 FLOPs 曲线不具备线性模型的成本优势。
论文观察到一个稳定趋势:
context length 越长,TTT 相对 Mamba 的优势越明显。
这正好符合论文的动机:TTT 的收益来自更 expressive 的隐状态,而不是只来自更便宜的递归。
6.5 Backbone ablation:为什么 Mamba backbone 对 TTT-Linear 更重要
在目前的模型规模和 context 范围内:
- Mamba backbone 通常让 TTT-Linear/MLP 的表现更好;
- TTT-MLP 在 Transformer backbone 下相对 TTT-Linear 的优势更明显;
- 论文猜测:temporal convolution 对较弱的 inner model 提供了重要的局部信息收集能力;
- 当 inner model 从 linear 变成 MLP 后,TTT 自己已经拥有更强的表达能力,因此 Transformer backbone 的潜力更容易显现。
因此不能简单说“Mamba backbone 最好”。更合理的结论是:backbone 与 hidden-state learner 存在互补关系。
6.6 Books 2k:数据集变化会改变相对排序
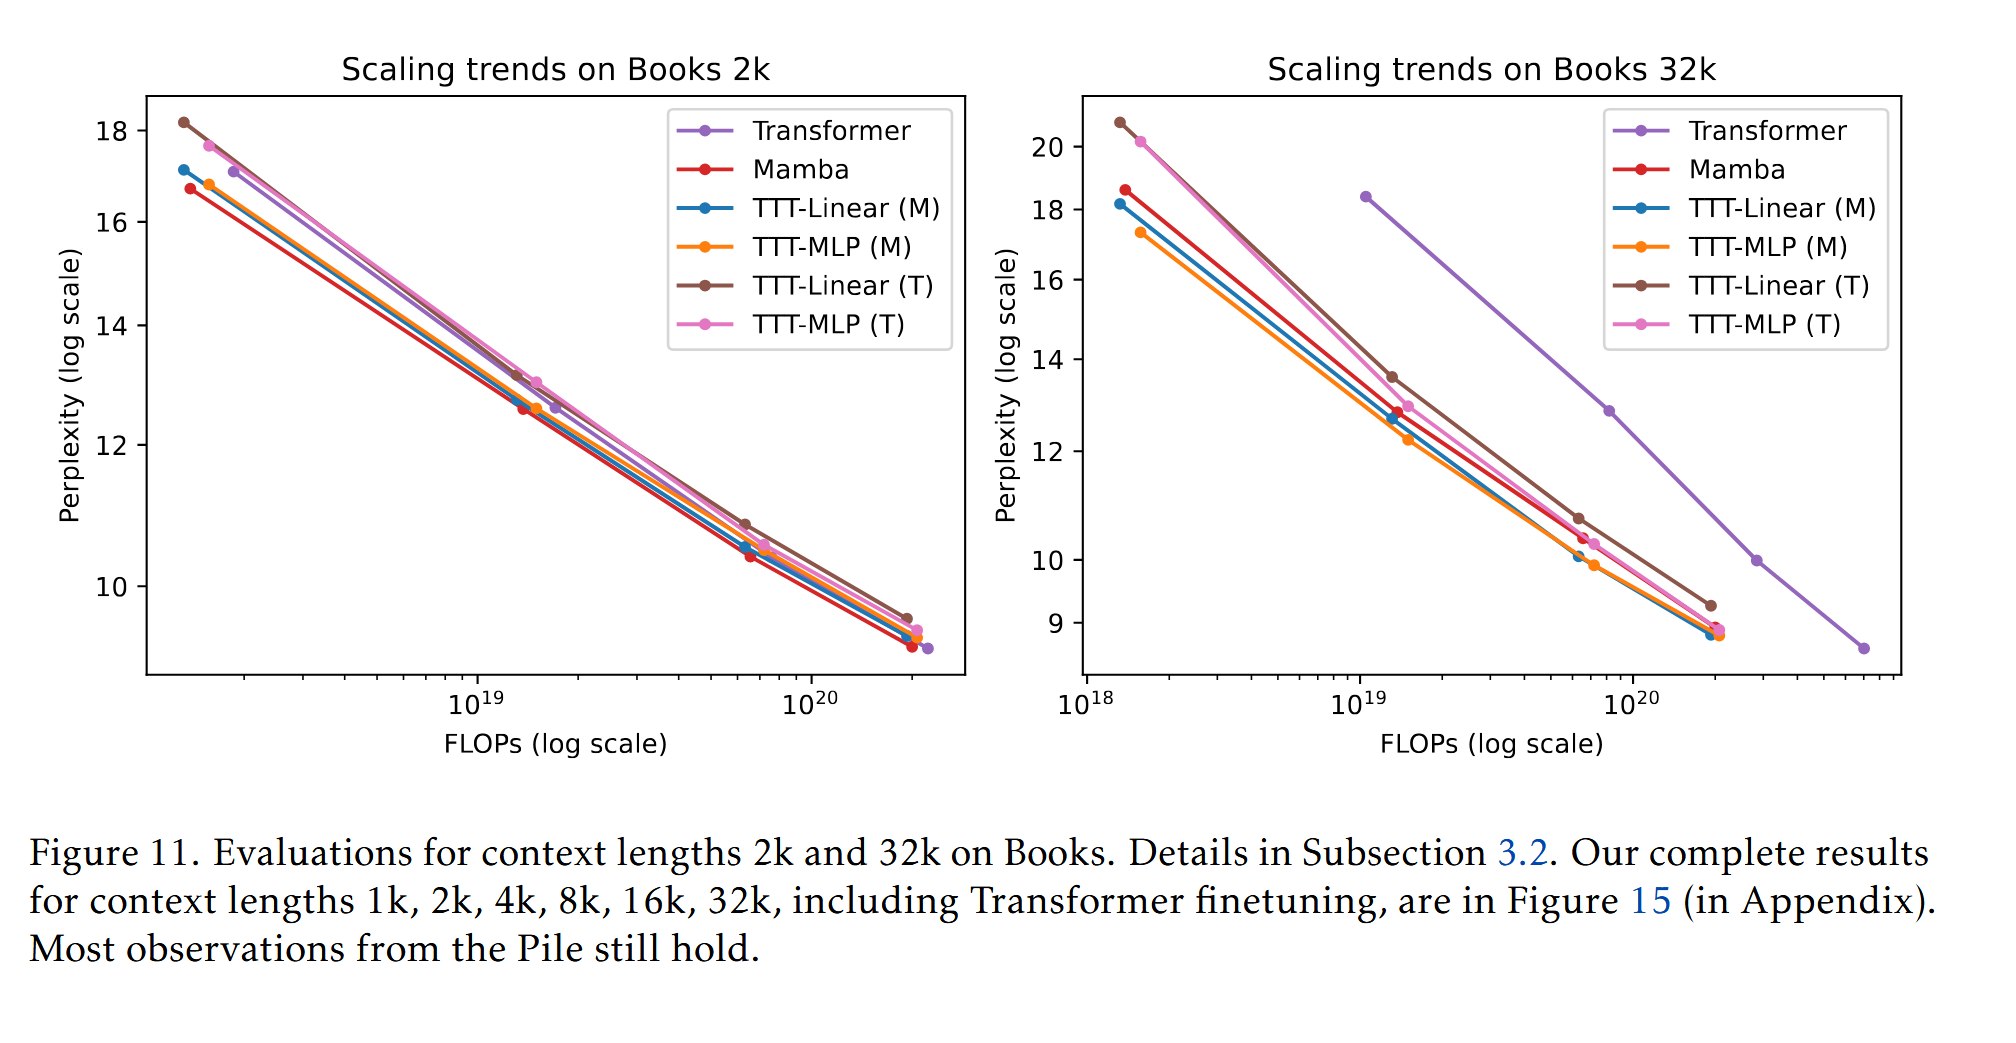
在 Books 2k:
- Pile 2k 中的总体结论大多仍然成立;
- 但 Mamba 这次略优于 TTT-Linear。
这说明 TTT 的优势不是完全独立于数据分布的普遍常数,而会受到:
- 文本类型;
- context length;
- 训练 recipe;
- 模型规模;
- tokenizer;
等因素影响。
6.7 Books 32k:TTT 更能利用长上下文
在 Books 32k:
- TTT-Linear (M) 和 TTT-MLP (M) 都优于 Mamba;
- TTT-MLP (T) 也略优于 Mamba;
- TTT-MLP (T) 与 TTT-MLP (M) 差距不大;
- 更 expressive 的 MLP hidden state 在长上下文中变得更有价值。
论文认为,若模型规模和上下文继续扩大,Transformer backbone 可能更适合 TTT-MLP;但现有实验还不足以证明这一点是严格 scaling law。
6.8 Transformer fine-tuning baseline
实际长上下文训练通常不是从零开始训练一个长 context Transformer,而是:
- 先在较短 context 上预训练;
- 再用更长 context fine-tune。
论文因此加入 TF finetune:
- 先用 Books 2k 的模型;
- 在目标 context length 上额外训练 20% tokens;
- 尝试 peak learning rate $10^{-5},10^{-4},10^{-3}$;
- 125M 最好的是 $10^{-4}$;
- 350M 及以上最好的是 $10^{-5}$。
这一 baseline 在 32k context 中很强,是比从零训练 Transformer 更严格的比较对象。TTT 的优势应理解为:在保持近似线性计算和常数状态的前提下,取得接近或超过若干强 baseline 的性能,而不是全面击败经过专门长上下文 fine-tuning 的 Transformer。
6.10 按 token index 看“是否还在吸收上下文”
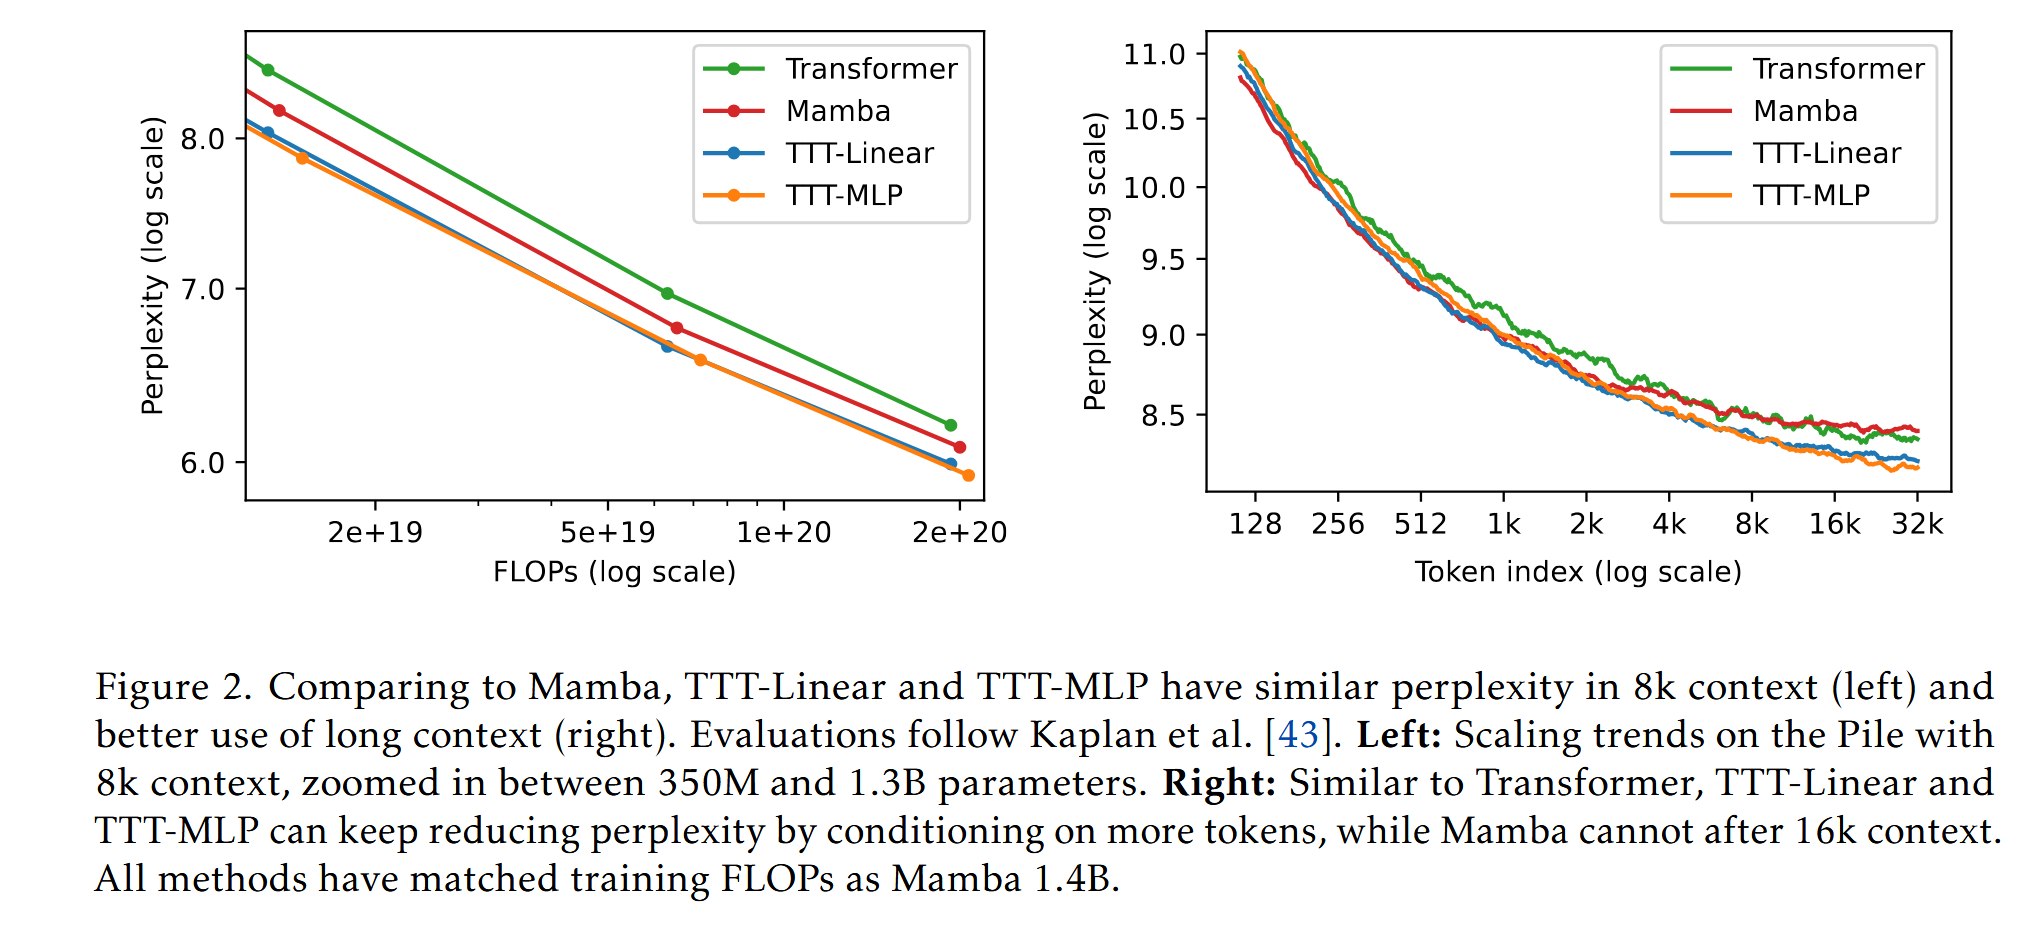
看右边那个
这是论文最有说服力的现象之一:
- Transformer:平均 PPL 随 token index 持续下降;
- TTT-Linear:同样持续下降;
- TTT-MLP:也持续下降,长上下文潜力更强;
- Mamba:约 16k 后趋于平台。
这比单一的最终 perplexity 更贴近论文问题。TTT 的目标不是仅仅在固定 2k benchmark 上赢一点,而是让状态在处理更长历史时继续发生有效学习。
6.11 Wall-clock time
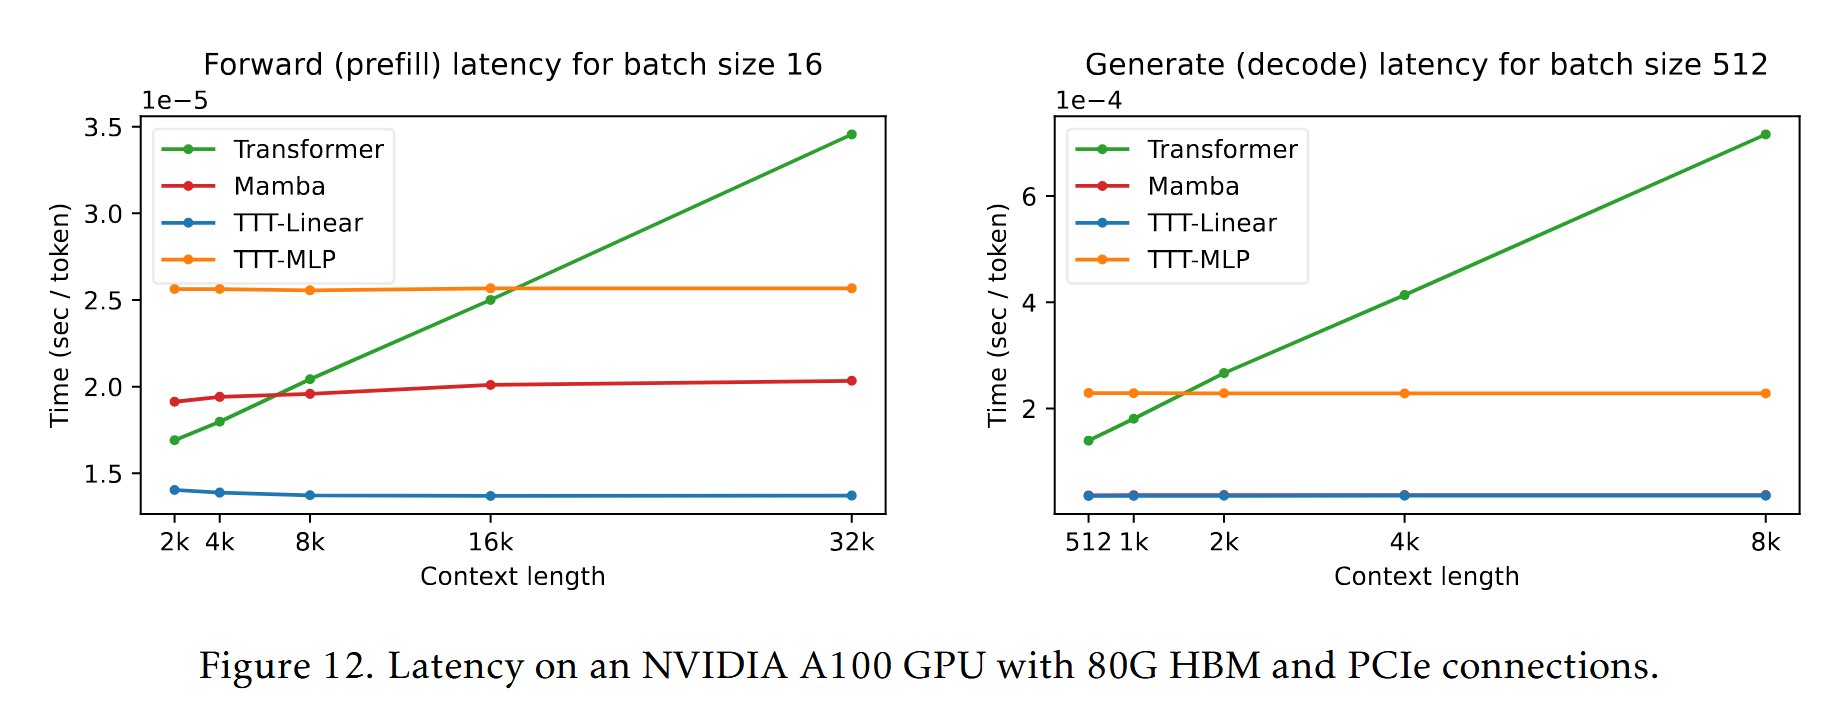
论文区分:
- forward / prefill:可以使用 dual form 并行;
- backward:同样可以并行;
- generate / decode:天然是逐 token 的,因此使用 primal form。
在 v5e-256 TPU pod、2k context 上:
- Transformer:约 0.30 秒/iteration;
- TTT-Linear:约 0.27 秒/iteration。
这说明 TTT-Linear 在未经大量系统优化时已经可以略快于 Transformer。
在 NVIDIA A100 80G 上的 inference:
- Transformer 每 token latency 随 context length 增长;
- TTT-Linear、TTT-MLP、Mamba 的单层状态处理成本大致保持常数;
- TTT-MLP 的常数项明显更高。
重要的 caveat 是:TTT-MLP 在 FLOPs 图上很有潜力,但复杂的 MLP 状态更新会带来更高的 memory I/O,实际 wall-clock 未必按 FLOPs 比例改善。
6.12 Gradient checkpointing through time
普通框架会保存 forward 中的所有中间状态供 backward 使用。对 TTT 而言,这会保存:
$$ W_1,W_2,\ldots,W_T, $$内存消耗不可接受。
使用 mini-batch 和 dual form 后,只需要保存每个 mini-batch 末尾的状态,数量约为:
$$ \kappa=T/b. $$论文进一步使用沿时间维度的 gradient checkpointing:反向时重新计算部分状态,而不是保存所有状态。这是让 TTT 在较长序列上训练的必要工程技巧。
七、总结
7.1 支持的结论
- 隐状态的表达能力是长上下文 RNN 的关键瓶颈。
- 把隐状态变成模型参数,可以让状态通过自监督学习压缩上下文。
- TTT-Linear 和 TTT-MLP 能在长上下文上持续从新增 token 中获益。
- Mini-batch TTT 是质量与序列并行性的关键折中。
- Dual form 的主要价值是硬件利用率,而不是降低渐近 FLOPs。
- TTT-Linear 至少在理论上统一了 linear attention;更一般的 TTT 还可以表达非线性 learner。
- TTT-MLP 的表达能力在长上下文中更有潜力,但 wall-clock 成本更高。
- TTT 的优势相对 Mamba 在 context length 变长后更明显。
7.2 局限性
7.2.1 Wall-clock 仍是主要瓶颈
TTT 的渐近复杂度和 FLOPs 很有吸引力,但:
- inner-loop 梯度会引入额外算子;
- 每个 mini-batch 需要状态读写;
- TTT-MLP 的中间激活和权重更新增加 memory I/O;
- 当前 dual form 主要是算法层面的优化,不是完整的生产级 kernel 系统。
论文明确指出,TTT-MLP 相对 FLOPs 的优势尚未完全转化成 wall-clock 优势。
7.2.2 上下文长度和模型规模仍不够大
论文没有实验百万或十亿级 context,也没有训练更大规模模型来验证“context 越长、TTT 优势越大”是否持续成立。
随着上下文增长,inner model $f$ 可能也需要变大。论文提出,视频和 embodied agent 场景中的上下文可以达到百万甚至十亿级,此时 inner model 可能需要是 CNN 或其他更适合长序列结构。
7.2.3 自监督任务的搜索空间极大
目前使用的是 linear multi-view reconstruction:
$$ \theta_Kx_t\rightarrow \theta_Vx_t. $$但可能还有更好的:
- 非线性 view;
- 多 token reconstruction;
- 对比学习;
- 预测局部未来;
- 任务相关的结构化重构;
- 带不确定性的目标。
论文认为,outer-loop 可以把 regular training 中的架构和优化启发式迁移到 test-time learning 中。
7.2.4 TTT-MLP 的状态并非免费
更复杂的 hidden-state model 带来更多表达能力,但也带来:
- 更大的状态;
- 更高的梯度和 forward 成本;
- 更大的 activation;
- 更严重的 memory I/O;
- 更复杂的 kernel 融合问题。
因此“让状态更 expressive”与“让状态更易于并行”之间存在明显 trade-off。
说些什么吧!