
零、写在前面
挑了几篇 TTT/CL 的论文,最近找时间过一遍。
这个并不是提出 DeltaNet 的论文,因为 DeltaNet 那个形式跟 RNN 似的,串行推理,所以本文是对 DeltaNet 进行改进从而能够在 GPU tensor core 上训练。这个其实很有意义的,更有利于去 scale 了。单看一个 DeltaNet 没啥意思,寻思找这篇读一下。
另外之前读过一篇 δ-Mem,能看懂方法,但是不知道为什么会这么做,现在感觉就是换皮 DeltaNet。
一、标题
来源:NeurIPS 2024
在序列长度维度上并行化采用 Delta Rule 的线性 Transformer。
本文解决的是一个很具体但非常关键的工程问题:DeltaNet 的 Delta Rule 具有更好的关联记忆能力,却因为原始训练算法沿序列严格串行,难以在现代 GPU 上高效训练;作者利用广义 Householder 变换的紧凑 WY 表示,推导出一种 chunkwise parallel 算法,使 DeltaNet 能够用矩阵乘法和 GPU tensor cores 训练,并进一步扩展到 1.3B、100B tokens 的语言模型实验。
本文贡献:
- 算法贡献:给出 DeltaNet 的硬件高效训练算法,支持在序列长度维度上并行化 forward/backward。
- 理论/表示贡献:发现 DeltaNet 的状态转移可以看作一连串 rank-one 的广义 Householder 变换,并用紧凑 WY 表示避免逐时间步物化矩阵状态。
- 实证贡献:把 DeltaNet 规模化到现代语言模型训练设置,并系统比较其与 Transformer、Mamba、GLA、RetNet 等模型的性能,同时验证 sliding-window attention 和少量 global attention 的混合方案。
二、背景
2.1 问题:Softmax Attention 的计算与缓存成本
给定长度为 $L$ 的输入序列,标准 causal softmax attention 在时间步 $t$ 读取之前的 key-value 对:
$$ o_t = \sum_{i=1}^{t} \frac{\exp(k_i^\top q_t)}{\sum_{j=1}^{t}\exp(k_j^\top q_t)}v_i. $$它的主要优点是表达能力强,尤其擅长:
- 在上下文中精确检索某个 token 或 key-value 对;
- 进行局部比较、复制和位置相关的交互;
- 依靠矩阵乘法获得很高的 GPU 训练效率。
但它有两个基本代价:
- 训练时对序列长度的计算复杂度通常为 $O(L^2d)$;
- 自回归推理需要保存不断增长的 KV cache,缓存规模随 $L$ 线性增长。
因此,研究者一直在寻找能够保留较强序列建模能力、同时实现线性时间和常数状态推理的模型。
2.2 Linear Attention:把 Attention 改写为线性 RNN
Linear attention 用 用一个线性算子 $\phi$ 替代 softmax,从而近似为内积:
$$ \exp(k_i^\top q_t) \approx \phi(k_i)^\top\phi(q_t). $$
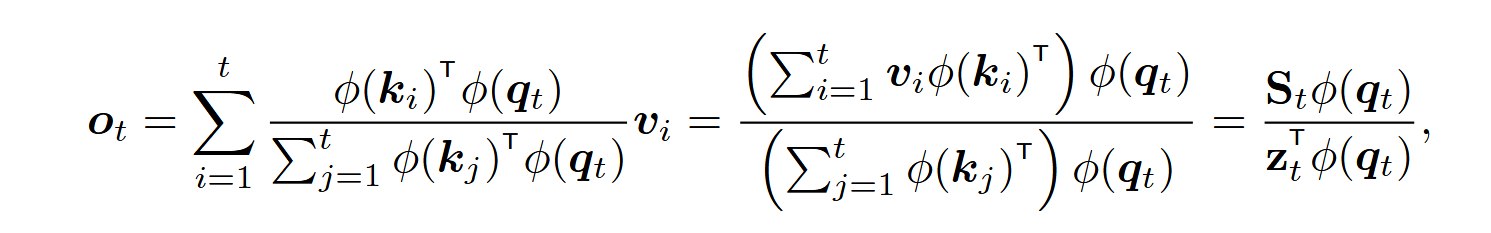
因为这样就满足结合律了,等价为可以先累计一个矩阵状态:
$$ S_t = \sum_{i=1}^{t}v_i\phi(k_i)^\top, \qquad z_t = \sum_{i=1}^{t}\phi(k_i), $$再用 $S_t$ 和当前 query 计算输出。
我们更常见的做法是,用 Identity 来做线性算子 $\phi$,并且去掉归一化项:
$$ O = \frac{QK^TV}{\sqrt{d}} = \frac{Q(K^TV)}{\sqrt{d}} $$这里的实质是把原来线性增长的注意力机制压缩成了 $K^TV$ 这个 d * d 的固定大小状态,我们用 S 来替代 $K^TV$ 最简单的 Linear Transformer 变为:
$$ S_t = S_{t-1}+v_tk_t^\top, \qquad o_t=S_tq_t. $$这里的状态 $S_t$ 是一个矩阵,而不是标准 RNN 中的向量。
2.3 动机:加法更新的记忆容量有限
普通 Linear Transformer 的状态更新为:
$$ S_t=S_{t-1}+v_tk_t^\top. $$它本质上是把新的 key-value 关联直接加到记忆中。这种更新有一个明显缺陷:只能写入,不能根据新 key 与已有记忆的交互主动删除旧关联。
当序列长度超过状态维度后,不同 key 可能发生 collision:多个 key 方向竞争同一部分有限状态空间,旧信息难以被精确覆盖或清理。
从 fast weight programming 或 Hopfield network 的角度看,普通线性 attention 类似 Hebbian/additive update,记忆容量有限;Delta Rule 则根据预测误差修正权重,因此具有更好的关联记忆能力。
2.4 DeltaNet:先读、再纠错、再写
DeltaNet 使用 Delta Rule,也称 Widrow-Hoff rule 或 LMS-style update。首先用当前 key 从旧状态读取一个旧值:
$$ v_t^{\text{old}}=S_{t-1}k_t. $$然后把它与真实目标 $v_t$ 比较,并按学习率 $\beta_t$ 进行修正:
$$ S_t =S_{t-1}-\beta_t(S_{t-1}k_t-v_t)k_t^\top. $$等价地,定义误差:
$$ e_t=v_t-S_{t-1}k_t, $$则:
$$ S_t=S_{t-1}+\beta_te_tk_t^\top. $$这个公式非常值得记忆:
- 用 $S_{t-1}k_t$ 读取当前 key 对应的旧值;
- 计算目标值与旧值之间的误差;
- 只沿当前 key 方向进行修正;
- 修正幅度由 $\beta_t$ 控制。
因此,DeltaNet 不是简单地把 (v_tk_t^\top) 加进去,而是先移除当前 key 方向上的旧预测,再写入新的值。它能够在有限状态容量下实现更有针对性的遗忘。
2.5 online regression 视角下的 Delta Rule
DeltaNet 也可以看成对如下在线平方损失执行一步 SGD:
$$ L_t(S)=\frac{1}{2}\|Sk_t-v_t\|^2. $$梯度为:
$$ \nabla_S L_t=(Sk_t-v_t)k_t^\top, $$所以:
$$ S_t=S_{t-1}-\beta_t\nabla_S L_t(S_{t-1}). $$这为 DeltaNet 在 retrieval-intensive task 上可能优于普通线性 attention 提供了直观解释:平方损失的梯度会随着预测误差增大而增大,错误越严重,修正越强。但这只是机制层面的解释,最终优势仍取决于状态容量、训练设置和具体任务。
另一个等价的 retrieval 解释是:
$$ v_t^{\text{new}} =\beta_tv_t+(1-\beta_t)v_t^{\text{old}}, $$并执行:
$$ S_t =S_{t-1}-v_t^{\text{old}}k_t^\top+v_t^{\text{new}}k_t^\top. $$当 $\beta_t=1$ 时,当前 key 对应的旧值被完全替换;当 $\beta_t=0$ 时,状态不变。
2.6 个人思考:Why f(k) = v?
因为我们做 linear attention 是为了做压缩,不然 kv cache 就要平方级别的去存历史的 kv。而我们又希望我们的压缩方式是尽可能无损的。如果我们能找到一个映射 f,能够做到 f(k) = v,这可以说明 model “记住了” 输入 k 就应当输出 v 这样的一种规则。换句话说,这可以看作让 model 得到了一种联想记忆的能力。
当然,上述纯属个人yy,事实上还是有一些形式化理解的;
传统 Linear Attention 的“记忆污染”问题
最早的 Linear Attention(Katharopoulos et al., 2020)正是按照这一思路设计的。通过核函数技巧脱去 Softmax 后,它的隐藏状态更新公式为:
$$S_t = S_{t-1} + v_t k_t^\top \quad (\text{类似经典的赫布学习律 Hebbian Learning})$$检索时的输出为:
$$o_t = S_t q_t$$如果让它用过去的某个 key 去检索,会发生什么: 问题:
- 只要历史 key 之间不正交(在自然语言中这几乎必然发生),后面的求和项就会变成严重的串扰噪声(Cross-talk / Interference)。
- 传统的 Linear Attention 只管往隐藏状态矩阵里“累加”新信息,从不考虑旧信息是否冲突。随着序列增长,矩阵很快就会被噪声充满,导致严重的记忆混乱和快速遗忘,这也是早期线性 Transformer 性能远落后于标准 Transformer 的主要原因。
而 deltanet 的实现可以写成:
$$ S_t = \underbrace{S_{t-1} (I - \beta k_t k_t^\top)}_{\text{选择性擦除}} + \underbrace{\beta v_t k_t^\top}_{\text{精准写入}} $$这一步优化的精妙之处在于:
- 误差驱动(Error-driven):它先拿当前的记忆矩阵预测一下 $k_t$ 对应什么($\hat{v}_t = S_{t-1} k_t$),如果预测已经很准(误差为 0),就不更新;只有预测不准时,才写入差值(Delta)。
- 主动擦除干扰:矩阵项 $(I - \beta k_t k_t^\top)$ 会精确地沿着 $k_t$ 方向将原本残留的旧记忆“投影视为 0(擦除)”,给新信息腾出空间。
- 严格保证 $f(k) \approx v$:如果设步长 $\beta = 1/\|k_t\|^2$,那么一步更新后,新矩阵严格满足 $S_t k_t = v_t$。
2.7 原始 DeltaNet 的瓶颈
DeltaNet 的 recurrent 推理形式计算量与普通线性 attention 相同,约为 $O(Ld^2)$,且推理时只需要保存矩阵状态。
但它的原始训练实现沿序列逐步执行:第 $t$ 步必须先得到 $S_{t-1}$,才能计算 $S_t$。这种实现具有三个问题:
- 无法充分利用 sequence-level parallelism;
- 大量逐元素或小矩阵操作无法有效利用 GPU tensor cores;
- 随着序列长度和模型规模增加,训练吞吐明显不足。
于是本文的核心问题变成:能否在不改变 DeltaNet 数学结果的前提下,把它改写成类似 chunkwise linear attention 的硬件友好算法?
三、方法
3.1 从 Delta update 到 pseudo value
将 DeltaNet 更新式写成:
$$ S_t=S_{t-1}+u_tk_t^\top, $$其中:
$$ u_t=\beta_t(v_t-S_{t-1}k_t). $$这样一来,DeltaNet 的状态看起来与普通线性 attention 完全一样:
$$ S_t=\sum_{i=1}^{t}u_ik_i^\top, \qquad o_t=S_tq_t. $$如果所有 $u_t$ 已经计算出来,输出就可以写成 causal matrix multiplication:
$$ O=(QK^\top\odot M_L)U, $$其中 $M_L$ 是 causal mask。
真正的困难在于:计算 $u_t$ 需要 $S_{t-1}k_t$,而 $S_{t-1}$ 又依赖之前全部 token。直接计算会产生 $O(L^2d)$ 的成本,并且仍然是串行的。
3.2 DeltaNet 的状态转移是 rank-one 矩阵变换
将 Delta update 展开:
$$ \begin{aligned} S_t &=S_{t-1}-\beta_t(S_{t-1}k_t-v_t)k_t^\top\\ &=S_{t-1}(I-\beta_tk_tk_t^\top)+\beta_tv_tk_t^\top. \end{aligned} $$其中:
$$ I-\beta_tk_tk_t^\top $$是 identity 加 rank-one 矩阵的形式。作者把它视为一种广义 Householder transformation。
普通 Householder transformation 常用于构造正交反射矩阵;本文中的转移矩阵一般不一定是严格正交矩阵,但同样具有 identity 加低秩修正的结构。
这带来一个重要机会:一个 chunk 内的多个转移矩阵的乘积,虽然表面上是 $d\times d$ 矩阵,但可以用 chunk 内的若干个 d 维向量表示$空间约为 (O(Cd)$,其中 C 是 chunk size,而不必为每个时间步显式物化一个矩阵状态。
这里就涉及到一些数值线性代数的理论了,我们只需要知道 WY 表示:
连续多个 Householder 变换的乘积,可以紧凑地表示为低秩形式(WY representation):
$$H_1 H_2 \cdots H_m = I - W Y^\top$$
3.3 紧凑 WY 表示
考虑一个 chunk 内的转移矩阵乘积:
作者证明它可以表示成:
$$ P_r=I-\sum_{i=1}^{r}w_ik_i^\top. $$同时,chunk 内累积产生的状态增量可以写成:
$$ H_r=\sum_{i=1}^{r}u_ik_i^\top. $$这里的 $w_i$ 和 $u_i$ 都是 $d$ 维向量,而不是 $d\times d$ 矩阵。需要注意,本文在这里沿用符号 $u_i$,但它表示 chunk 内递推得到的局部量;它们满足如下递推:
$$ w_r=\beta_r\left(k_r- \sum_{i=1}^{r-1}w_i(k_i^\top k_r)\right), $$$$ u_r=\beta_r\left(v_r- \sum_{i=1}^{r-1}u_i(k_i^\top k_r)\right). $$直观上,$w_r$ 表示当前转移对之前 key 方向的累积影响,$u_r$ 表示经过之前 token 修正后的系数。
3.4 Chunkwise 状态分解
设一个 chunk 的初始状态为 $S_0$,第 $r$ 个 token 之后的状态为 $S_r$。利用上面的表示,可以写成:
$$ S_r=S_0P_r+H_r. $$代入 $P_r$ 和 $H_r$:
$$ S_r=S_0P_r+H_r. $$定义:
$$ \tilde u_i=u_i-S_0w_i, $$则:
$$ S_r=S_0+\sum_{i=1}^{r}\tilde u_ik_i^\top. $$这就是并行化的核心:
- chunk 之间只传递一个状态矩阵 $S_0$;
- chunk 内部通过矩阵运算并行计算 $W,U$;
- 不需要保存每一个 token 的中间状态矩阵;
- chunk 内的输出可以复用普通线性 attention 的 causal matmul 结构。
以矩阵形式表示,第 $c$ 个 chunk 的状态更新为:
$$ S_r=S_0+\sum_{i=1}^{r}\tilde u_ik_i^\top. $$其中 $Q_c,K_c,U_c,W_c\in\mathbb{R}^{C\times d}$。输出为:
$$ O_c =Q_cS_c+ (Q_cK_c^\top\odot M_C)(U_c-W_cS_c). $$第一项是 chunk 初始状态对当前 query 的贡献;第二项是当前 chunk 内部的 causal 贡献。
3.5 UT transform:把递推改写成矩阵运算
上面的 $w_r,u_r$ 定义仍然是 chunk 内递推形式。若直接执行,仍然不能充分利用 tensor cores。
作者进一步使用 UT transform。令:
$$ B=\operatorname{diag}(\beta), $$$$ L=\operatorname{tril}(BKK^\top,-1). $$那么 $W$ 满足:
$$ W+LW=BK. $$因此:
$$ T=(I+L)^{-1}B, \qquad W=TK, \qquad U=TV. $$论文把这一过程写为:
$$ T= \left(I+\operatorname{tril}(\operatorname{diag}(\beta)KK^\top,-1)\right)^{-1} \operatorname{diag}(\beta). $$因为 $I+L$ 是下三角矩阵,所以其逆不需要通用的昂贵矩阵求逆,而可以通过 forward substitution 高效求解。这样,主要计算就被组织成:
- $K K^\top$ 等矩阵乘法;
- 三角系统求解;
- $TK$、$TV$ 等矩阵乘法;
- chunk 内的 causal matmul。
这正是现代 GPU 更擅长的计算模式。
3.6 复杂度与硬件效率
对于 DeltaNet,recurrent 形式虽然 FLOPs 较少,但存在长串行依赖。本文的 chunkwise 形式的主要计算量沿用普通线性 attention chunkwise 算法的量级:
$$ O(LCd+Ld^2), $$而不需要为每个 token 物化 $d\times d$ 的状态。
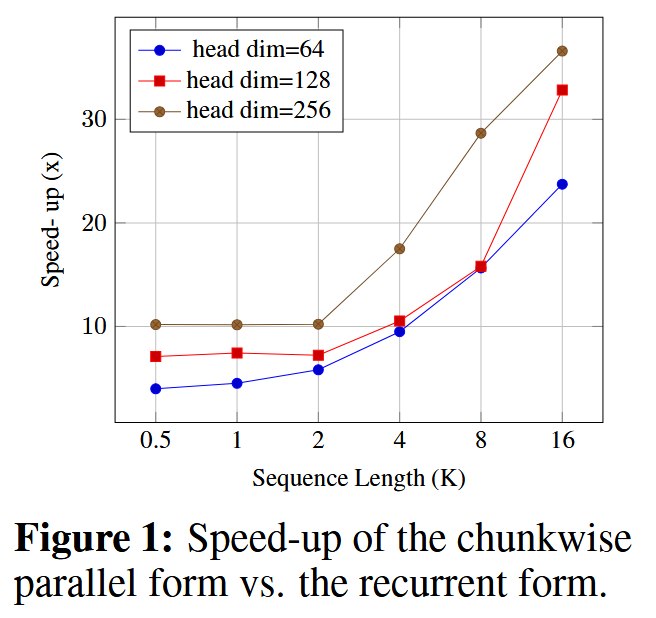
作者用 Triton 实现 recurrent kernel 和 chunkwise kernel,并在不同序列长度、head dimension 下进行速度比较。结论是:
- 序列越长,chunkwise 算法相对于 recurrent 算法的优势越明显;
- head dimension 越大,tensor-core 矩阵乘法的优势越明显;
- 新的 recurrent kernel 本身已经比 DeltaNet 原始 CUDA kernel 快约 2 倍;
- 训练时采用 backward recomputation 重新计算部分隐藏状态,以降低 GPU memory 占用。
这里的“并行化”需要准确理解:不是把所有时间步都变成一次无依赖的矩阵乘法,而是通过 chunk 内并行、chunk 间状态传递,把串行深度从 token 数量降到 chunk 数量,同时让主要工作落到高吞吐矩阵运算上。
3.7 完全并行形式:为什么论文没有采用
论文还给出了 DeltaNet 的 fully parallel form 作为补充。由递推展开式可以构造一个因果“attention”矩阵,使输出写成类似:
$$ A_{ij}=k_j^\top P_{j+1}^{i}q_i \quad (j\le i), \qquad A_{ij}=0 \quad (j>i), $$并可形式化为:
$$ A=(QK^\top\odot M)T. $$问题在于,计算这里的三角变换矩阵 $T$ 需要对长度为 $L$ 的下三角矩阵求逆;若没有进一步的算法改造,其代价随序列长度呈立方增长。因此,论文没有把 fully parallel form 用作实际训练方案,而选择 chunkwise parallel:在 chunk 内使用矩阵运算,在 chunk 之间传递状态。
这一点很重要:本文的贡献不是声称 DeltaNet 已经变成了“零递归”的普通 attention,而是找到了一种更适合 GPU 的分块执行方式。
3.8 DeltaNet Transformer 的具体架构
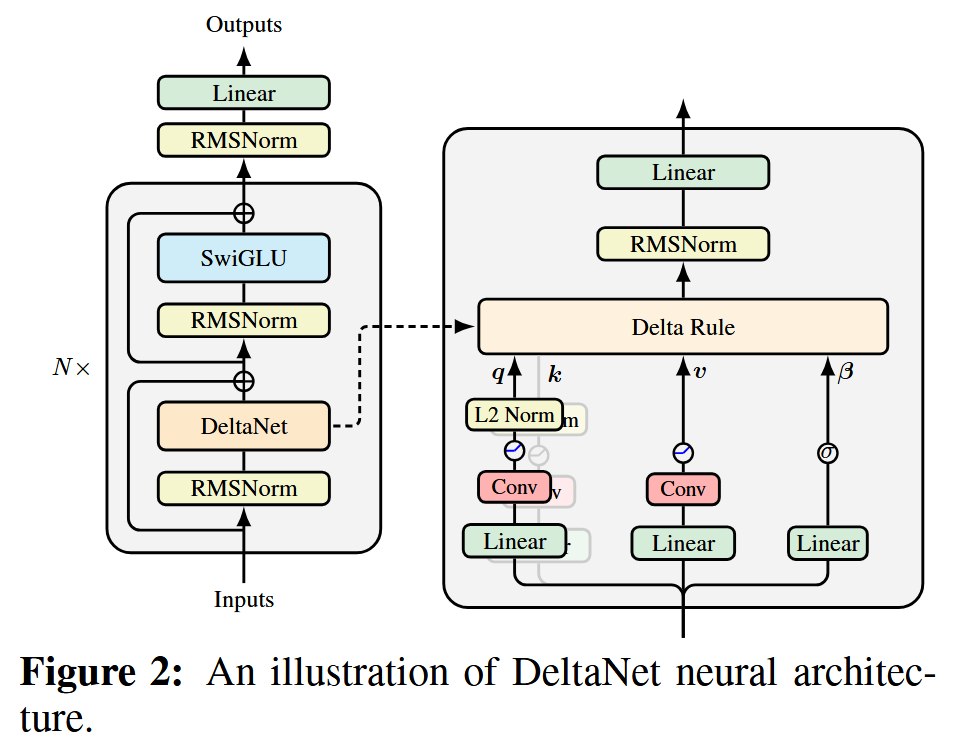
作者按照 LLaMA/Transformer++ 风格构建模型,用 DeltaNet layer 替换 self-attention layer,保留标准的 FFN/SwiGLU 组件。
主要设计如下:
Query/key feature map
$$ k_t= \frac{\operatorname{SiLU}(W_Kx_t)} {\|\operatorname{SiLU}(W_Kx_t)\|_2}, \qquad q_t= \frac{\operatorname{SiLU}(W_Qx_t)} {\|\operatorname{SiLU}(W_Qx_t)\|_2}. $$与早期 DeltaNet 使用的 (1+\operatorname{ELU}) 和 L1 normalization 相比,本文发现 SiLU 加 L2 normalization 效果更好。
Writing strength
$$ \beta_t=\sigma(W_\beta x_t). $$它是一个标量写入强度,决定当前 token 对记忆的修改程度。
为什么 L2 normalization 很重要
状态转移矩阵为:
$$ I-\beta_tk_tk_t^\top. $$其特征值为:
- $1$,重数为 $d-1$;
- $1-\beta_t\|k_t\|_2^2$,沿 $k_t$ 方向。
使用 L2 normalization 后,$\|k_t\|_2=1$,因此第二个特征值为 $1-\beta_t\in[0,1]$。这使状态转移更加稳定。
特别地,当 $\beta_t=1$ 时:
$$ I-k_tk_t^\top $$是一个投影矩阵:擦除 $k_t$ 方向的信息,同时保留正交子空间的信息。它体现了 DeltaNet 的 targeted forgetting。
Short convolution
在主要语言模型实验中,作者在 query/key/value projection 后加入 kernel size 为 4 的 depthwise-separable short convolution。它提供局部 token mixing,弥补纯线性递归层对局部位移和精确局部比较建模能力的不足。
Normalization 与参数量
模型使用 pre-normalization 和 output projection 前的 RMSNorm,以提高训练稳定性。DeltaNet layer 的参数量大约为 (4d^2),SwiGLU FFN 约为 $8d^2$,与 Transformer++ 的参数分配大致相当。
3.9 两种 Hybrid Model
作者认为 DeltaNet 和 softmax attention 具有互补能力,因此设计了两种混合模型:
- DeltaNet + Sliding-Window Attention:交替使用 DeltaNet layer 和 sliding-window attention layer,通常每隔一层加入局部 attention。
- DeltaNet + Global Attention:只把两层替换为 full global attention,位置为第 2 层和第 $N/2+1$ 层。
动机是:
- DeltaNet 擅长低成本的内容寻址和长期关联记忆;
- sliding-window attention 擅长局部 token shift、局部比较和位置相关模式;
- 少量 global attention 可以提供稀疏但精确的全局交互。
这是一种很有代表性的设计哲学:不要求单一 token-mixing primitive 独自解决所有问题,而是组合不同机制的优势。
四、实验
4.1 实验问题
论文主要回答以下问题:
- 新算法是否真的比严格串行的 DeltaNet 训练更快?
- DeltaNet 是否在合成 associative recall 任务上优于其他线性递归模型?
- Delta Rule 的优势能否迁移到较大规模语言模型?
- DeltaNet 是否能改善 recall-intensive 的真实任务?
- sliding attention 或少量 global attention 是否能进一步补足 DeltaNet 的短板?
- feature map、normalization 和 convolution 等设计选择有多重要?
4.2 合成任务
作者使用三个合成 benchmark:
- MQAR:Multi-Query Associative Recall,测试上下文中存在多个 key-value 对时的关联检索能力;
- MAD:Mechanistic Architecture Design,包含多种 token manipulation 和 memory 任务;
- RegBench:In-context language learning,要求模型从上下文中推断由 probabilistic finite automaton 生成的语言。
MQAR
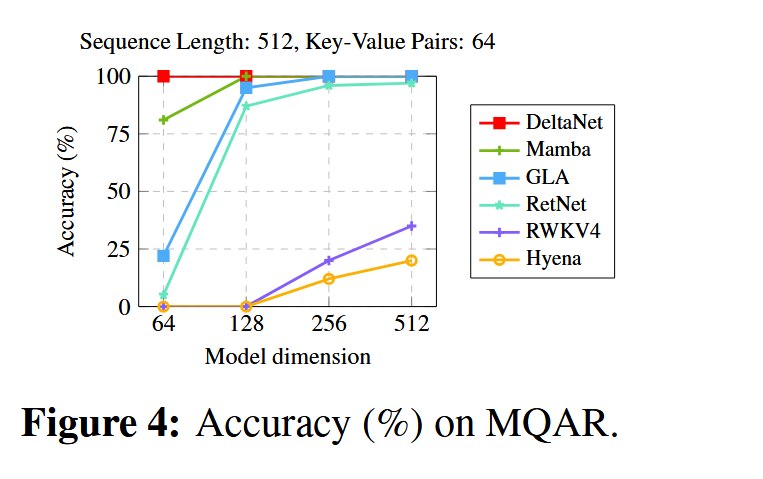
在 MQAR 中,DeltaNet 使用 2 个 heads,且不使用 convolution。论文报告:
- 在最困难的设置下,DeltaNet 达到接近完美的准确率;
- 在较低 model dimension 下,DeltaNet 优于使用 convolution 的 Mamba;
- 这表明 Delta Rule 本身,而不是 short convolution,是其 associative recall 能力的重要来源。
MAD
论文给出的 MAD 结果如下,数值为 accuracy(%):
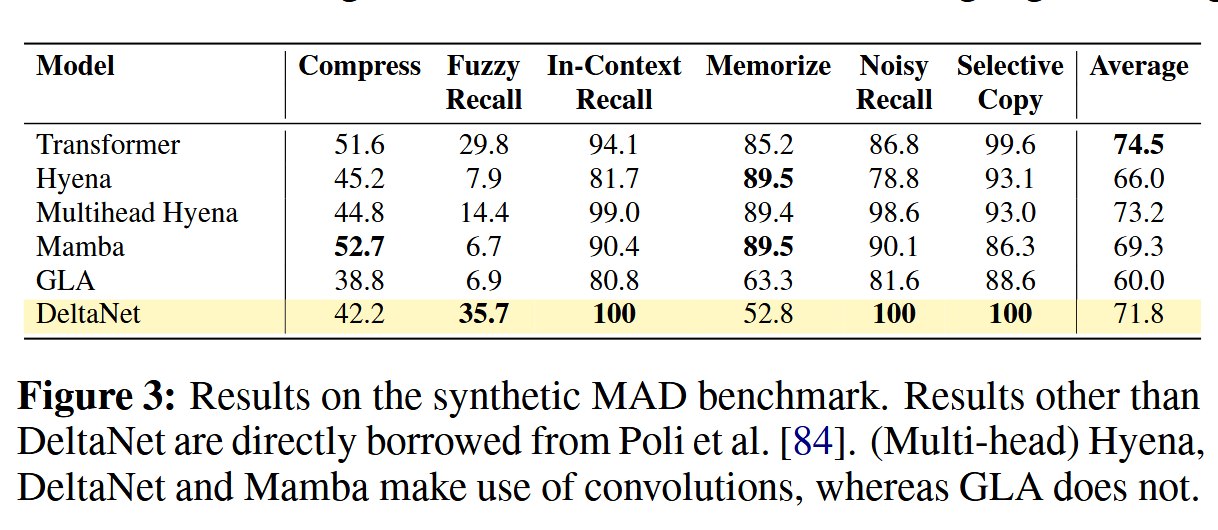
解读:
- DeltaNet 在 Fuzzy Recall 上明显最好,这与其根据预测误差进行纠错的机制一致;
- In-Context Recall、Noisy Copy 和 Selective Recall 达到 100%;
- DeltaNet 在 Memorize 上反而较弱,说明“更擅长根据 key 精确更新”不等同于在所有记忆任务上都占优;
- 平均分不是最高,说明不同合成任务考察的是不同能力,不能只用一个平均数评价模型。
RegBench
每个输入包含 10 到 20 个由不同 PFA 生成的字符串。模型需要在上下文中推断当前语言规则,然后预测测试序列中的下一个 token。
论文的 Figure 7 显示,DeltaNet 在不同数量的 training examples 下表现很强,整体优于或接近 Transformer++、GLA 和 Mamba 等基线。这支持了 DeltaNet 对 in-context rule induction 的适应能力。
4.3 语言建模设置
主要设置如下:
| 项目 | 340M 模型 | 1.3B 模型 |
|---|---|---|
| 训练 tokens | 15B | 100B |
| batch size | 0.5M tokens | 2M tokens |
| peak learning rate | $3\times10^{-4}$ | $3\times10^{-4}$ |
| warm-up | 0.5B tokens | 1B tokens |
| optimizer | AdamW | AdamW |
| weight decay | 0.01 | 0.01 |
| gradient clipping | 1.0 | 1.0 |
| DeltaNet head dimension | 128 | 128 |
| convolution kernel size | 4 | 4 |
| hardware | 8 H100 | 8 H100 |
训练使用 SlimPajama 子集和 Mistral tokenizer,学习率采用 cosine schedule,初始和最终学习率均为 $3\times10^{-5}$。
评测包括:
- WikiText perplexity;
- LAMBADA;
- PIQA、HellaSwag、WinoGrande;
- ARC-Easy、ARC-Challenge;
- recall-intensive 任务 SWDE、SQuAD、FDA。
其中:
- SWDE 从原始 HTML 中提取半结构化关系;
- FDA 从 PDF 中检索 key-value 对;
- SQuAD 测试阅读理解和基于 passage 的问题回答。
4.4 主要语言模型结果
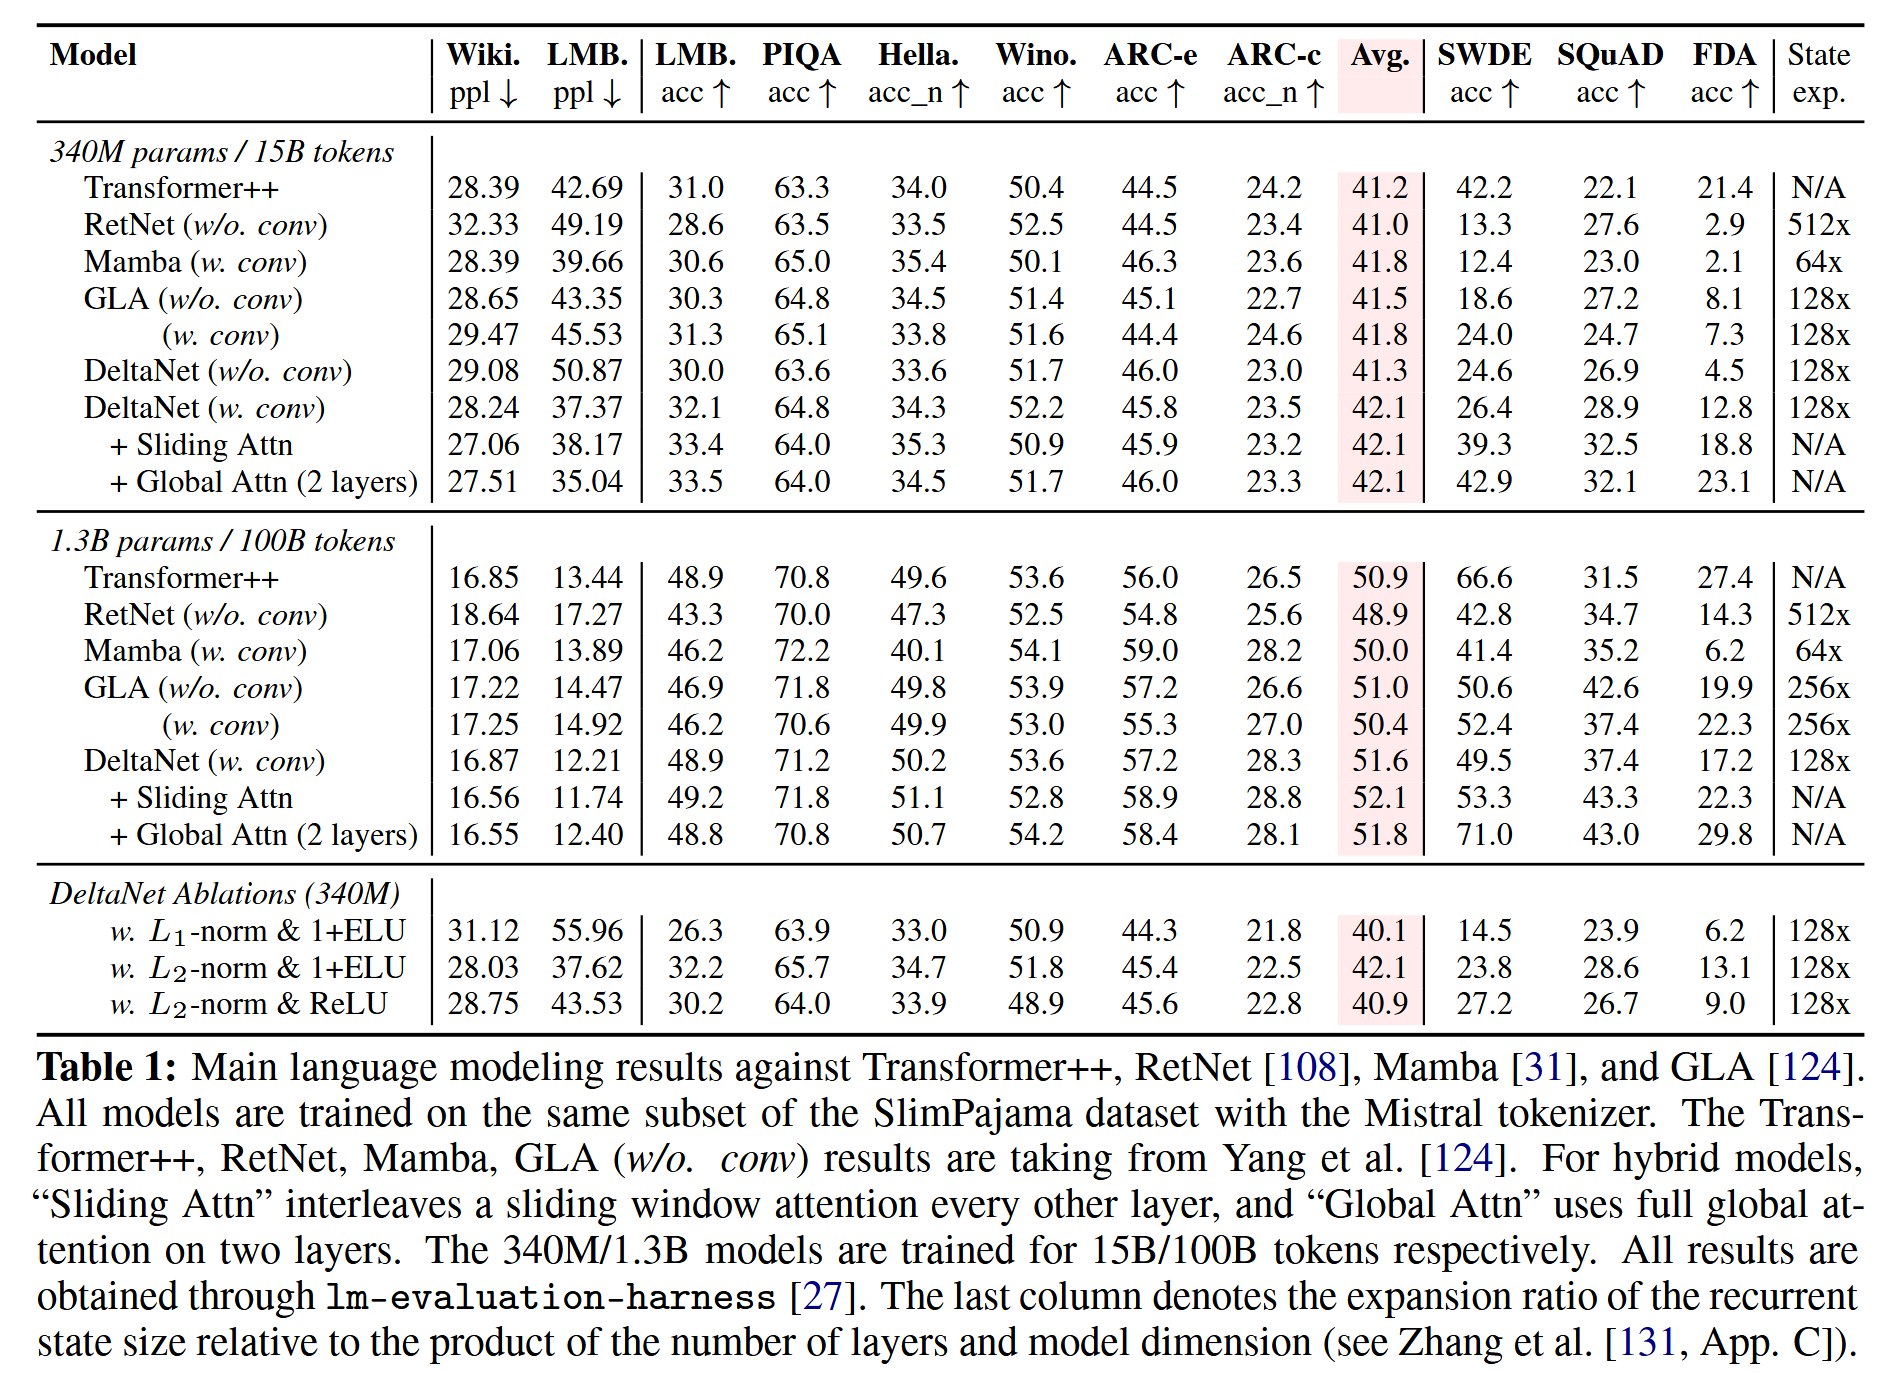
以下重点列出 DeltaNet 及其 hybrid 与 Transformer++ 的关键结果。PPL 越低越好,其余为 accuracy,越高越好。
340M / 15B tokens
| Model | Wiki PPL | LAMBADA PPL | LAMBADA acc | Commonsense Avg. | SWDE | SQuAD | FDA |
|---|---|---|---|---|---|---|---|
| Transformer++ | 28.39 | 42.69 | 31.0 | 41.2 | 42.2 | 22.1 | 21.4 |
| GLA + conv | 29.47 | 45.53 | 31.3 | 41.8 | 24.0 | 24.7 | 7.3 |
| DeltaNet + conv | 28.24 | 37.37 | 32.1 | 42.1 | 26.4 | 28.9 | 12.8 |
| DeltaNet + Sliding Attn | 27.06 | 38.17 | 33.4 | 42.1 | 39.3 | 32.5 | 18.8 |
| DeltaNet + Global Attn | 27.51 | 35.04 | 33.5 | 42.1 | 42.9 | 32.1 | 23.1 |
主要观察:
- 纯 DeltaNet + conv 的 WikiText PPL、LAMBADA PPL 和 LAMBADA accuracy 都优于 Transformer++;
- 两种 hybrid 在 WikiText、LAMBADA 和 recall-intensive 任务上改善明显;
- 仅加入两层 global attention,就把 FDA 从 12.8 提高到 23.1;
- sliding attention 对 SWDE 和 SQuAD 有明显帮助,但在 FDA 上不如 global attention。
1.3B / 100B tokens
| Model | Wiki PPL | LAMBADA PPL | LAMBADA acc | Commonsense Avg. | SWDE | SQuAD | FDA |
|---|---|---|---|---|---|---|---|
| Transformer++ | 16.85 | 13.44 | 48.9 | 50.9 | 66.6 | 31.5 | 27.4 |
| GLA + conv | 17.25 | 14.92 | 46.2 | 50.4 | 52.4 | 37.4 | 22.3 |
| DeltaNet + conv | 16.87 | 12.21 | 48.9 | 51.6 | 49.5 | 37.4 | 17.2 |
| DeltaNet + Sliding Attn | 16.56 | 11.74 | 49.2 | 52.1 | 53.3 | 43.3 | 22.3 |
| DeltaNet + Global Attn | 16.55 | 12.40 | 48.8 | 51.8 | 71.0 | 43.0 | 29.8 |
主要观察:
- 纯 DeltaNet 在 PPL 和大多数 commonsense 指标上具有很强竞争力;
- sliding-attention hybrid 的 WikiText 和 LAMBADA PPL 最好;
- global-attention hybrid 在 SWDE、FDA 等需要全局精确检索的任务上最强;
- 对 recall-intensive 任务而言,混入少量 global attention 的收益非常明显;
- 但不同 hybrid 的优势并不完全一致,说明局部 attention 和全局 attention 解决的是不同问题。
4.5 DeltaNet、GLA 与 state size 的关系
这是本文实验中最重要的限定条件之一。
在 340M 规模、使用相同 convolution 设置且 state size 相近时,DeltaNet 在 SWDE、SQuAD、FDA 等 recall-intensive 任务上优于 GLA,验证了 Delta Rule 的记忆更新优势。
但在 1.3B 规模时,DeltaNet 在这些任务上不再全面优于 GLA。作者解释为:DeltaNet 的 state size scalability 较差,而 recall-intensive 任务高度依赖记忆状态容量。
从表 1 的 state expansion ratio 可以看到:
- 340M 实验中 GLA 和 DeltaNet 大致为 $128\times$;
- 1.3B 实验中 GLA 可达到 $256\times$,而 DeltaNet 为 $128\times$。
因此,不能简单得出“Delta Rule 永远优于 gated decay”。更准确的结论是:
在相同状态容量下,Delta Rule 对关联检索有优势;但如果另一种模型能够以更低代价使用更大的state,扩大状态容量可能抵消甚至超过 Delta Rule 的优势。
这也是经常权衡的一点,如果一个方法很复杂效果很好,另一个方法比较简单,效果差一点点但是可以scale,那么我完全可以直接scale第二个方法就能达到很好的效果。
4.6 3B 模型扩展
作者还训练了 3B DeltaNet,使用 1T tokens。
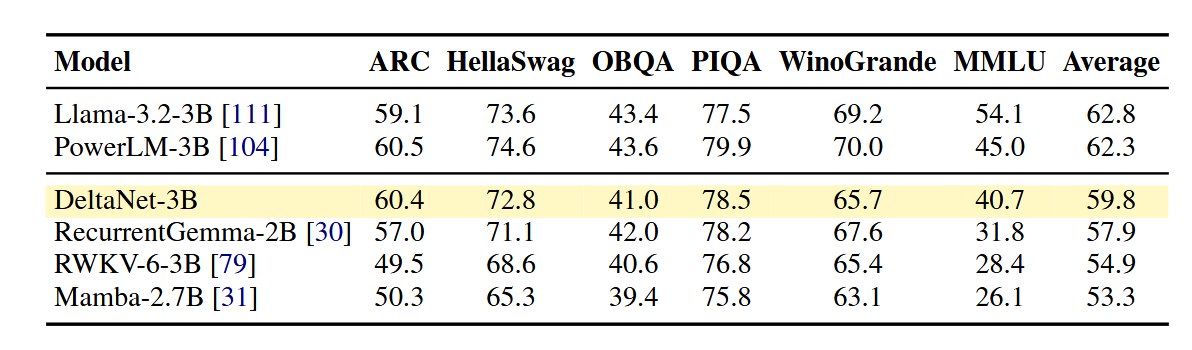
DeltaNet-3B 略低于在相同设置下训练的 Transformer PowerLM-3B,但高于其他 2B–3B 范围内的 recurrent baseline。由于各模型训练 token 数和训练设置并不完全相同,这一比较只能作为参考,不能当作严格的 scaling law 结论。
4.7 Ablation:feature map 与 normalization
作者在 340M DeltaNet 上比较不同 feature map 和 normalization:
| 设置 | Wiki PPL | LAMBADA PPL | Commonsense Avg. | SWDE | SQuAD | FDA |
|---|---|---|---|---|---|---|
| L1 norm + (1+ELU) | 31.12 | 55.96 | 40.1 | 14.5 | 23.9 | 6.2 |
| L2 norm + (1+ELU) | 28.03 | 37.62 | 42.1 | 23.8 | 28.6 | 13.1 |
| L2 norm + ReLU | 28.75 | 43.53 | 40.9 | 27.2 | 26.7 | 9.0 |
| L2 norm + SiLU | 28.24 | 37.37 | 42.1 | 26.4 | 28.9 | 12.8 |
更准确的结论是:
- 从 L1 normalization 换成 L2 normalization 带来巨大收益;
- 在 L2 normalization 下,SiLU 在 LAMBADA、SWDE 和 SQuAD 等指标上表现突出,但 (1+ELU) 在 WikiText PPL 与 FDA 上更好,因此不能概括为 SiLU 在所有指标上都最优;
- normalization 不只是数值稳定性的实现细节,而是 DeltaNet 性能的重要组成部分。
4.8 Training throughput
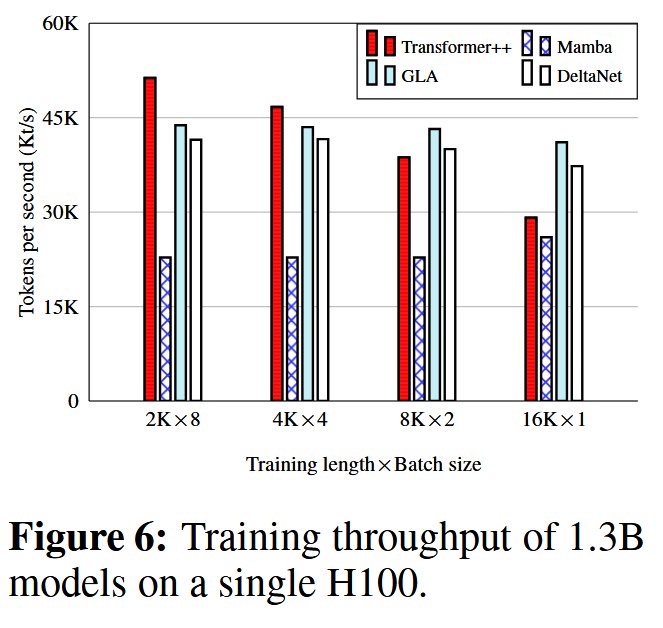
在单张 H100 上,作者比较不同 1.3B 模型的训练吞吐:
- DeltaNet 的训练速度接近 GLA;
- DeltaNet 明显快于 Mamba;
- 对较长序列,所有 linear-time 模型都比 Transformer++ 更快;
- 但 DeltaNet 仍然没有超过 GLA。
这与论文后面的 limitation 一致:DeltaNet 的状态到状态依赖更复杂,需要在 kernel 内处理 head dimension 上的 marginalization,因此比完全 elementwise 的 GLA 更难做高效 tiling。
五、讨论与相关工作
5.1 DeltaNet 与 State Space Model / Linear RNN 的统一视角
作者把许多线性递归模型写成:
$$ S_t=S_{t-1}\bullet M_t+v_tk_t^\top, \qquad o_t=S_tq_t, $$其中 $\bullet$ 可以是:
- elementwise Hadamard product,例如 GLA、Mamba 的部分形式;
- 普通矩阵乘法;
- 其他 associative operator。
从这个角度看:
- 普通 linear attention 的转移接近 identity;
- RetNet 使用固定 decay;
- GLA 使用 data-dependent diagonal decay;
- Mamba 使用 selective state-space decay;
- DeltaNet 使用 $I-\beta_tk_tk_t^\top$ 这样的结构化矩阵转移。
大多数近期模型选择便宜的 elementwise recurrence,因为它的更新成本为 (O(d)),容易 tiling;DeltaNet 使用 structured matrix recurrence,能表达更丰富的状态内交互,但硬件实现更难。
5.2 为什么 DeltaNet 更难做大状态
若 $S_t$ 是 $d\times n$ 矩阵,而转移矩阵是任意 $n\times n$ 矩阵,则每步更新可能需要 $O(dn^2)$,过于昂贵。
这个n不要联想序列长度,没甚么关系就是个记号(
DeltaNet 通过:
$$ M_t=I-\beta_tk_tk_t^\top $$这种 identity 加 rank-one 结构,在计算量和表达能力之间折中。它比 elementwise decay 更强,但仍然受 head dimension 和 GPU SRAM 的限制。
那么当我们做大状态,GPU上每个SM的SRAM很容易撑爆,然后就只能往HBM上放,这样速度直接慢了。
作者提出的一个未来方向是使用 block-diagonal generalized Householder transition:每个 block 的大小适配 GPU SRAM,例如 128,同时让整体 head dimension 保持较大,从而增加状态容量。
5.3 与 online learning 的关系
Delta Rule 直接对应在线回归的单步梯度下降,因此 DeltaNet 可以被理解为一种带有 fast weight memory 的 online learner。
这一视角也把它和后续的 TTT、Longhorn、Titans 等工作联系起来:这些模型都在探索“模型如何在处理上下文时临时学习”。不过,本文的重点仍然是能够高效并行训练的线性递归形式,而不是引入更复杂的非线性 recurrent update。
5.4 Householder/WY 表示的作用
Householder 矩阵在 numerical linear algebra、normalizing flow 和正交 RNN 中经常出现。本文借用了“用紧凑向量集合表示一连串 rank-one 变换”的思想,但目标不同:
- 不是为了构造显式正交变换;
- 不是为了做 normalizing flow;
- 而是为了避免 DeltaNet 在训练时物化每个时间步的矩阵状态,并把计算改写成 GPU 友好的形式。
六、 局限性与未来方向
6.1 训练速度仍落后于 GLA
这是论文最直接的工程局限。GLA 的递归主要是 elementwise 操作,容易用 tiling 支持任意 head dimension;DeltaNet 则有状态到状态的依赖,需要在 kernel 内部处理更复杂的维度交互。
结果是:
- DeltaNet 已经比原始串行实现高效很多;
- 但仍慢于 GLA;
- 这可能限制可使用的 head dimension 和 recurrent state size;
- 最终又会反馈到 recall-intensive task 的性能。
6.2 长度外推能力有限
作者发现 DeltaNet 的 length generalization 不如 GLA、RetNet,某种程度上也不如 Mamba。
一个可能原因是 DeltaNet 没有显式 decay factor。它可以针对 key 方向进行忘却,但缺少随着时间自然衰减的机制。未来可以在 Delta transition 外加入 gating/decay,例如 gated DeltaNet 风格的:
$$ S_t=S_{t-1}\alpha_t(I-\beta_tk_tk_t^\top)+\beta_tv_tk_t^\top. $$6.3 Delta Rule 的表达能力并非无限
相关工作已经指出,Delta update rule 在表达能力上存在理论限制。更强的 Recurrent DeltaNet、Modern Self-Referential Weight Matrix、mesa-layer 等方法可能获得更强能力,但它们往往超出简单线性 RNN 范畴,且不能直接使用本文的 sequence-parallel 算法。
这暗示一个基本 trade-off:
$$ \text{表达能力} \quad\leftrightarrow\quad \text{sequence parallelism / hardware efficiency}. $$7.4 未来方向:跨 chunk 非线性、chunk 内线性
作者提到 TTT 等工作采用跨 chunk nonlinear、chunk 内 linear 的策略。这可能在不完全牺牲并行性的前提下,突破 DeltaNet 当前的表达能力限制。
当然,现在已经26年了,一堆工作已经涌现出来了(
说些什么吧!