<!--more--> ## 零、写在前面 这篇主要就是在 LLaVA 框架下,通过少量但关键的设计改动,可以得到一个更强、更简单、数据效率更高的 Large Multimodal Model baseline,即 **LLaVA-1.5**。 ## 一、摘要 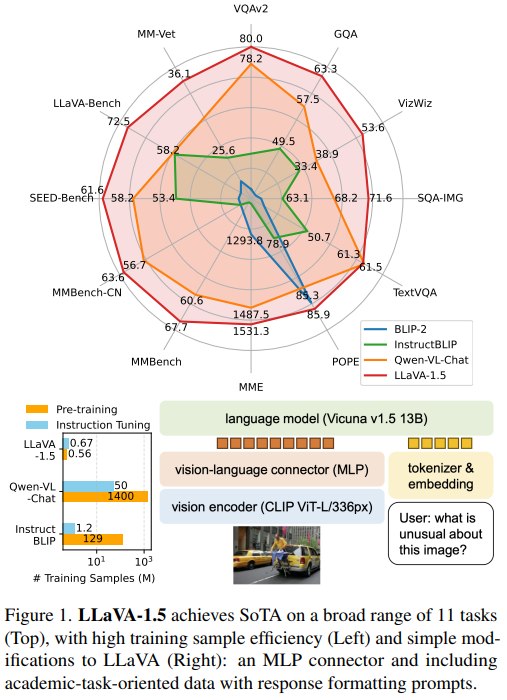 Abstract 针对 LMM 研究中的一个关键问题:现有方法越来越复杂,训练数据和算力规模越来越大,但哪些设计因素真正重要并不清楚。 …
<!--more--> ## 零、写在前面 > 无端联想:[【硬核科普】从零开始认识显卡](https://www.bilibili.com/video/BV1xE421j7Uv/?spm_id_from=333.337.search-card.all.click&vd_source=a7ce6b38365a0cb2ad96f0668de0bc51) lecture05 主要就是讲了讲GPU的架构,以及一些性能敏感的计算技巧。 ## 一、GPUs、TPUs ### 1.1 为什么 LLM 时代必须理解 GPU? > ** …
<!--more--> ## 零、写在前面 LLaVA 把 text-only LLM 中已经成功的 `instruction tuning` 思路迁移到 image-language 场景,提出 `visual instruction tuning`,并证明:用 GPT-4 生成的 multimodal instruction-following data,加上一个简单的 CLIP-to-Vicuna projection layer,就能训练出具备较强视觉对话和视觉指令跟随能力的开源模型。 **证明了 visual instruction tuning 是构建开源 LVLM 的 …
<!--more--> ## 零、写在前面 lecture04主要围绕两个主题: 1. **Attention alternatives:注意力机制的替代方案** - 为什么标准 attention 在长上下文下很贵? - Linear Attention、Mamba-2、Gated Delta Net、Sparse Attention 等思路如何降低成本? - 为什么很多新模型采用 attention + alternative module 的混合架构? 2. **Mixture of Experts,MoE:专家混合模型** - MoE 是什 …
<!--more--> ## 零、写在前面 B站上有论文一作作者做的汇报:[MiniGPT-4、表格推理、代码生成、生成式推理-来自斯坦福、北大、阿卜杜拉、达摩院的四位论文一作思辨大模型](https://www.bilibili.com/video/BV1n24y1F7kv/?spm_id_from=333.337.search-card.all.click)。大概十几分钟就能了解清楚本文的动机、技术路线。 MiniGPT-4 和 BLIP-2 的架构几乎一样,只是把llm侧用了更强的**Vicuna**(一个基于 LLaMA 微调的开源模型)。 本文提出 把一个 frozen …
<!--more--> ## 零、写在前面 BLIP-2 认为之前的VLP工作,把下游任务SOTA刷的越来越高,但是每次都要从零训练,而且成本也越来越高。所以通过引入QFormer,只需要训练QFormer,就可以把现成的视觉模型和语言模型拼在一起协同工作。 QFormer把图像压缩成几个关键的可学习的query,然后把这些query投影到语义空间,拼接在prompt前面喂给llm,从而引导语言模型看图说话。 这几天看了一车多模态的论文,本来要读 Qwen-VL、LLaVA、MiniGPT的,但发现前面这些多模态工作还真挺有必要看一下的。这个BLIP-2 证明了在 frozen …
<!--more--> ## 零、前言 BLIP 将ALBEF 和 VLMO进行结合,做了个多模态 encoder 和 decoder 的混合架构。 比较有趣的是本文提出的CapFilt,可以对noisy 的 web img-text 数据过滤,并且生成高质量的caption从而得到更好的数据集,这些数据集可以拿来继续训练BLIP或者其他的模型,引发了一系列工作。 ## 一、标题 > BLIP: Bootstrapping Language-Image Pre-training for Unified Vision-Language Understanding …
<!--more--> ## 零、写在前面 VLMo主要就是试图 dual encoder 和 多模态融合的 fusion encoder 到一个架构里面,然后基于此又提出一个预训练策略,取得了很好的效果。 ## 一、标题 > VLMO: Unified Vision-Language Pre-Training with Mixture-of-Modality-Experts VLMO有两点改进: 1. 模型结构上的改进:Mixture-of-Modality-Experts 2. 训练方式上的改进:分阶段的模型预训练 ## 二、 …
<!--more--> ## 零、写在前面 不同于之前读的ViLT从优化推理速度出发,ALBEF的出发点是,直接把text token 和 image token 扔给transformer做多模态融合的时候,图像特征和文本特征还没align(对齐),所以它提出在多模态融合之前我们就做图文align,然后还对web上的noise数据提出了一个解决策略,和MoCo那篇文章有点像,用一个momentum model来生成pseudo target,来达到自训练的结果。 ## 一、标题 > Align before Fuse: Vision and Language …
<!--more--> ## 零、写在前面 ViLT 的工作比较简单,就是在ViT的基础上,把图像patch得到的embedding和文本token拼接直接扔给transformer做多模态融合,效果还可以。然后还挖了一些坑,因为当时比如说MAE哪些它还没来得及用,不过这些坑很快就填上了。 这篇写的有点综述的意思,对以前的 vision-language 的工作做了很详细的总结。 ## 一、标题 > ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision ViLT …