<!--more--> ## 零、写在前面 做assignment2之前还是有必要听一下前面几个lecture或者看一下讲义的,慢慢积累。 至少需要了解这些内容: [注意力替代方案与MoE](https://blog.equinox.wiki/post/cs336/%E6%B3%A8%E6%84%8F%E5%8A%9B%E6%9B%BF%E4%BB%A3%E6%96%B9%E6%A1%88%E4%B8%8Emoe/) [GPUs and TPUs](https://blog.equinox.wiki/post/cs336/gpus-and-tpus/) …
<!--more--> ## 零、写在前面 ## 一、摘要 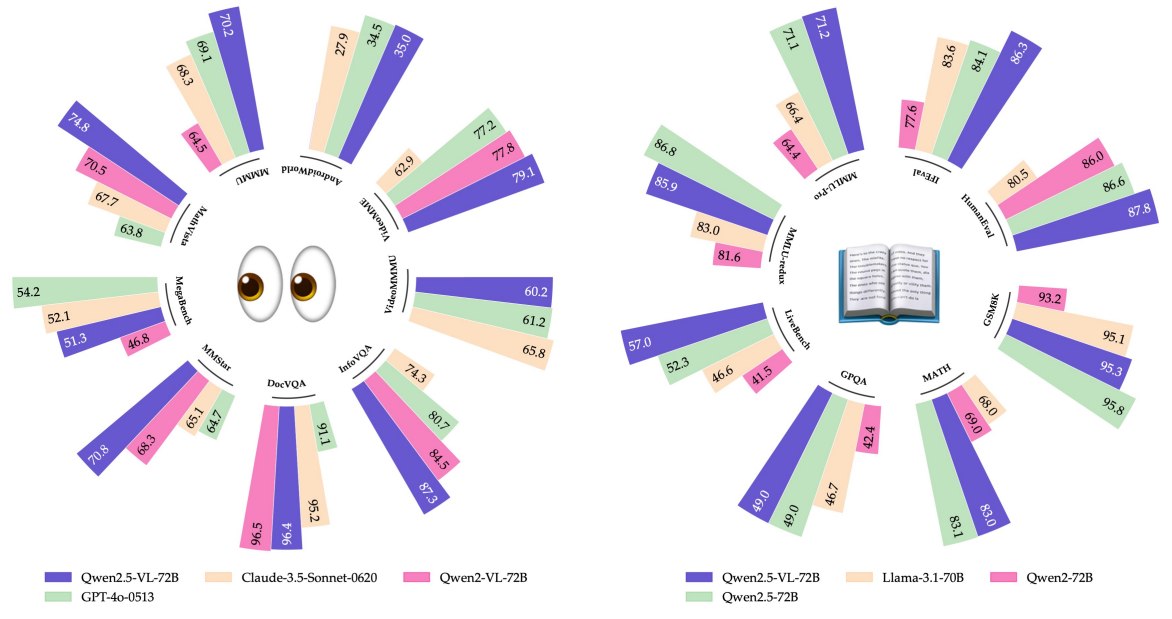 摘要把 Qwen2.5-VL 定位为 Qwen vision-language 系列的最新旗舰模型,强调它在基础能力和新功能上都有提升。核心能力包括: - 更强的视觉识别与细粒度感知; - 使用 bounding boxes 或 points 进行精确 object localization; - …
<!--more--> ## 零、写在前面 Qwen2-VL做了以下升级:动态分辨率、跨模态位置编码、视频统一建模和 scaling。 ## 一、摘要 Qwen2-VL 被定义为 Qwen-VL 系列的升级版,**核心目标是突破传统视觉处理中的固定分辨率范式**。摘要中强调了三个主要技术点: 1. **Naive Dynamic Resolution**:模型可以根据图像原始分辨率动态生成不同数量的 visual tokens,而不是把所有图像强制缩放到同一固定尺寸。 2. **Multimodal Rotary Position Embedding, …