
零、写在前面
现在对于 agent memory 外部方案的质疑声音还是比较多的,一周之内连着三篇论文做了同一件事情:外部方案在很多bench上打不过 rag。
!?爆了?!
这个个人感觉确实,很多方案的规则设计只是在特定场景上会取得增益,但是实际生产环境我们还是要做 trade-off 的,很多时候都是做混合方案来互相兜底。不过很多 memory 方案确实很水就是了。
有一个大家都没有很好处理的问题就是,agent 场景下,对话历史膨胀很快且多轮对话内容高度相似,那么 memory 的写入也会比较频繁,记忆也会面临膨胀、噪声,top-k 检索召回一堆相似的内容。
本文的角度就是:在用户偏好可能变化、历史对话充满相似冗余时,如何判断是否需要访问记忆,并找出真正能够改变当前答案的那几条历史证据?
一、标题
来源:NeurIPS 2026
二、背景
2.1 相似 ≠ 有用
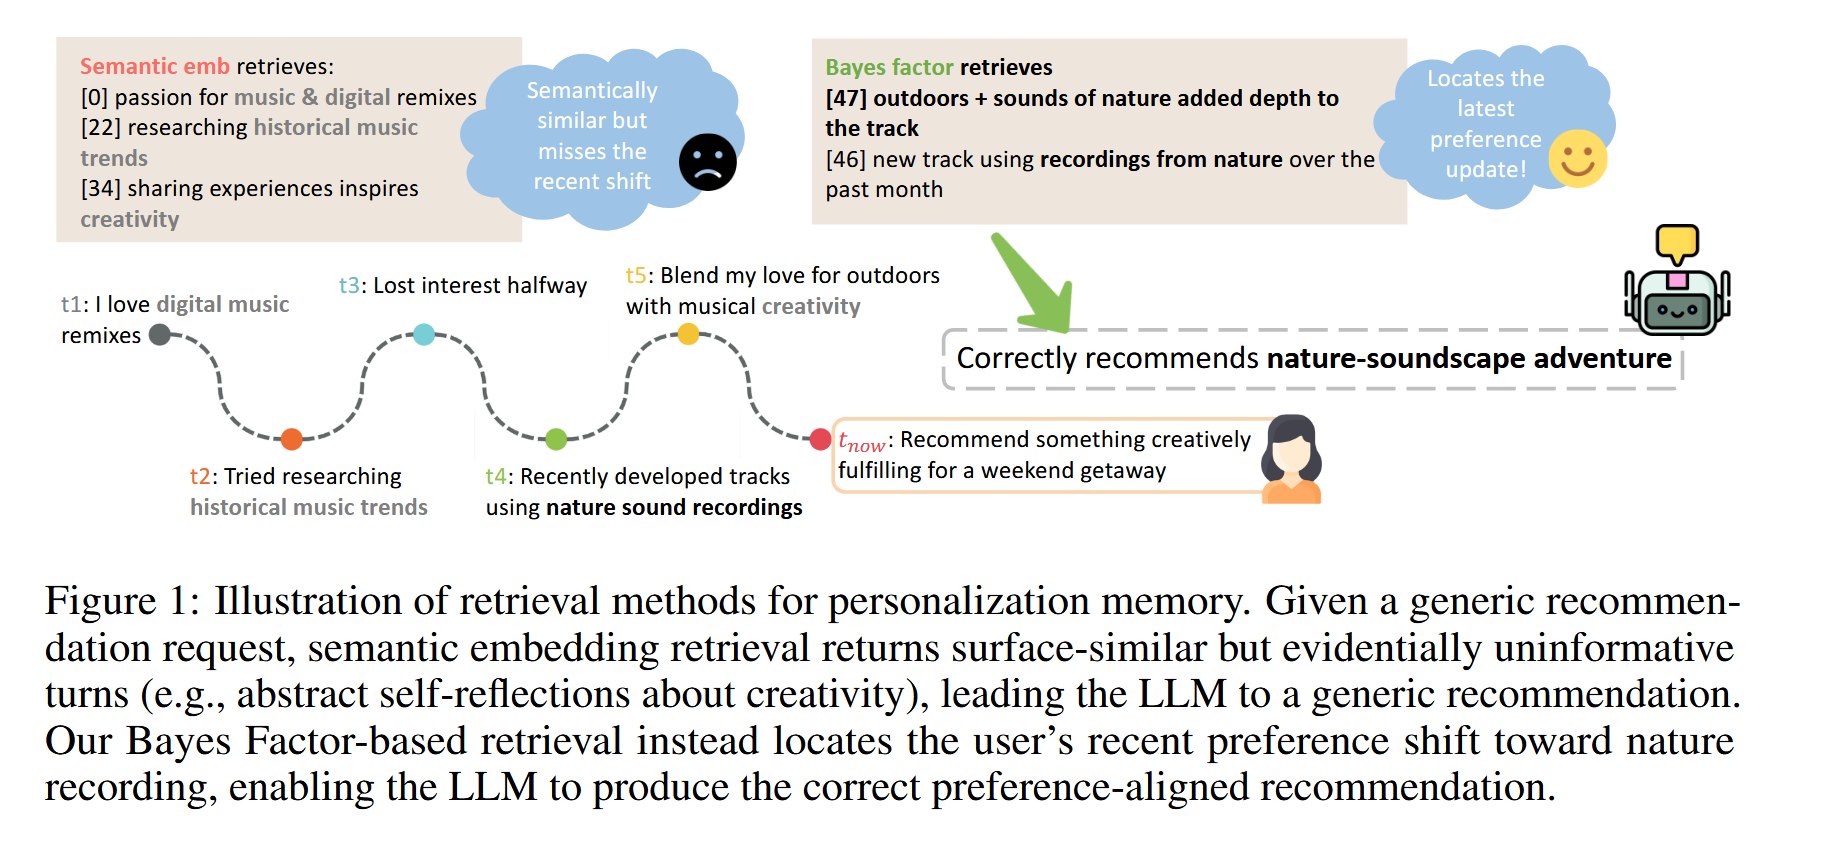
老生常谈的问题,向量相似不代表语义相关。所以做memory我们需要丰富的监督信号,比如 时间、置信度等等……
2.2 相关工作
| 类别 | 代表工作 | 本文指出的不足 / 差异 |
|---|---|---|
| 外部记忆管理 | MemGPT、MemoryBank | 解决外部存储和上下文窗口问题,但不直接优化当前答案效用。 |
| 记忆抽取与整合 | Mem0、A-MEM | 抽取个人事实或做结构化整合;检索仍主要依赖语义相似。 |
| 反思与多粒度记忆 | RMM | 通过反思摘要改进粒度;最终仍用 Embedding 找证据。 |
| 上下文效用信号 | RECOMP、CODEFILTER、PMI in RAG | 使用生成器反馈或概率增益评估上下文;本文将其引入个人记忆检索及触发学习。 |
相关工作里面,比较有趣的就是这个 上下文效用信号,其实就是为了丰富检索信号,我们可以利用上下文来构造一些可能有利于我们检索的信号。
三、方法
3.1 问题定义
历史 $H=(c_1,…,c_T)$,当前问题 q,标准答案 a。目标是在历史 H 中选择一个子集 F,使 Reader 在给定 (q,F) 时答对。两个子任务分别是“要不要取记忆”和“取哪几条”。
3.2 Stage 1:训练期答案条件 $Sal_a$ 作为效用标签
$$ Sal_a(c_i | q,a) = log \ p(a | q,c_i) − log \ p(a | q) $$log Bayes factor:把一条历史记忆加入问题后,模型对标准答案 a 的对数似然提高了多少?值为正,表示该条在该评分模型下支持 gold answer;为负则表示可能误导。
$$ S_τ = { c_i ∈ H : Sal_a(c_i | q,a) > τ } $$根据阈值 $\tau$ 把连续分数离散成“应该被记住 / 不该被读入”的银标签(silver labels);再从高分候选中保留重点 evidence,用于训练 Controller 与 Reader。
3.3 Stage 2:在线不能看到答案,改用 $Sal_q$ 粗筛
$$ Sal_q(c_i;q) = log \ p(q | c_i) − log \ p(q) $$在线拿不到正确答案 a,于是使用“看到一条历史后,这个查询 q 的概率提升了多少”作为查询侧可计算的代理信号。 关键设计是把它用作 Top-K pre-filter。
3.4 Stage 3:阈值 Gate + 重点候选
$$ g_τ(H,q) = 1[ |S_τ(H,q)| > 0 ] $$如果没有高于阈值的有效证据,gate 为 0;否则选择至多 k=5 条 focus 供 Reader 使用。
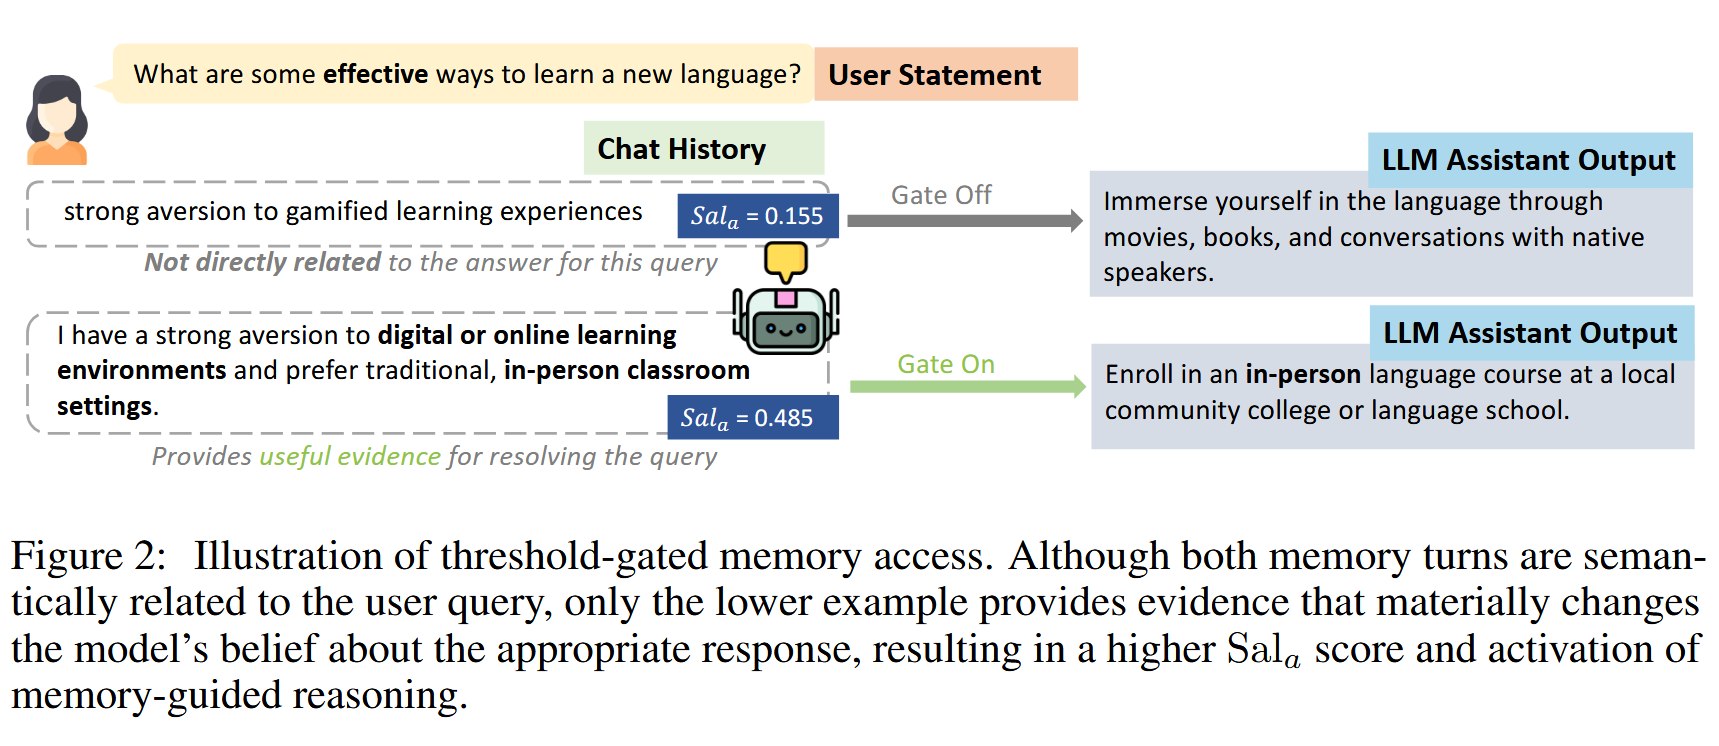
3.5 Stage 4:联合 SFT “学会 控制 + 回答”
Controller 的目标输出由 和 组成,action 中含 trigger、focus_chunk_indices 和 policy;Reader 则根据少量 evidence 和四个选项,输出以 <final_answer>(a/b/c/d) 结束的答案。二者没有采用独立分类损失或 RL,而是共享一个参数集合、把两个样本集合合并,使用 next-token cross-entropy 做 全参数 SFT。
$$ \mathcal{L}_{\mathrm{SFT}} = - \sum_{(x,y) \in \mathcal{D}_{\mathrm{ctrl}} \cup \mathcal{D}_{\mathrm{read}}} \sum_{t} \log p_{\theta}(y_t \mid y_{\lt t}, x). $$3.6 实际推理链路
- 对完整用户历史计算/使用 $Sal_q$ 分数,取 Top-K(多数任务 K=20,PersonaMem K=10);
- 将候选按原始时间顺序放入 Controller,保留原 $message_{idx}$;
- Controller 预测是否触发记忆及最多 5 条焦点记录;
- Gate=1 时 Reader 读取这些历史,Gate=0 时退回 query-only MCQ;
- 输出四选一答案。推理时不再计算 $Sal_a$。
四、实验设置与可复现参数
4.1 数据集与评估范围
| Benchmark | 测试集n | 定位 |
|---|---|---|
| MemBench-Low | 374 | 明确事实回忆;仅 user-only 子集,不含 assistant 轮次相关问题 |
| MemBench-High | 194 | 隐式推断、偏好与情绪等高阶记忆问题 |
| PersonaMem | 74 | 随交互演化的用户画像与个性化建议 |
| PrefEval | 99 | 偏好遵循 / 偏好回忆,较多明确偏好表达 |
作者报告先按 seed=42 进行分层 80/10/10 划分,并执行可用证据过滤;
PersonaMem 采用 persona-disjoint 划分(20 个人设,14/3/3 分配到 train/val/test)。
MB-Low 测试中 124/499 条涉及 assistant 历史的记录被排除,最终使用 374 条 user-only 记录评价;不能将这一分数理解为完整的 MB-Low。
然后作者把这些benchmark统一成了多选题的形式(选ABCD),所以后面的结果都是 accuracy。
4.2 模型、训练、检索设置
| 离线 $Sal_a / Sal_q$ 评分 | Qwen3.5-0.8B;按验证集选择各基准 τ |
|---|---|
| 微调模型 | Qwen3.5-9B;Controller 与 Reader 共享参数;全参数 SFT(无 LoRA) |
| 硬件 | 4 × NVIDIA Ada A6000,DeepSpeed ZeRO-3 |
| SFT | 学习率 5e−6;cosine;warmup 0.03;1 epoch;1343 optimizer steps |
| 批次与长度 | effective batch 16;per-device batch 1;gradient accumulation 2;cutoff 2048 |
| 推理候选 | Sal_q Top-K:其他 K=20,PersonaMem K=10;最终 focus top-k=5 |
| 生成与指标 | Greedy decoding;按 <final_answer> 提取 A/B/C/D;MCQ accuracy |
4.3 Baselines
- Full context:读入所有用户轮次;
- RMM、Mem0、A-MEM、MemoryBank:传统记忆系统,统一将检索到的内容替换到同一 Reader prompt。
- 论文说明,因单次 MCQ 评估不适用,去除了 RMM 的 retrospective reranking 和 MemoryBank 的 forgetting update;这意味着比较的是该实验协议下的简化版本,不代表这些系统完整在线部署的能力。
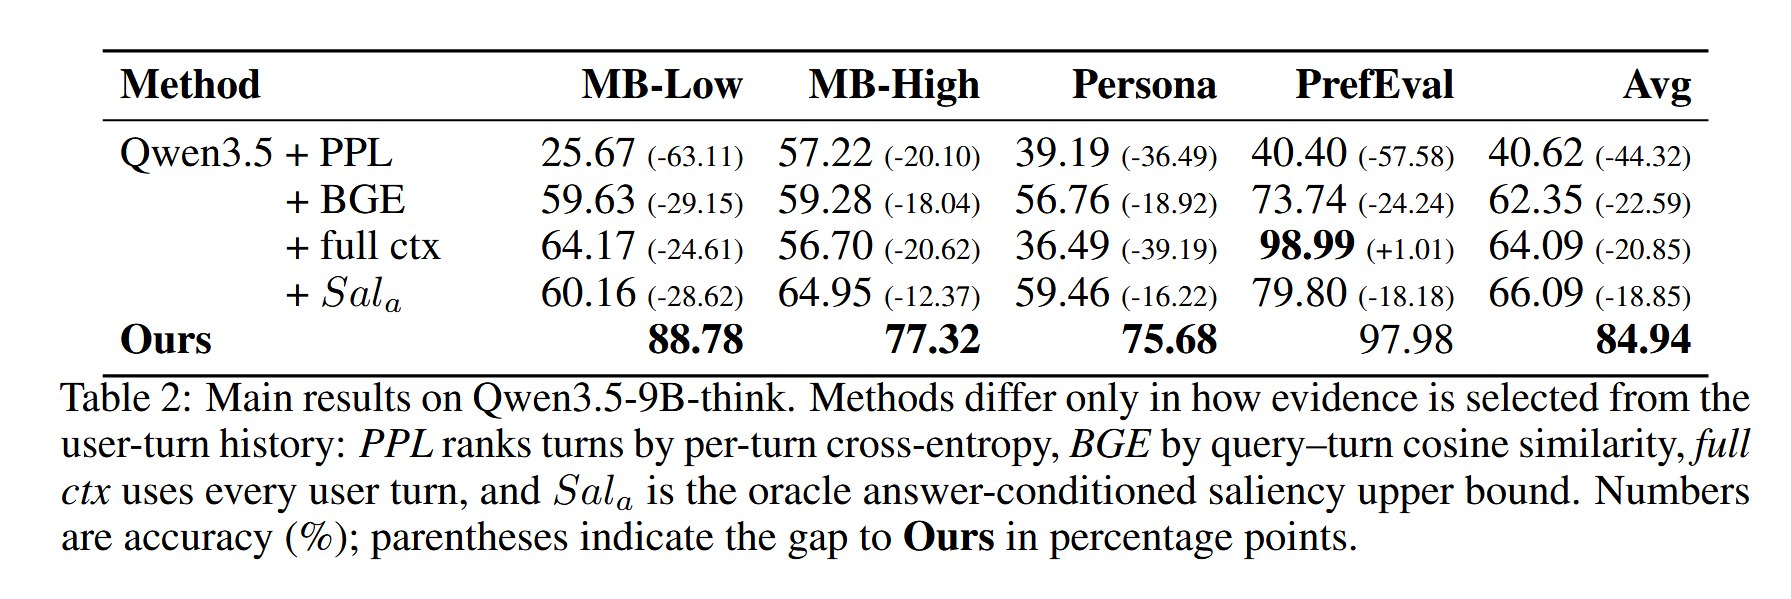
4.4 Main Result
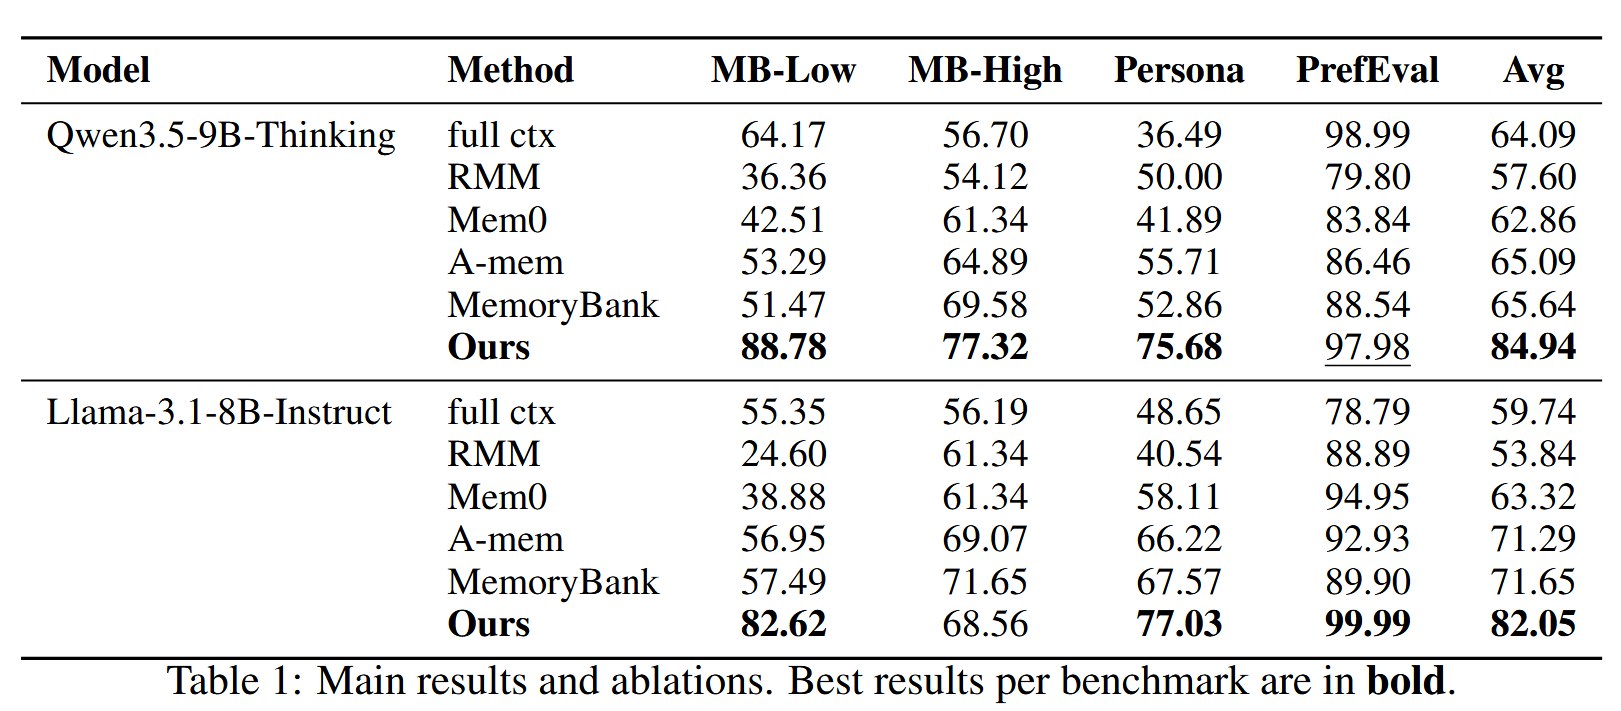
4.5 消融
按照不同 evidence 筛选:
组件消融:
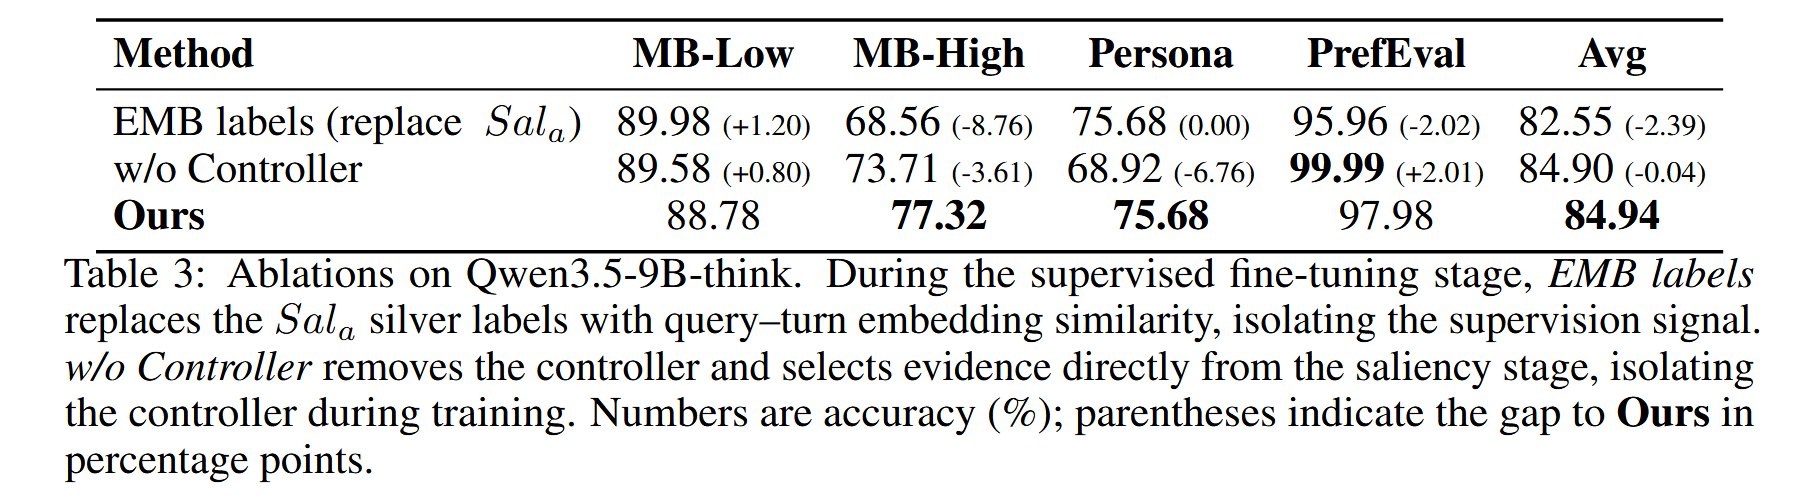
- 发现 A|效用监督比向量相似度监督更适合困难任务。用 EMB 标签代替 $Sal_a$ 标签,平均下降 2.39 pp,而MB-High 单项下降 8.76 pp;但 MB-Low 反而上升 1.20 pp,说明 Bayes 标签也不是全场景单调优。
- 发现 B|Controller 不是平均分提高的主因。w/o Controller 的平均准确率 84.90,仅比 Ours 低 0.04 pp。它在 MB-High 上贡献 +3.61 pp、Persona 上 +6.76 pp,但在 MB-Low 与 PrefEval 反而有负效应。这一消融对于判断 gating 的独立价值非常关键。
- 发现 C|大幅提升包含 Reader 训练适配。“$Sal_a$ 直接检索 + 未联合训练 Qwen”只有 66.09,远低于 Ours 84.94。论文 §4.3 也明确承认:主实验与未训练检索器的差距不应该全部解释为 retrieval gain;Reader 对被压缩的 evidence 的适配同样重要。
4.6 Case Study
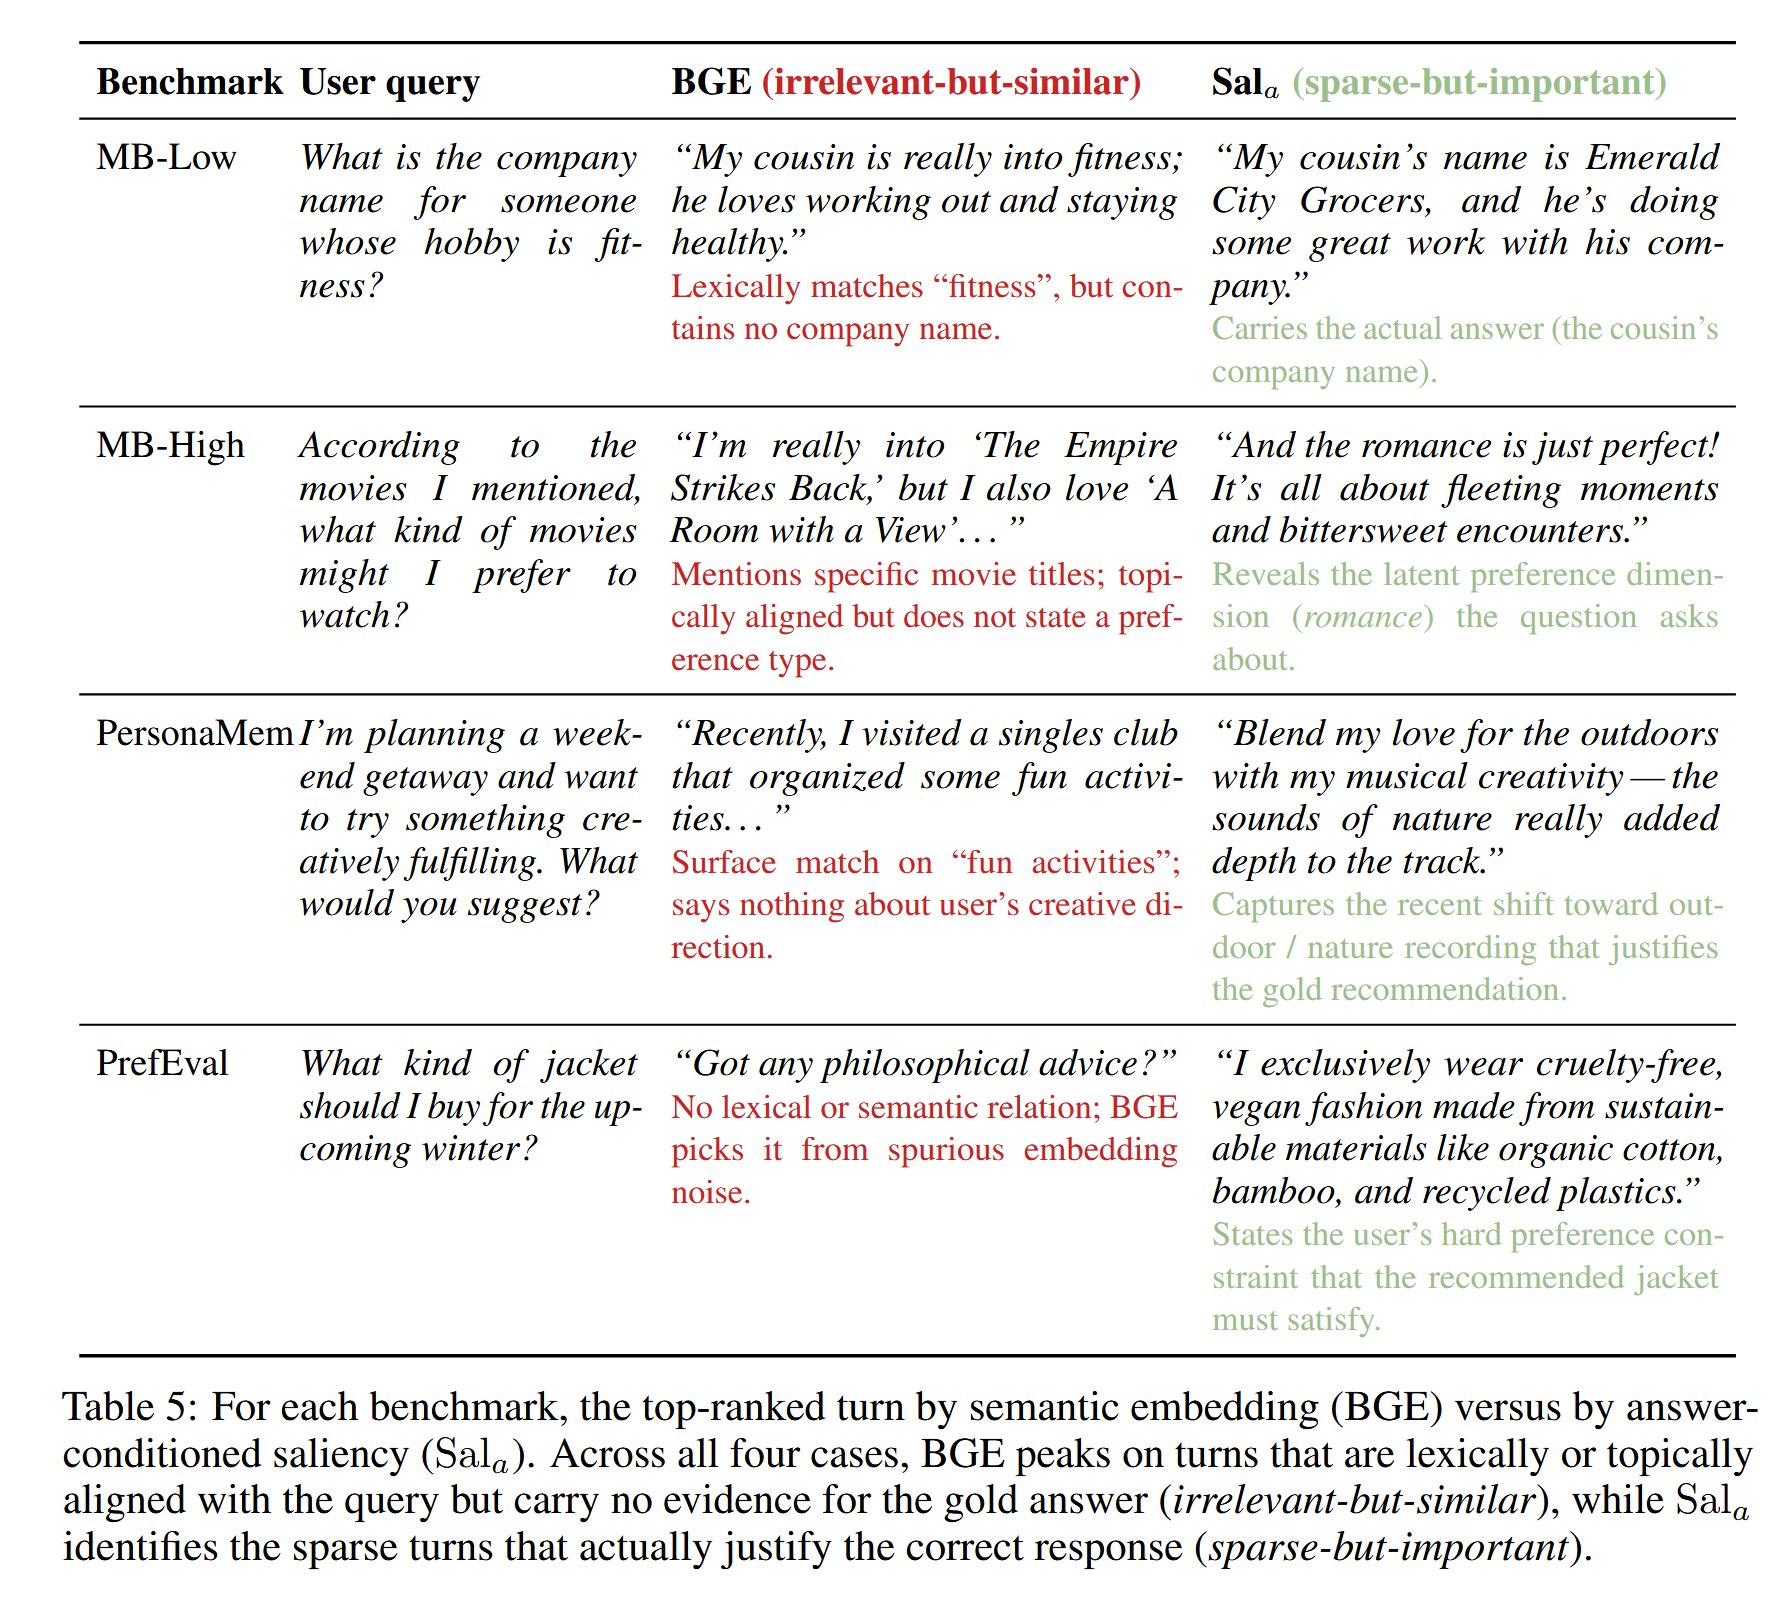
五、结论
5.1 原文结论
在个人记忆场景中,若把候选历史看成“对当前答案的证据”,使用基于 Bayes Factor 的效用信号训练 Gate 与 Reader,能在多个长上下文、隐式偏好 Benchmark中超过 Embedding-based memory;尤其在证据稀疏、表述不直接匹配的问题中更有优势。
5.2 Limitation
- 论文本质上提出了 Answer-aware / Utility-supervised Memory Selection,而非显式的实时偏好状态模型。它没有建模偏好变量、更新规则、冲突关系或优先级时间轴。
- 缺乏直接的“偏好从 A 改为 B”“旧新矛盾”“可逆与周期性偏好”受控测评。现有数据支持该方法在偏好相关任务上有效,但不足以单独验证变更识别机制的正确性。
- 评估基于 user-only 历史与 MCQ,缺少长时在线交互、assistant 侧记忆、自由生成质量、时延、token花费和动态记忆更新开销。
或许可以进一步 stress test:
| 要操纵的变量 | 建议构造的对照 | 观察指标 |
|---|---|---|
| 偏好时间漂移 | A→B、A→B→A、短期例外 | 最新有效偏好命中率;过期记忆误引率 |
| 相似冗余 | 同义反复 1/5/20/100 条 + 1 条关键更新 | Recall@k、nDCG@k、噪声占比、Accuracy |
| 互补证据 | 单条均不足但两条共同可推出答案 | 联合证据完整率;多跳成功率 |
| Gate 失误 | 需要 / 不需要记忆各占一半 | Trigger P/R/F1、false activation、falsesuppression |
| 成本敏感 | 改变 K、k、τ、历史长度 | 准确率-延迟-打分 FLOPs/Token Pareto |
说些什么吧!