
零、写在前面
看到这篇论文宣传的多步推理能力,但读了一下发现还是比较经典的方法和流程,对记忆分类,然后多通道、多步检索。
声称的 reasoning 其实只是做了RL训练了记忆检索能力,工作量倒是蛮大的。
不过他这个数据集Persona-MME构造的方式倒是可以学习一下。
一、标题
来源:CVPR 2026
NJU & 字节
二、问题、背景与动机
2.1 问题
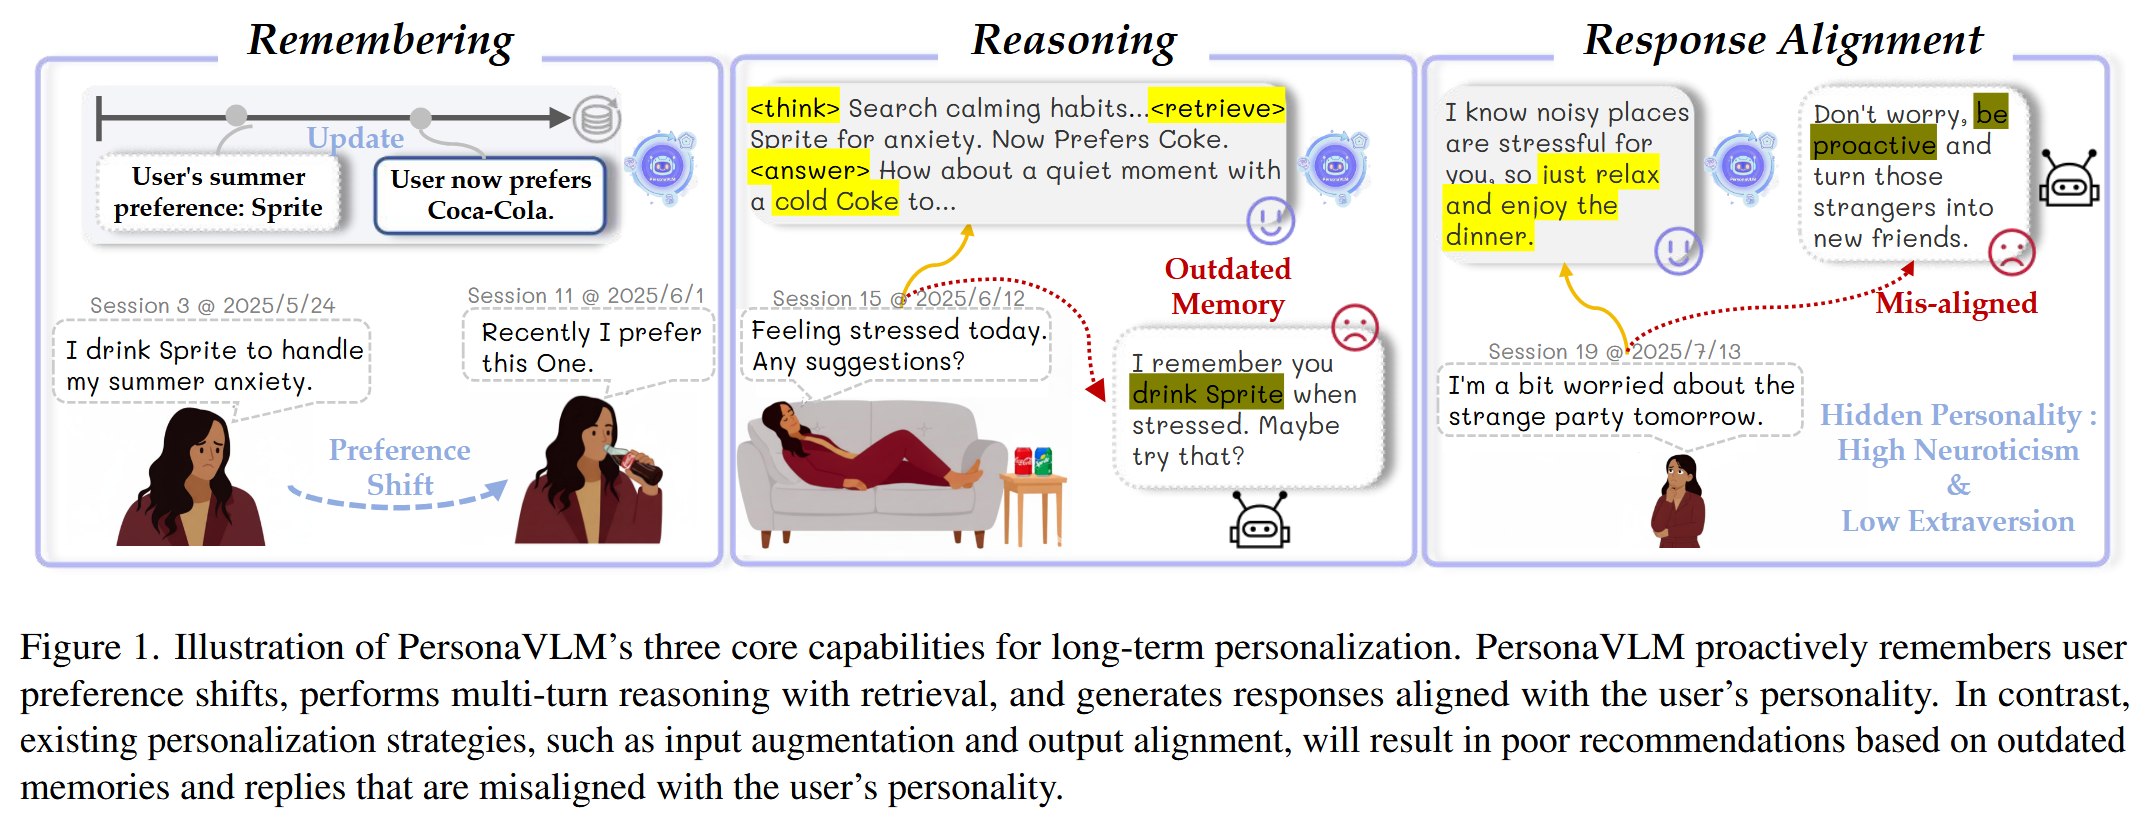
通用 MLLM 的目标通常是:针对当前输入输出正确、符合通用偏好的响应。
私人助手则需要在更长时间跨度 上同时回答四个问题:用户是谁?过去经历过什么?偏好最近是否改变?这次应该以怎样的方式回复?文 本、图片与时间信息混合出现,使长期理解不能等价为把完整聊天记录塞入上下文。
2.2 作者提出的三项能力
- Remembering:从每轮文字与图片中主动抽取有价值的历史信息,写入面向用户的长期记忆。
- Reasoning:模型根据当前查询,决定是否检索、选择关键词和时间范围,并可能进行多轮检索。
- Response Alignment:在长期对话中推断并更新 Big Five 人格画像,以画像提示引导回答风格。
三、相关工作
| 路线 | 主要载体 | 代表工作 | 优点与边界 |
|---|---|---|---|
| 模型适配 Adaptation | 可训练参数、soft prompts | MyVLM、Yo’LLaVA | 可形成用户专属视觉概念;频 繁增量微调成本高,版本/遗忘 难管 |
| 输入增强 Augmentation | 外部向量库、图像概念库 | RAP、Mem0、A-Mem、 Memory OS | 即写即查、可回溯;质量取决 于抽取、索引、检索、上下文 管理 |
| 个性化对齐 Alignment | 用户画像、reward / preference | ALIGNXPERT、PAS、 Personalized Soups | 调整风格/价值偏好;若画像静 态或依赖单次信息则难建模变 化 |
四、方法:读写分工与信息流
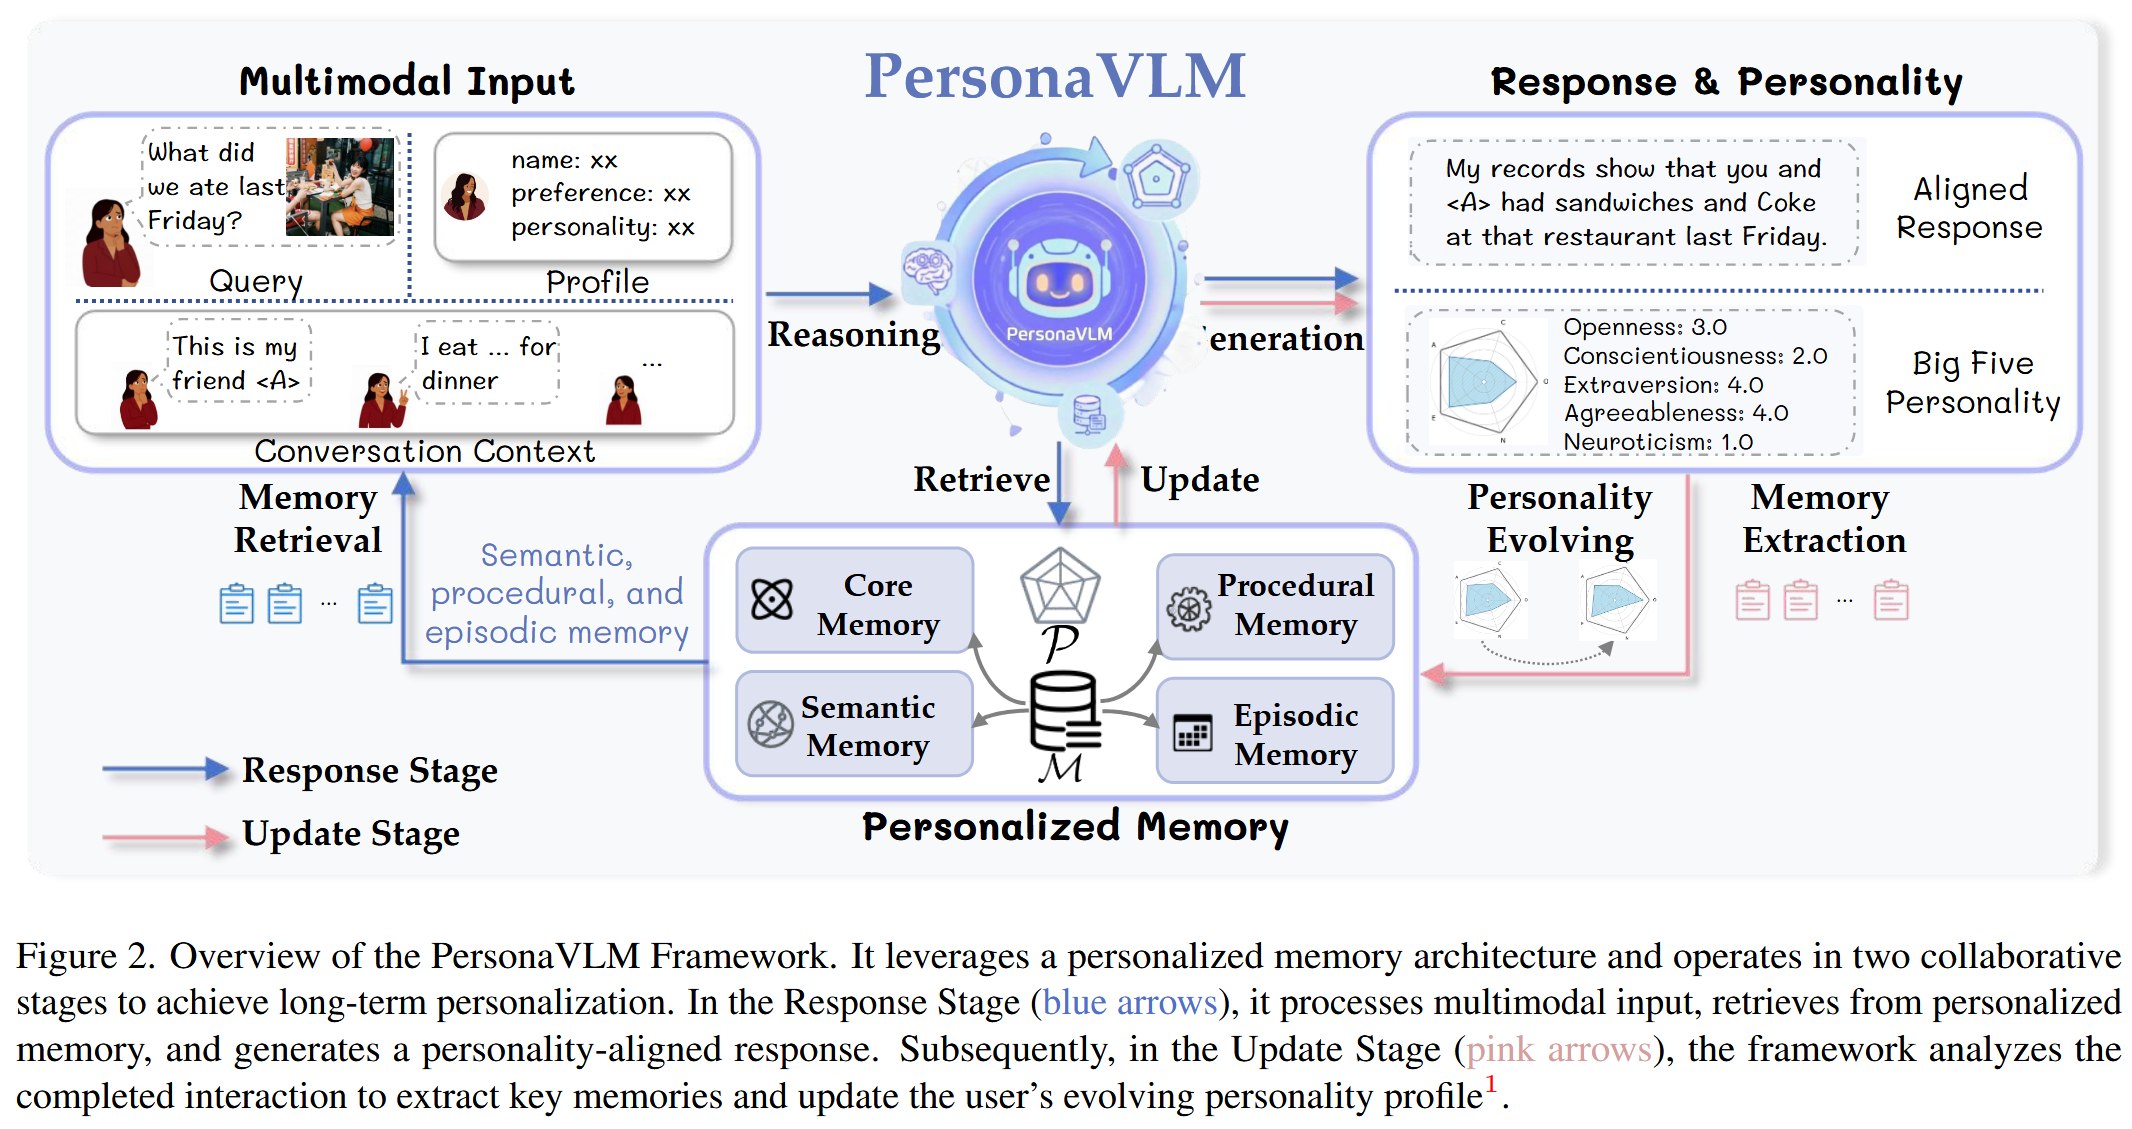
4.1 五层状态:四类记忆 + 人格画像
| 状态 | 保存内容 / 示例 | 更新规则 | 检索或注入 |
|---|---|---|---|
| Core | 用户身份、角色、重要属性、 明确交互要求 | 每会话结束 CRUD,只保存最新版本 | 每次回答初始直接提供 |
| Semantic | 概念、稳定事实、偏好、图像 概念(文本+裁剪图) | 逐轮抽取;追加,不原地覆盖 历史 | 文本嵌入检索 / 视觉匹配 |
| Episodic | 按话题分片的摘要、关键词、 原始轮次索引 | 按会话组织;保留原始对话、 图片 | 查询时按时间与话题回取 |
| Procedural | 目标、计划、工作流、重复习惯 | 会话结束 CRUD,只留最新版 本 | 按需检索 / 档案型知识 |
| Personality P | Big Five: O、C、E、A、N,各 1–5 分 | 每轮推断 + EMA(中性全 3 则 跳过) | 转文本画像放入回答提示 |
4.2 Response Stage:多步、带时间的工具使用
$$ R_m = R(Q_m, C_m, M_{m−1})。 $$- Q 包括文本、可选图像和时间戳;
- C 是短期上下文(论文以 60 分钟无互动作为新会话阈值);
- M 是长期记忆状态。模型首先读取当前查询、短期历史和 Core + 人格画像,若信息不足便输出结构化检索动作:keywords + time period。
- 检索具体分两条路径。
- 文字:先按时间过滤,再用 all-MiniLM-L6-v2 生成嵌入,以 FAISS 在 Procedural / Semantic / Episodic 三类上并行 top-k,默认分别为 2 / 4 / 2。
- 图片:Grounding DINO 提取候选对象区域, 以 CLIP 与长期存储的视觉概念作余弦相似度匹配。结果返回模型,模型可以继续搜索;
- 训练时最多三次 retrieval。
这里真正超越朴素 top-k 的部分是:让查询规划本身成为策略。查询关键词、时间跨度以及检索次数都不再是固定超参数;但底层寻址依然主要是 embedding similarity。也就是说它提升的是检索编排,而不是根本改变相似度记忆的表达能力。
4.3 Update Stage:写入在回复之后进行
$$ (P_m, M_m) = U(Q_m, R_m, M_{m−1})。 $$当前轮回复结束后,系统在空闲期推断画像、添加 Semantic;
当一个会话结束时汇总并更新 Core / Procedural / Episodic。
原文实现会存下原始历史,这意味着摘要丢失细节时,模型理论上还能回到具体原始回合。
4.4 PEM:一个有平滑系数的人格状态机
附录 A.1 给出:
$$ p_m ← λ_m p_{m−1} + (1−λ_m)p′_m $$,其中 $λ_m = 0.7 − 0.2·cos(min(m,50)π/50)$。
因此第 0 轮附近 λ≈0.5,第 50 轮以后 λ=0.9:新的单轮证据初期权重大、后期权重只有约 0.1。
若本轮五个维度全是中性 3,则本次更新跳过。 实现本身很简单,问题并不在 EMA,而在 $p′_m$ 的可辨识性:从一句“我明天有演讲,紧张得不行”推断稳定的 Neuroticism,到底是在估计长期人格,还是短暂状态?
论文缺少与独立心理测量真值的纵向比较。
五、训练、数据合成
5.1 SFT + RL
Backbone:Qwen2.5-VL-7B。
第一阶段 SFT 使用约 78k 样本,让模型能够进行画像推断、记忆 CRUD、结构化检索动作和多轮 reasoning trace;
其中 43.6% 为 QA 推理样本,56.4% 为记忆任务(内含人格推断 10.3%,四类记忆任务 46.1%),并加入约 6k 视觉概念样本。
第二阶段 RL 使用约 5.6k 样本,应用 GRPO 优化多步检索与最后答案;样本组成是开放式可验证 QA 21.0%、多选 55.6%、二选 23.4%。
SFT 使模型熟悉工具与格式;
RL 以成功解题为奖励让模型学会“何时查、查几轮、怎么答”。
这里的 Reasoning,工程上具体表现为一个检索增强的策略模型。
奖励为 $r = f_{acc}(参考答案, 输出) × f_{cons}(问题, 输出) + 0.5 × f_{format}(输出)$。
$f_{acc}、f_{cons}$ 由 Qwen3-30B-A3B 充当零样本评判者;格式奖励检查等结构。GRPO 每组采样 6 条轨迹,训练最多 3 次检索。
该设计对 answer correctness 有明确监督,但没有直接奖励“记忆来 源是否可靠 / 是否过期 / 是否侵犯隐私”。
5.2 模拟长期用户
生成流程从 PersonaHub 采样 700 个虚构 personas,其中 500 用于训练、200 用于测试。
先随机注入 Big Five 分数和人物档案,再用 Seed1.6-thinking 生成带时间戳的连续对话,同时产生记忆更新与检索轨迹。作者强调多月的偏好变化、图文混合场景、结构化监督;此外采用规则/模型检查与人工过滤。
附录 C:训练对话通常是 20–100 轮、模拟最长一个月;测试对话为 20–100 轮(32k)和 100–500 轮 (128k),最长三个月。训练并不主要依靠真实用户数月反馈,而是让大模型设计一个“用户如何变化”的合成过程。
这适于定义明确的 benchmark,但外推到真实用户行为时证据不足。
六、实验
6.1 Persona-MME
| 指标 | 论文数值 | 理解 |
|---|---|---|
| 用户 / 样例 | 200 personas / 2,034 in-situ cases | 从历史某一时点发起用户第一人称问题 |
| 情景长度 | 平均 142.9 turns | 32k / 128k 两个配置,用户集合各 100 |
| 多模态轮次比例 | 15.87% | 大多数历史轮次仍只有文本 |
| 图像相关测试比例 | 34.02% | 约三分之一的问题依赖视觉信息 |
| 题目 / 答案平均词长 | 22.7 / 3.05 words | 答案以短选项为主 |
| 人格任务 | 406 个 primary cases 中并行测试 | 对齐测试项记为 812;单位口径不同 |
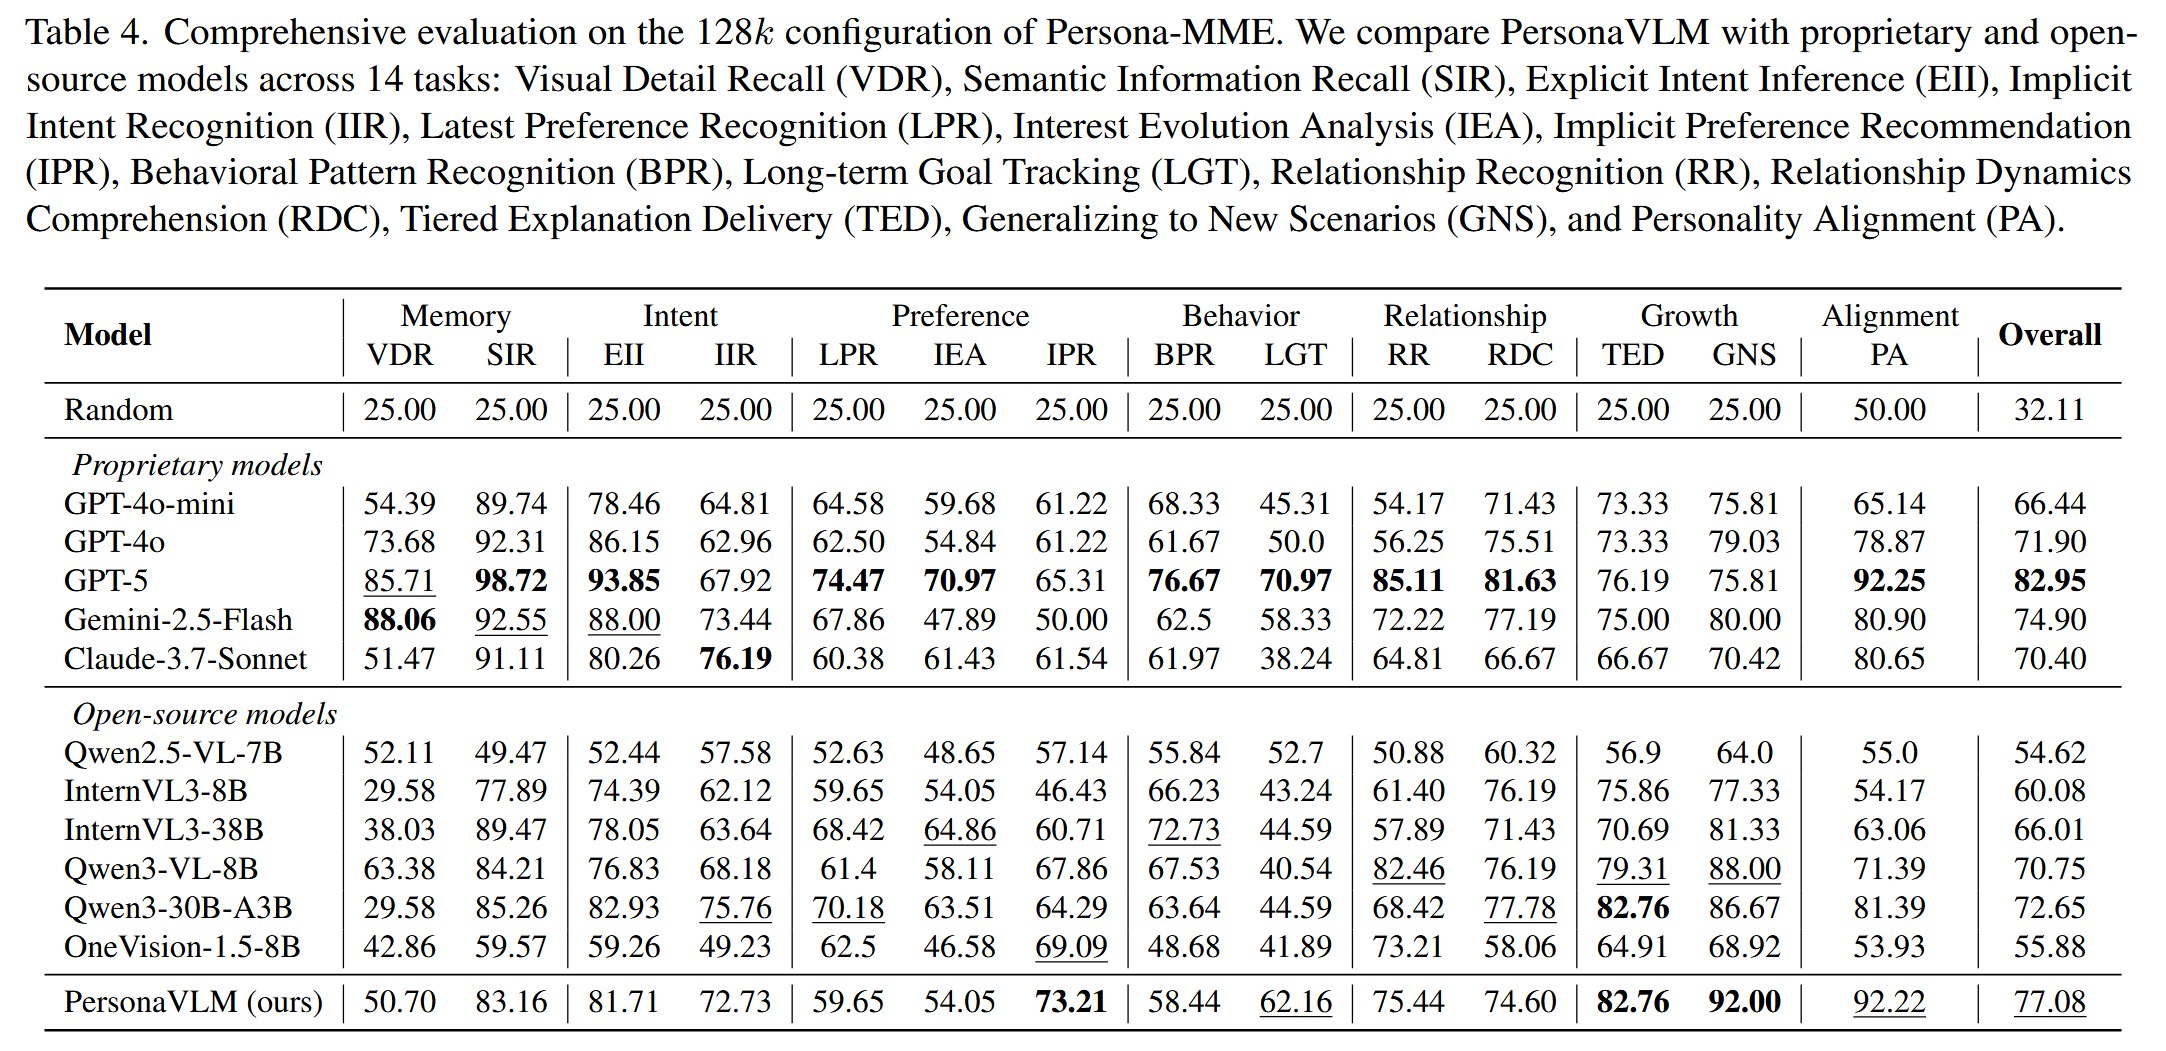
14 项任务分七个维度:Memory(视觉细节、语义回忆)、Intent(显式/隐式意图)、Preference(最新偏好、兴趣演化、隐式推荐)、Behavior(模式、目标跟踪)、Relationship(关系识别、关系变化)、 Growth(分层解释、新情境泛化)、Alignment(人格对齐)。
前六维体现“理解/记忆”,第七维体现回复是否符合画像。
6.2 Main Result
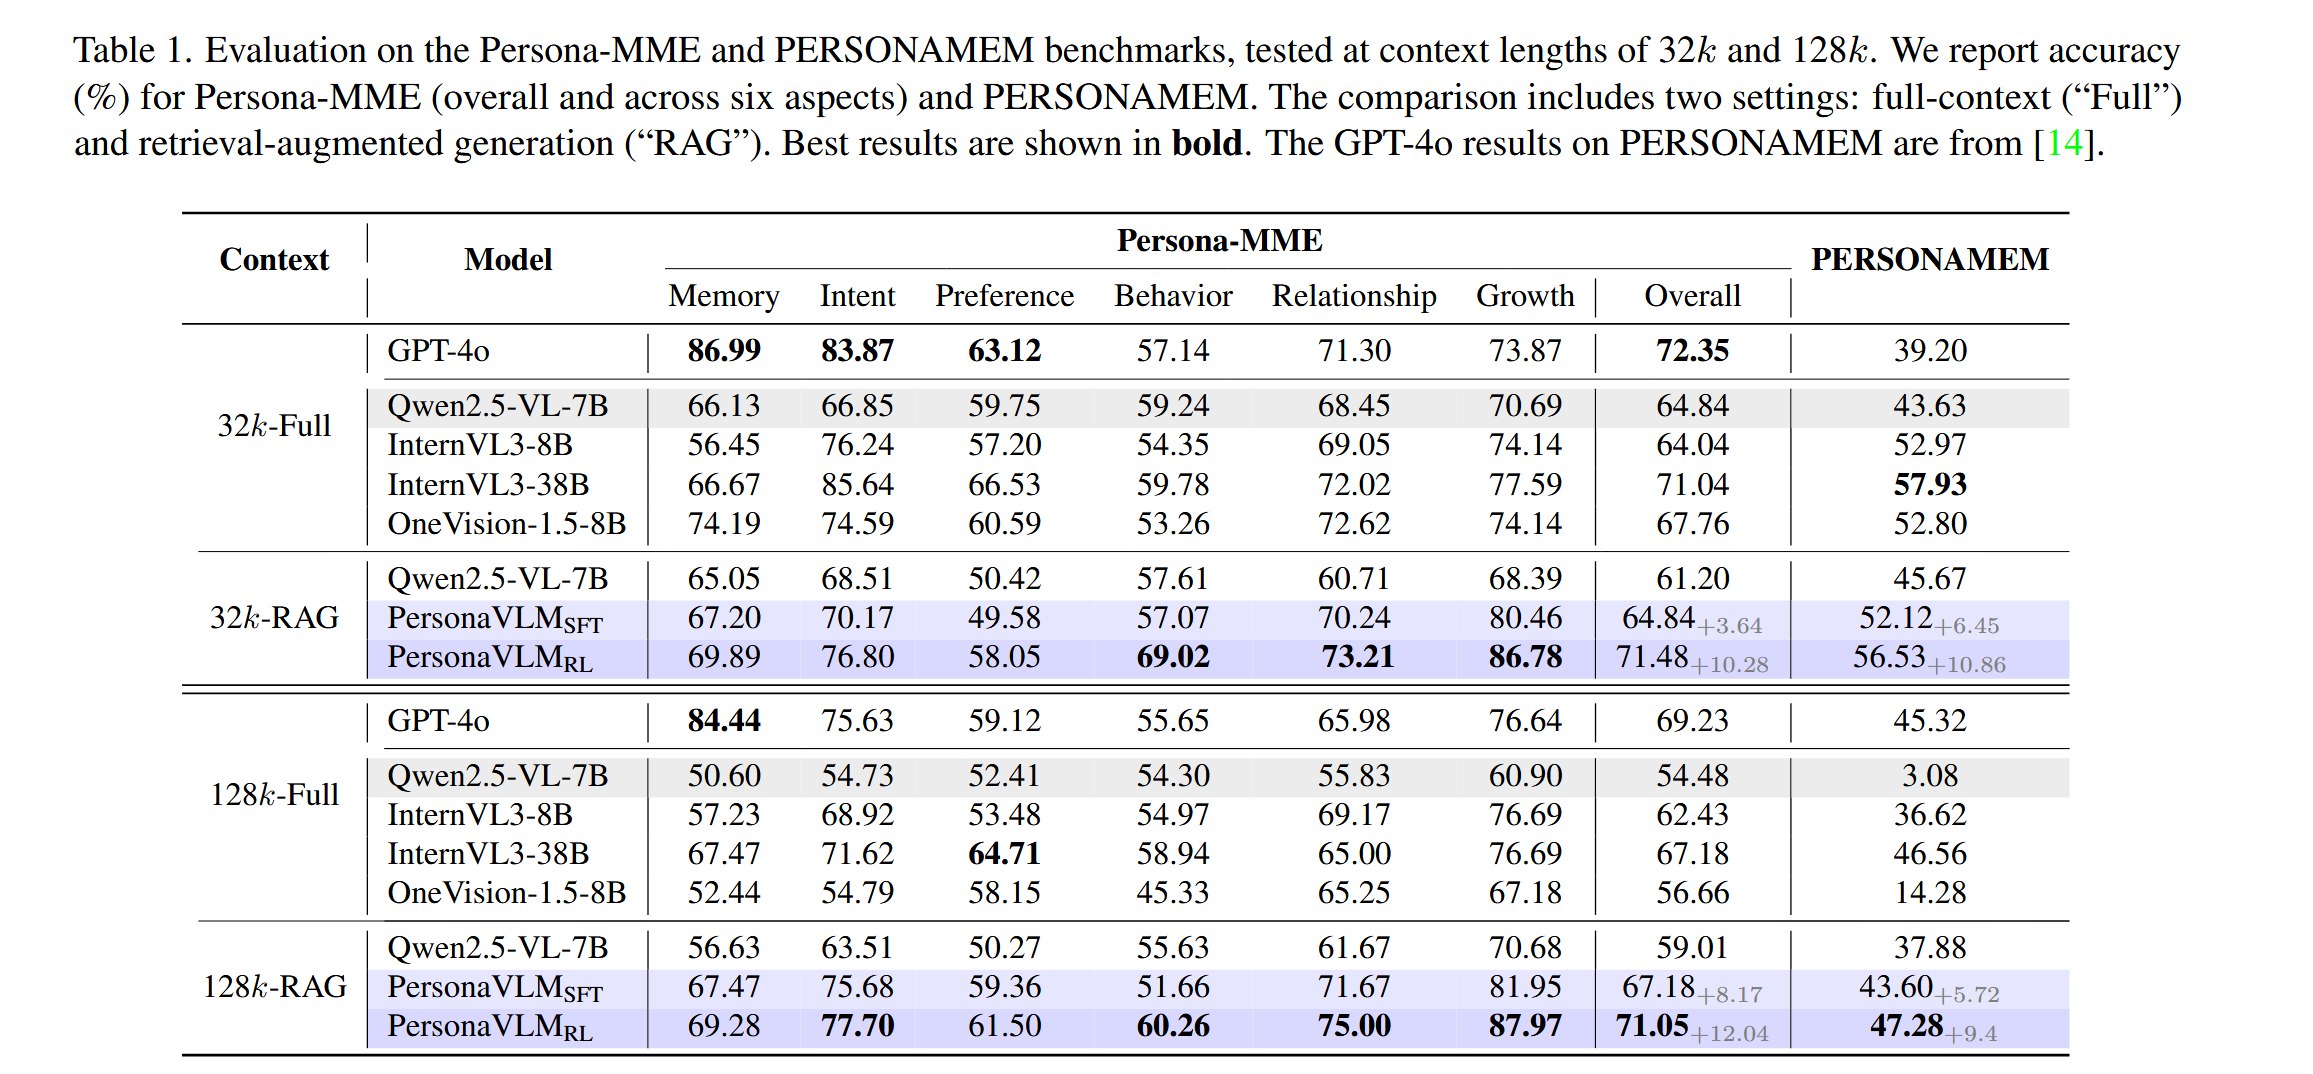
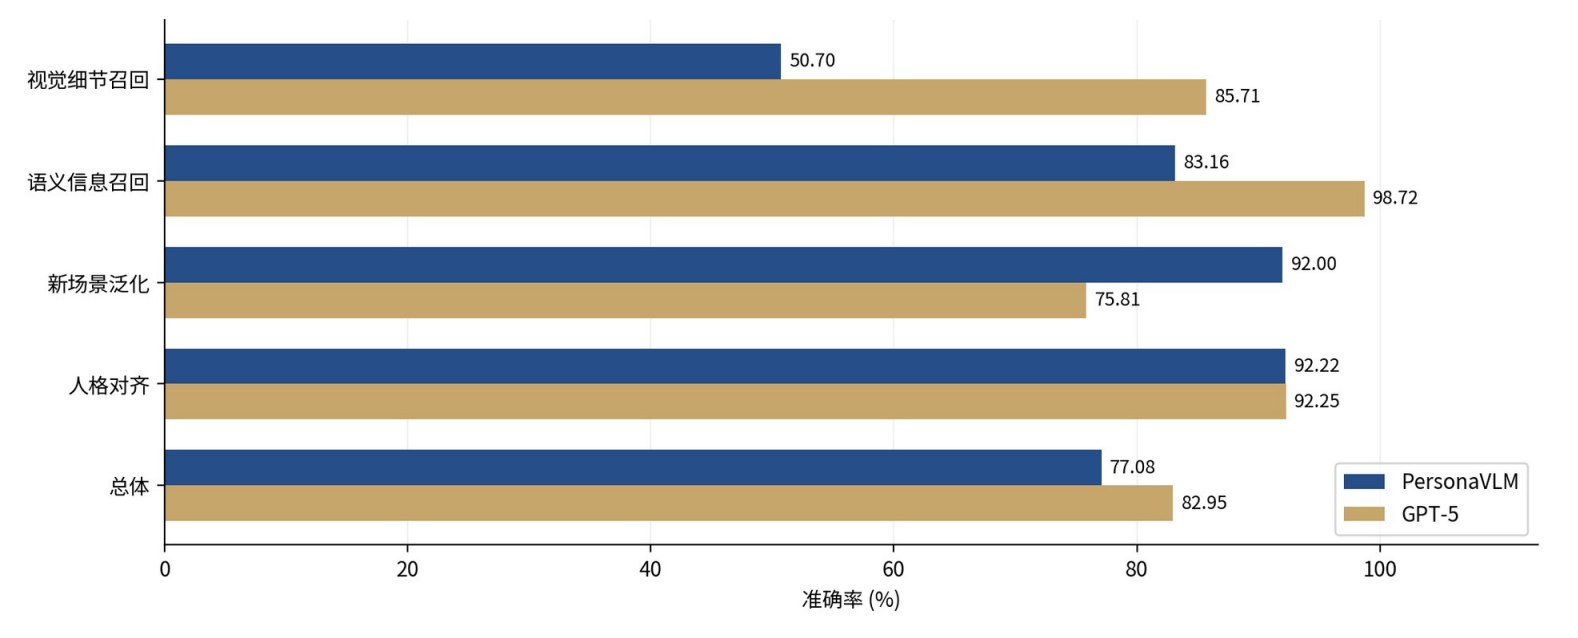
6.3 优势集中于新场景与人格对齐,视觉细节召回反而明显落后
6.4 消融:最关键的是 Episodic Memory,而不是四类均衡
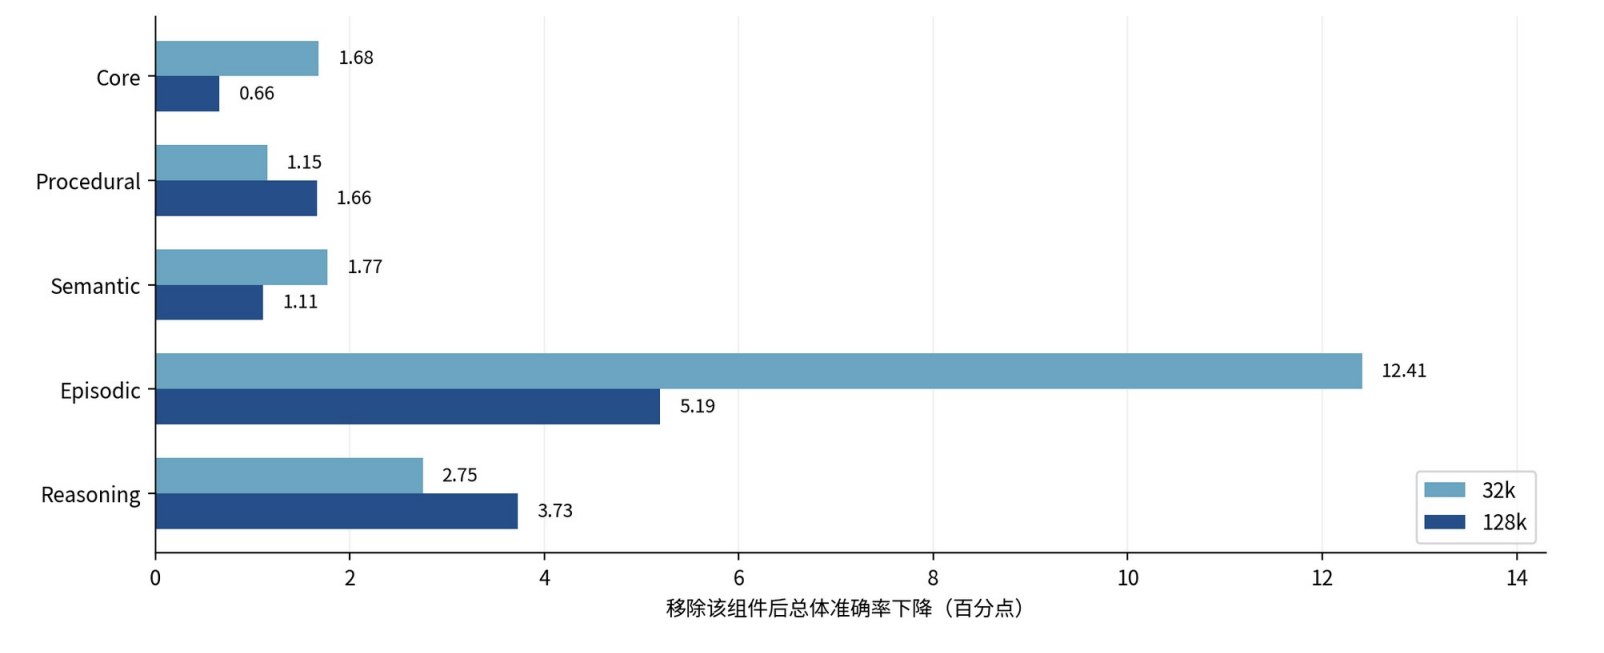
Episodic(摘要 + 原文回合可追溯)是整个方案最有影响的部分;多步检索对效果有可测贡献。
或许“只有 Episodic + 高质量索引 / 更好检索”是否就足以逼近完整系统?
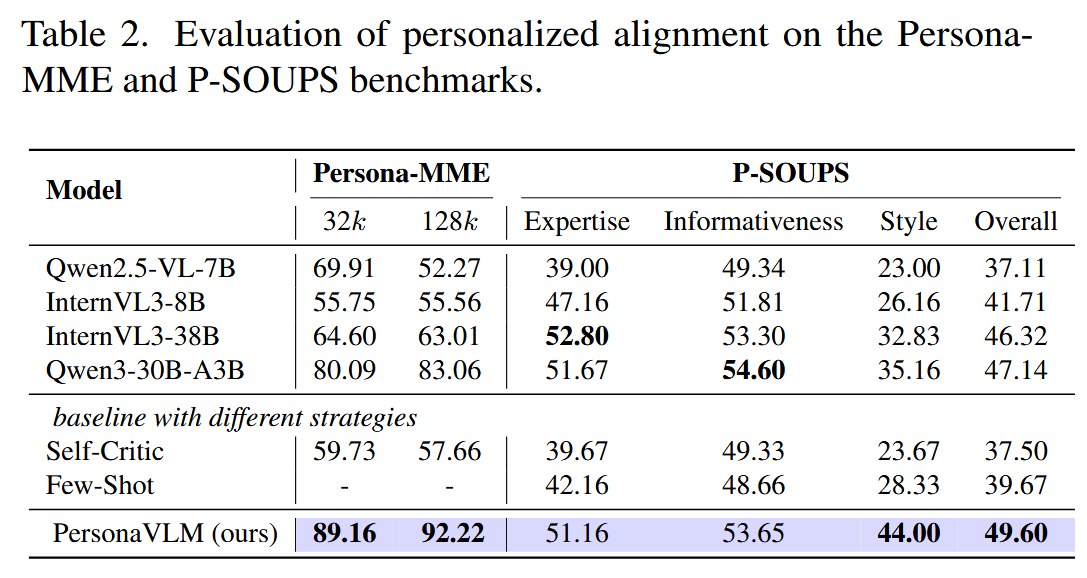
6.5 Alignment
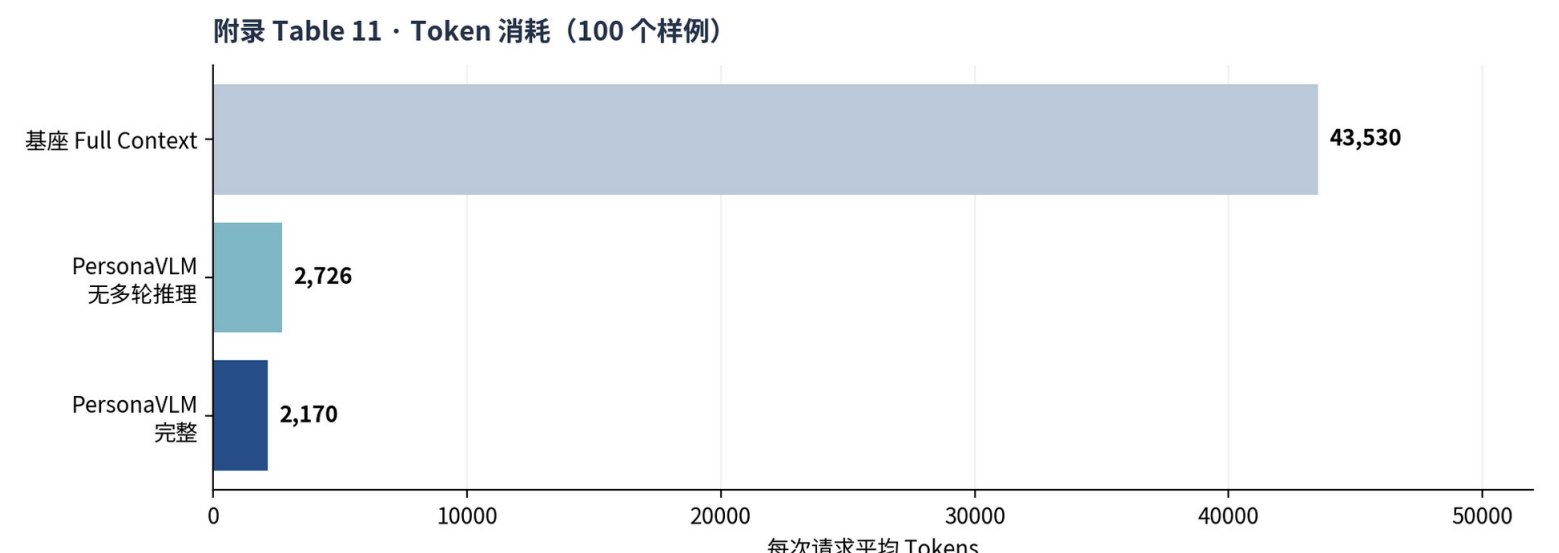
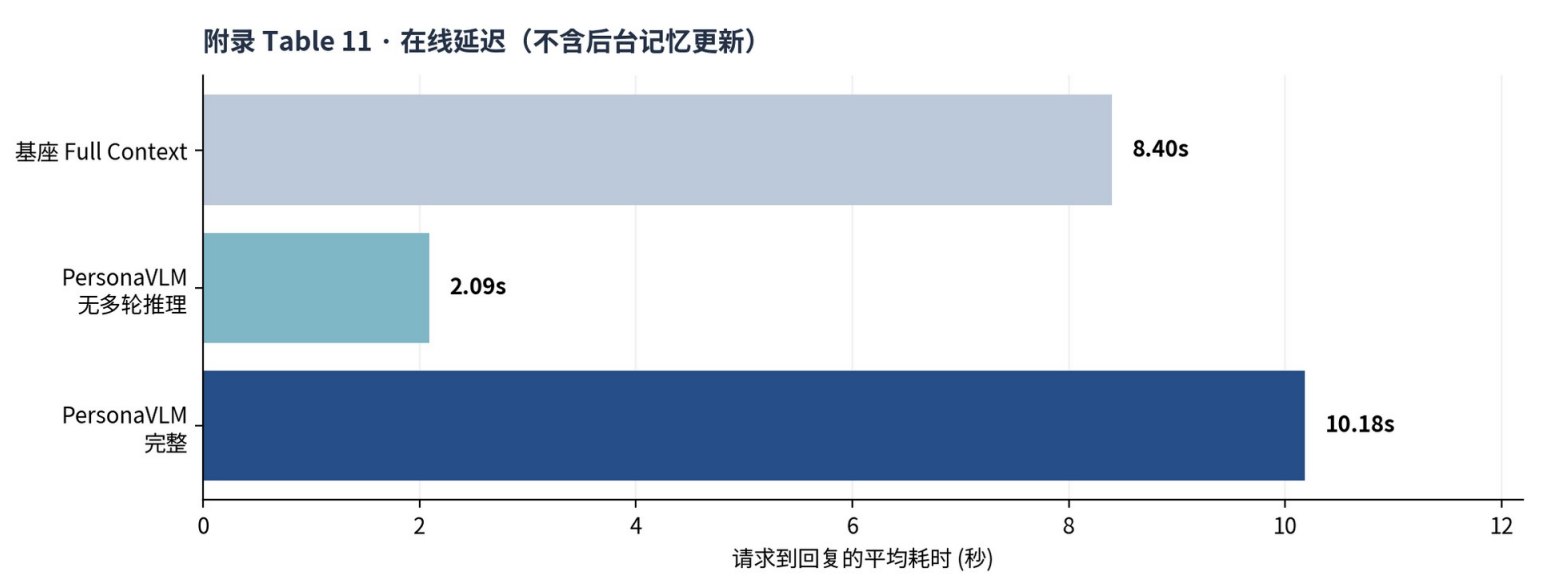
6.6 Efficiency
七、总结
比较中规中矩的工作。
从实验结果可见时间在检索索引中是非常关键的(response stage 先进行时间过滤),Time range、最新状态、有效期、因果先后比单一 cosine score 更适合 偏好更新;
不过除了时间过滤,我们也可以加入更多维度,比如置信度、有效性等等。
如果想要在情景问题上取得更好的效果,只优化表征,提升召回率或许不够,或许我们需要将记忆设计成某种具有时间与因果连接的结构?
说些什么吧!