零、写在前面
因为注意力机制强大的序列建模能力以及llm丰富的语义空间,所以从这里入手来做一些更适配agent场景的memory工作是很合理的。
不过这篇工作觉得llm 的语义空间太复杂了,反而会妨碍我们去捕捉用户偏好,所以它用 SAE 做了一次解耦,然后建 GNN,拿到一串 latent token 送入 llm。
从实验结果来看效果很不错,消融实验也表明一些idea的收益。感觉做的还是很规整的。
一、标题
来源:arxiv 代码:未开源
二、背景
2.1 现有路线的问题
| 路线 | 代表 | 优点 | 论文指出的缺口 |
|---|---|---|---|
| Flat retrieval | Vector RAG、Naive RAG | 简单、可扩展、保留原文 | 片段独立打分,难合成跨 session 的弱线索 |
| Structured textual memory | GraphRAG、HippoRAG、Mem0、A-Mem、MemoryOS、LightMem | 有图、层级或读写机制 | 多数结构预构建且偏 query-agnostic;仍需重读噪声文本 |
| RL memory policy | Mem-α、MemAgent、Memory-R1、MemCoE | 可学习写入/读取/删除策略 | 优化的仍是 textual memory 操作,往往有重复 prompting 的成本 |
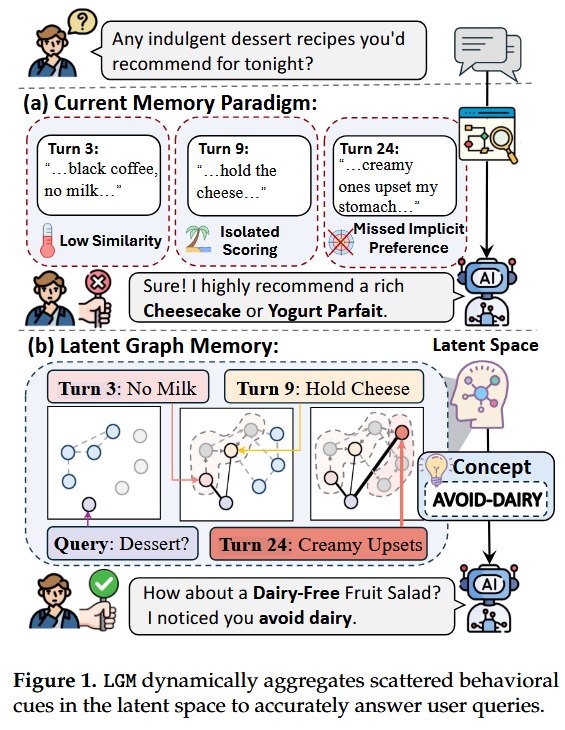
LGM 的观点是:长期记忆不只需要选择“哪段文本”,还需要学习历史如何被表示、关系如何随 query 变化、以及怎样组合分散证据。因此它不先构建永久的文本摘要或固定图,而将组织过程放在连续 latent space,按 query 临时完成。
2.2 为什么不拼接进prompt
- 长上下文有 token 成本和 lost-in-the-middle:相关证据可能被无关内容稀释。
- 一条文本同时混合话题、态度、健康约束、时间状态等因素;以整段为检索单元难以精确拆出一个因素。
- 纯向量检索只能给每段一个相似度,不天然表达“多条线索合在一起意味着某个偏好”。
latent compression 也会带来风险:是否丢失证据,以及 generator 会不会忽略 prefix。LGM 以 evidence reconstruction loss 约束这一点,这是其方法的关键设计。
2.3 LLM hidden states 的“特征叠加”与“纠缠”
在深度学习与机理可解释性(Mechanistic Interpretability)研究中,模型的一层隐藏状态通常存在叠加假说(Superposition Hypothesis):
- 模型维度是有限的(例如论文压缩后的 $d=32$),但它需要表达现实世界中成千上万种属性(话题、情感、句式、口味偏好、健康约束等)。
- 因此,大模型会把多个特征“叠加”压缩在同一个密集的向量空间中,导致一个神经元/维度同时具备多种含义(多义性 Polysemanticity)。
- 直接后果:如果直接拿稠密隐向量计算余弦相似度,计算出的相似度是“语法、语气、话题”的混合物,根本无法精准捕捉到细微、隐蔽的个性化偏好。
三、方法
整体路径为:
$$ \text{history text}\rightarrow\text{latent nodes / sparse concepts}\rightarrow \text{query-conditioned graph state}\rightarrow\text{soft prefix}\rightarrow\text{LLM response}. $$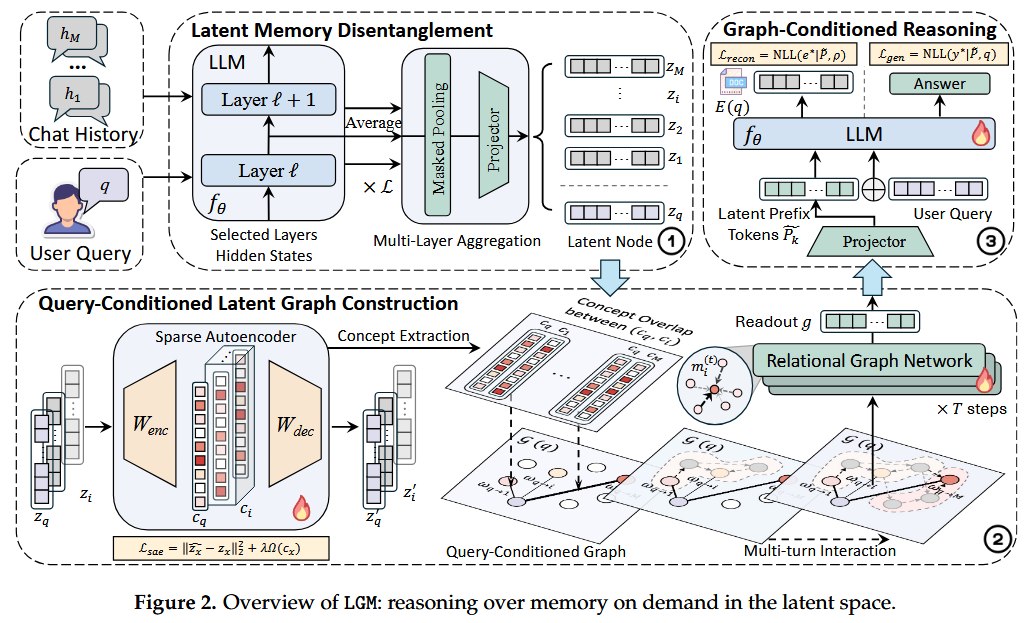
3.1 历史文本编码为 latent node
对每个历史交互 $x\in H$ 和 query $q$,读取 backbone 的多个中间层 hidden states,平均后做 masked mean pooling,再经 projector 得到低维节点 $z_x$:
$$ z_x=\operatorname{LN}\left(\sigma\left(W\cdot\operatorname{Pool}\left( \frac{1}{|\mathcal L|}\sum_{\ell\in\mathcal L}f_\theta^{(\ell)}(x)\right)\right)\right). $$实现读取第 $\{8,16,24,32\}$ 层,latent dimension $d=32$。作者认为低层有词法线索,高层有行为/语义抽象;混合更适合隐式偏好。历史按最大 2048 tokens 的 chunk 编码,记忆规模随 node 数增长,而不是形成无限长 prompt。
3.2 SAE:从 dense latent 到稀疏 concept
SAE 的本质是一个**超完备字典学习(Overcomplete Dictionary Learning)**模型:
- 它将低维稠密向量($d=32$)投射到更高维度的空间(概念维度 $d_c=256$)。
- 引入极高强度的稀疏约束(只允许极少数神经元同时激活)。
每个节点经过 SAE,产生非负、稀疏的 concept code $c_x$,并重构为 $\hat z_x$:
$$ c_x=S(\operatorname{ReLU}(W_{enc}z_x)),\qquad \hat z_x=W_{dec}c_x. $$$$ \mathcal L_{sae}=\|\hat z_x-z_x\|_2^2+\lambda\Omega(c_x). $$公式拆解:
- 概念编码(Concept Extraction):
$$c_x = S\Big(\text{ReLU}(W_{enc} z_x + b_{enc})\Big) \in \mathbb{R}^{d_c}_{\ge 0}$$
- $W_{enc} \in \mathbb{R}^{d_c \times d}$:将 32 维映射到 256 维。
- $\text{ReLU}(\cdot)$:确保激活值非负($\ge 0$),符合概念“要么出现、要么不出现”的直觉。
- $S(\cdot)$ 抑制弱激活算子:论文采用 Top-$k$ 稀疏化(在 256 维中仅保留数值最大的 $k=32$ 个,其余全部硬截断为 0)。
- 潜变量重构(Reconstruction):
$$\hat{z}_x = W_{dec} c_x + b_{dec} \in \mathbb{R}^{d}$$
- $W_{dec} \in \mathbb{R}^{d \times d_c}$:把稀疏激活的“概念基底”重新线性组合,还原回原本的潜变量。
- 训练目标(SAE Loss): $$\mathcal{L}_{sae} = \underbrace{\|\hat{z}_x - z_x\|_2^2}_{\text{重构保真度}} + \lambda \underbrace{\|c_x\|_1}_{\text{稀疏惩罚项}}$$ (注:论文超参数中,重构权重取 0.1,$L_1$ 稀疏权重 $\lambda=0.001$)。
Q:为什么 SAE 能解耦“隐式偏好”?
A:
- 设概念维度 $c$ 中的第 42 维代表**“忌乳制品/乳糖不耐”**这一语义概念:
- 当用户说:“黑咖啡,不加奶”时,第 42 维被激活。
- 当用户说:“刚才那块奶油蛋糕吃完我肚子疼”时,第 42 维也被激活。
- 尽管这两句话在文字表面(Token 层面)毫无重合,甚至语法风格完全不同,但 SAE 将它们映射到了同一个非零概念位 $c[42]$。
- 接着,查询条件图的连边权重 $\omega_{q \to i} = \phi(c_q, c_i)$ 即可通过稀疏向量的交集/重叠度,迅速锁定这些表面不相关、实质有因果联系的记忆碎片。
3.3 Query-conditioned latent graph:图不预存,按 query 生成
图节点是 query node $z_q$ 和所有 memory nodes $z_i$。query 到第 $i$ 条记忆的边权由 sparse concept overlap 给出:
$$ \omega_{q\rightarrow i}=\phi(c_q,c_i)\in[0,1]. $$这与固定 GraphRAG 的区别是:同一历史在“推荐甜点”和“推荐游戏”下会因 $c_q$ 不同得到不同的边权和局部拓扑。图中加入 self-loop 以及双向、带类型的 query $\leftrightarrow$ memory relation。
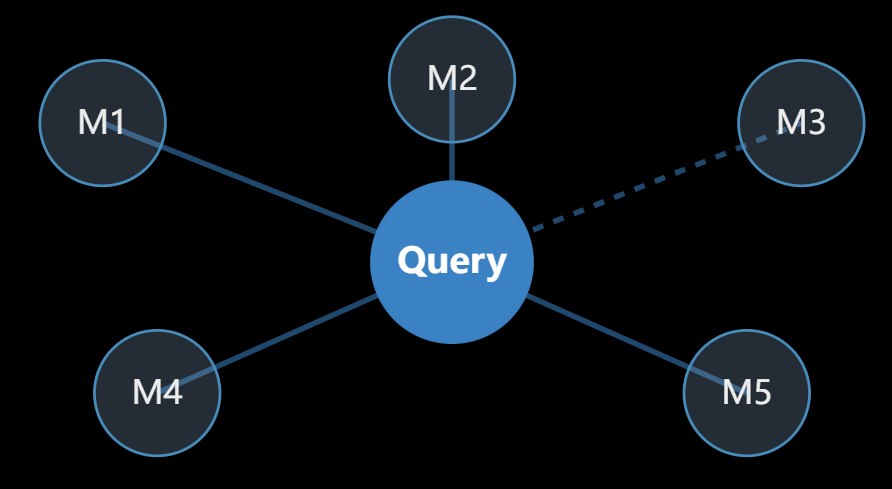
值得注意的是,这里的建图很简单,以 query 为中心建了一个菊花图:
所以,它不像有的知识图谱或者 graphrag 那样建立了复杂的关系图。
Relational GNN 做 $T=4$ 轮传播:
$$ m_i^{(t)}=\sum_{j\in\mathcal N(i)}\omega_{j\rightarrow i} \psi(z_i^{(t)},z_j^{(t)},r_{ij}),\qquad z_i^{(t+1)}=\operatorname{Upd}(z_i^{(t)},m_i^{(t)}). $$最终 readout 得到一个 query-specific graph state $g$。这一层真正承担“把多条单独看很弱的证据合成隐式偏好”的功能。
3.4 Graph-conditioned generation:图状态成为 prefix
projector 将 $g$ 变成 $p=16$ 个连续 prefix tokens $\tilde P$,并缩放至普通 token embedding 的 norm;随后:
$$ y\sim f_\theta([\tilde P;E(q)]). $$在线生成阶段不再把候选历史原文拼到 prompt。
3.5 训练:evidence reconstruction 防止 latent collapse
总目标为:
$$ \mathcal L=\mathcal L_{gen}+\mathcal L_{recon}+\mathcal L_{sae}. $$- $\mathcal L_{gen}$:从 prefix + query 生成目标回复;
- $\mathcal L_{recon}$:用同一 prefix加固定指令,重建 supporting evidence text(最多 96 tokens);
- $\mathcal L_{sae}$:使 concept 可重构且稀疏。
仅用生成损失时,强 backbone 可能绕开 prefix,或者 prefix 退化为空信号。重建损失要求 latent 仍可解码出支持证据。论文消融显示,移除 reconstruction 的退化最大,尤其在 implicit preference 上。
3.6 训练和部署
端到端训练 graph modules 和 backbone:graph LR $2\times10^{-4}$、backbone LR $1\times10^{-5}$、3 epochs、8×H800;默认全参微调,也提供 rank-16 的 LoRA 变体。LGM 不是可对任意闭源 API 即插即用的 memory middleware:其 latent encoder、prefix projector 与生成 backbone 需要共同训练或至少适配。
四、实验
4.1 Benchmarks
| Benchmark | 考察能力 | 关键难点 |
|---|---|---|
| PersonaMem | 长期偏好的保持与更新 | 32K / 128K;最多 60 sessions |
| PrefEval | 显式与隐式 preference following | 3,000 人工偏好;implicit 与 query 没有词面捷径 |
| PersonaMem-v2 implicit split | 纯隐式 persona 推断 | 1,000 personas、20K+ preferences、300+ scenarios;偏好不直接陈述 |
主实验使用 Qwen2.5-7B-Instruct 和 Gemma3-4B-it;PersonaMem-v2 使用 Qwen3-4B-Instruct。所有方法输出 free-form answer,并以与参考答案/目标偏好的一致性计算 accuracy。
4.2 主结果
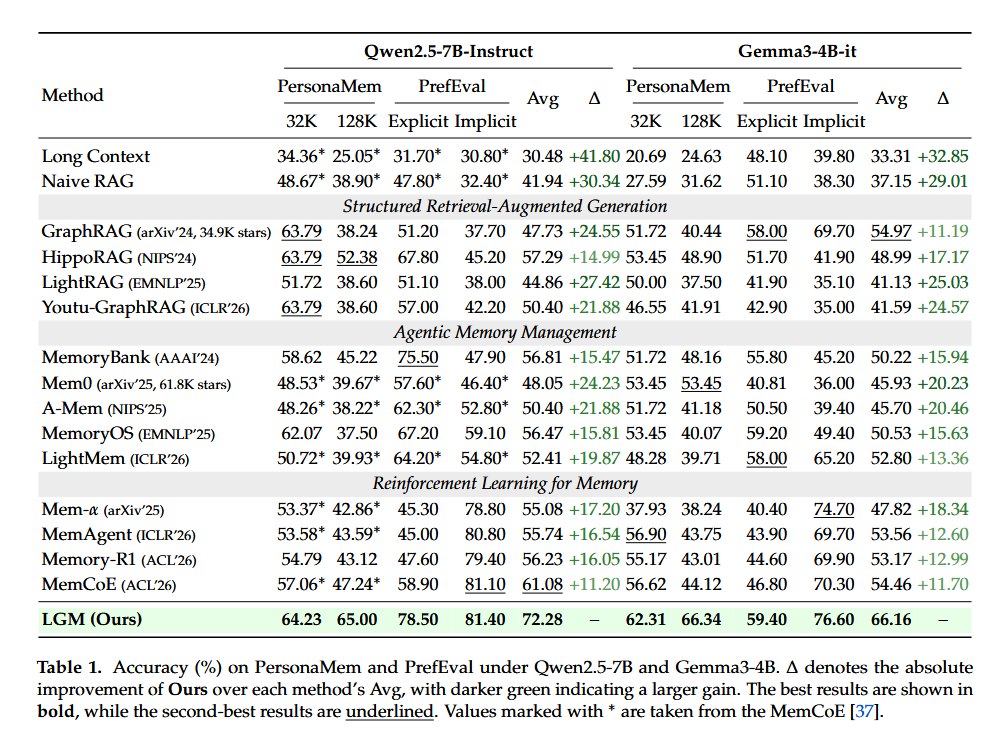
- 显式与隐式的巨大鸿沟:
- 传统方法(如 Naive RAG、GraphRAG、Mem0 等)在显式集合上表现尚可,但在隐式集合(PrefEval Implicit)上断崖式下跌(通常在 35%~50% 徘徊)。
- LGM 在隐式偏好上取得了压倒性优势:在 Qwen2.5-7B 上达到 81.40%,在 Gemma3-4B 上达到 76.60%。这证明通过 SAE 将隐状态解耦为抽象概念,对于“无字面重叠就搜不到”的问题提升还是非常大的。
- 极强抗衰减能力:打破“128K 性能骤降”魔咒:
- 大多数基线在上下文从 32K 扩大到 128K 时性能严重滑坡。例如:
- GraphRAG 从 63.79% 暴跌到 38.24%;
- 最强基线 MemCoE 从 57.06% 下滑至 47.24%。
- LGM 反而在 128K 下稳中有升:Qwen 上从 64.23%(32K)微涨至 65.00%(128K);Gemma 上从 62.31% 上升至 66.34%。
- 原因:LGM 是分块将历史编码为隐节点,记忆量的增加只体现为图节点的增多,完全绕开了 Transformer 长上下文的注意力分散(Attention Dilution)和“迷失中间”问题。
- 大多数基线在上下文从 32K 扩大到 128K 时性能严重滑坡。例如:
4.3 隐式推理极限压力测试
在纯隐式个性化评测 PersonaMem-v2 上,LGM 使用轻量级的 Qwen3-4B 开源小模型,pk顶级闭源旗舰模型:
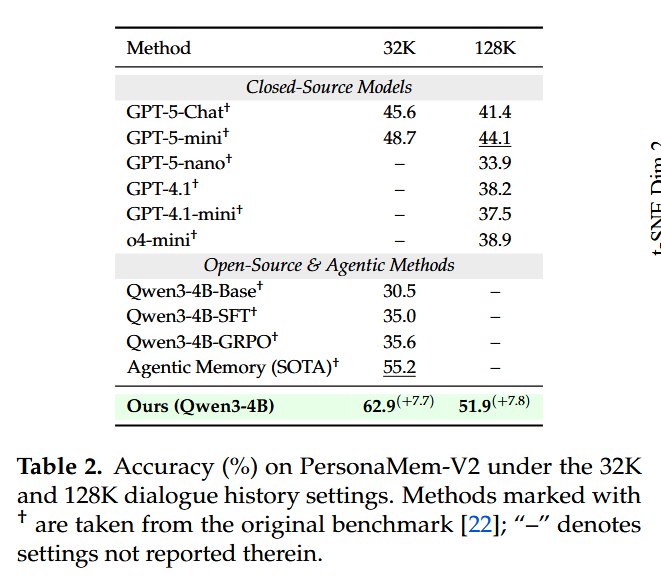
- 相比同尺寸的开源强化学习对齐或智能体记忆方法(55.2%),LGM 提升了 +7.7%。
- 即使面对 GPT-5-mini(48.7% / 44.1%)和 GPT-5-Chat(45.6% / 41.4%),仅有 4B 规模的 LGM 依然在 32K 和 128K 两个设定下全面实现超越。
- 说明长程个性化推理的核心瓶颈在于“记忆的组织机制与表示形态”,而非单纯堆砌模型参数量。
4.4 推理效率与系统开销对比
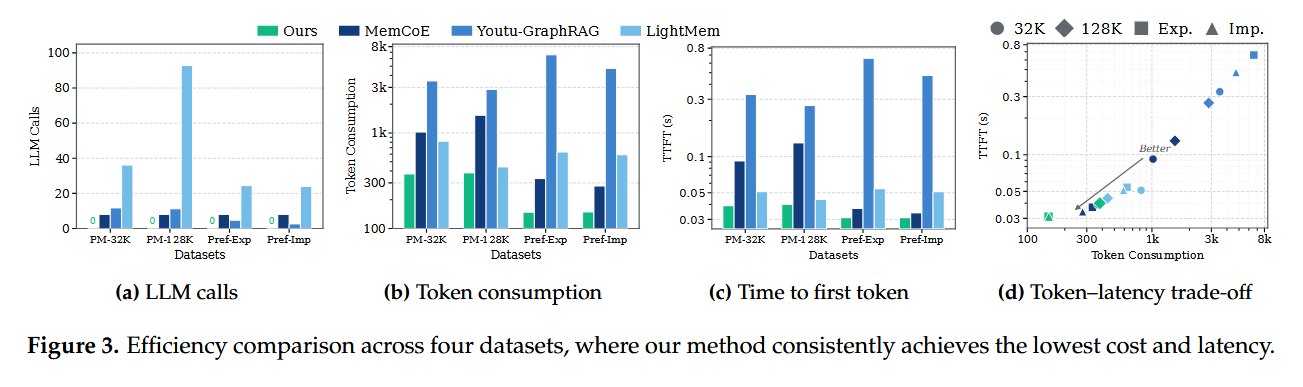
论文在四个维度全面对比了系统资源开销(对比 MemCoE、Youtu-GraphRAG、LightMem):
- LLM 调用次数(LLM Calls):
- 传统 Agentic Memory(如 LightMem、MemCoE)在检索、摘要、更新记忆时,每次响应前需要调用 10 到 80+ 次额外的 LLM;
- LGM 为 0 次额外 LLM 调用(全流程在紧凑的前向隐空间完成,只在最终生成答案时调用 1 次 LLM)。
- Token 消耗量(Token Consumption):
- 传统方法需要回放检索出的文本,单次推理需消耗 1,000 ~ 8,000+ 个上下文 Token;
- LGM 始终维持在 100 左右(仅占用 16 个 Soft Prefix 向量 + 当前 Query)。
- 首字延迟(TTFT,Time to First Token):
- 传统方法延迟在 0.3s ~ 0.8s 之间,且随历史增长急剧变慢;
- LGM 的 TTFT 稳定在 0.03s ~ 0.05s,大幅降低用户交互等待时间。
- 帕累托最优边界(Trade-off):
- 在 Token–Latency 关系图中,LGM 稳稳占据了“最高准确率 + 最低计算延迟”的最左下角黄金边界。
4.5 消融实验深度解析
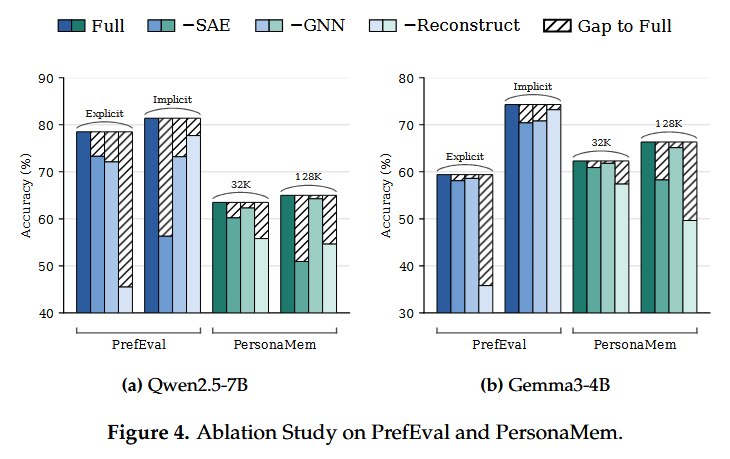
各模块移除后的影响程度:
[-Reconstruct 损失] >>>>> [-SAE 稀疏概念分解] > [-GNN 图消息传递]
- 移除证据重构损失($-\text{Reconstruct}$)的影响最为致命:
- 准确率发生崩塌式下滑,尤其在隐式偏好上跌幅最大。
- 机理印证:验证了作者的假设——如果缺少重构监督,模型会倾向于直接忽略软前缀(潜空间坍塌)。通过强制让 Prefix 解码出底层证据文本,才真正迫使 Prefix 承载不可替代的事实信息。
- 移除稀疏自编码器($-\text{SAE}$):
- 改为直接使用稠密隐向量计算连边。结果在隐式偏好上出现明显退化。
- 说明稠密向量中的语法、情感杂质干扰了连边权重的构建,必须通过 SAE 提取解耦的概念。
- 移除图消息传递($-\text{GNN}$):
- 剥离了多轮节点交互。性能受损说明多步消息传递成功起到了“将分布在多轮对话中的微弱线索聚合强化”的作用。
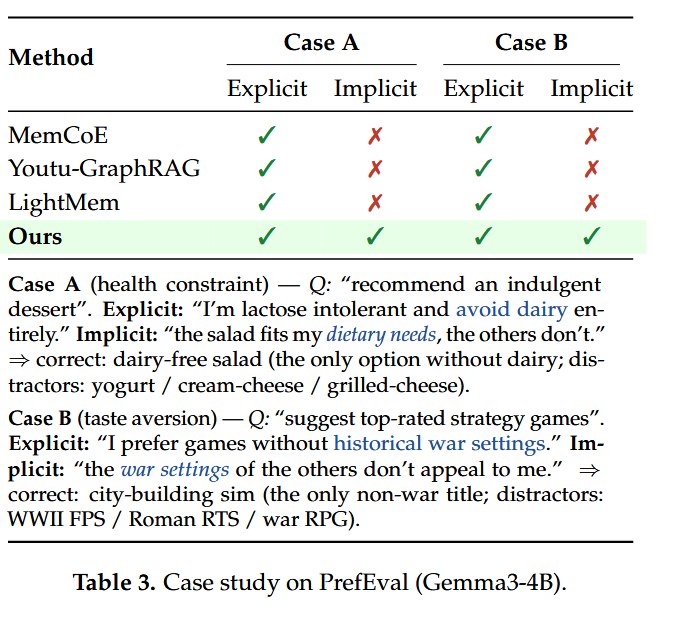
两个 case study 表明:文本表面不相似的乳制品限制、厌恶战争题材,LGM 都可选到偏好一致的回答;它们展示 intended mechanism,但不足以代替系统化错误分析。
五、结论
总的来说,这篇工作的方法的角度很值得学习,在benchmark上的也比较很亮眼,消融部分也说明 SAE 做稀疏确实有效。
不过我可能比较关心开源之后,能不能打过前几天很火的 naive rag 薄纱一众 agent memory 方案的 rag baseline:)
因为感觉可能rag那边做一下重排也能达到类似的效果……
说些什么吧!