
零、写在前面
A/ 这篇 agent memory 的 report 最近热度还蛮高的,读了一下,行文很流畅,方法也比较简洁,有一种当初读 CoT 论文的感觉。
也是我早期一直在想的一个问题,现在 model 能力越来越强,复杂的 harness 设计是否会带来负面效果。、
这篇 report 展示了,像 CoT 那样,即使只有一条 prompt,也能做到很好的 agent memory 效果。
很喜欢 report 开头引用了存在主义奠基人 索伦·克尔凯郭尔(Søren Kierkegaard)曾写下的话:
life can only be understood backward, but it must be lived forward.
生活只能向后理解(backward),但必须向前生活(forward)。
我们 Agent Memory 的设计也面临着相同的困境。
一、Dreaming
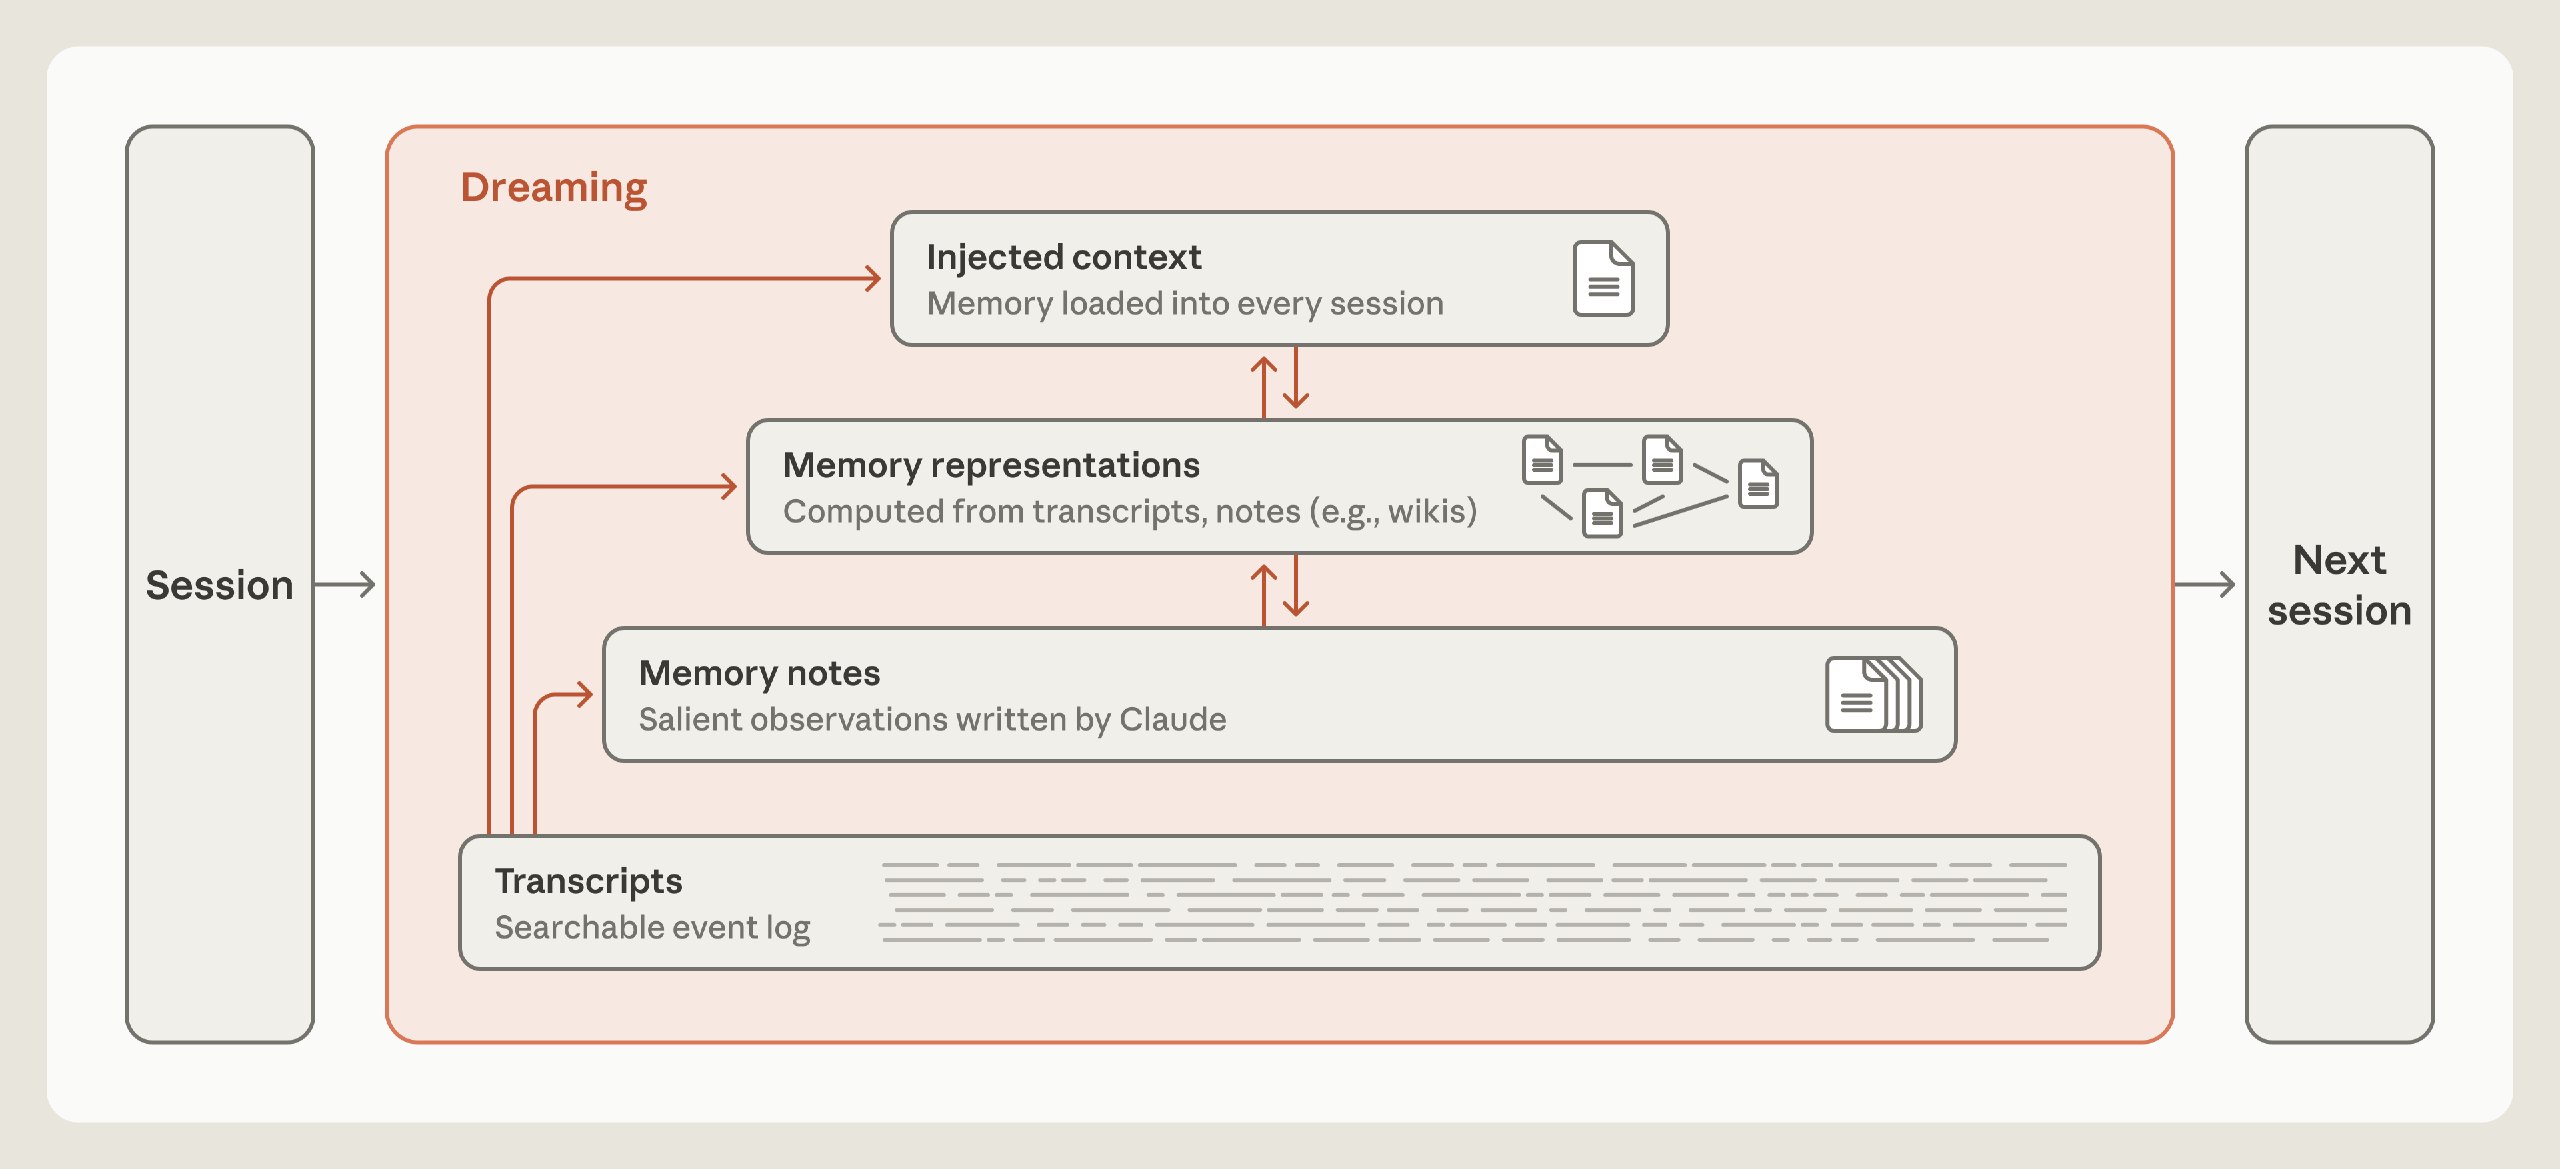
很多 memory 工作都会用认知科学里面的海马体理论来包装,这篇 report 也一样。
作为人类,我们在日常生活中无时无刻不在对记忆进行编码。海马体(Hippocampus)在此过程中扮演着核心角色——它实时捕捉当下的经历,使记忆得以迅速成型并立即可用。然而,只有部分经历最终会被固化(consolidate)为长期知识。
这种固化过程大部分发生在人类大脑处于“离线”状态时。当我们入睡以及处于安静的休息状态时,海马体会重新回放(replay)我们近期的经历。科学界认为,这一机制会逐步提炼这些经历并将它们整合到大脑新皮质(neocortex)中——新皮质正是人类大脑中存储我们绝大部分已知知识的区域。
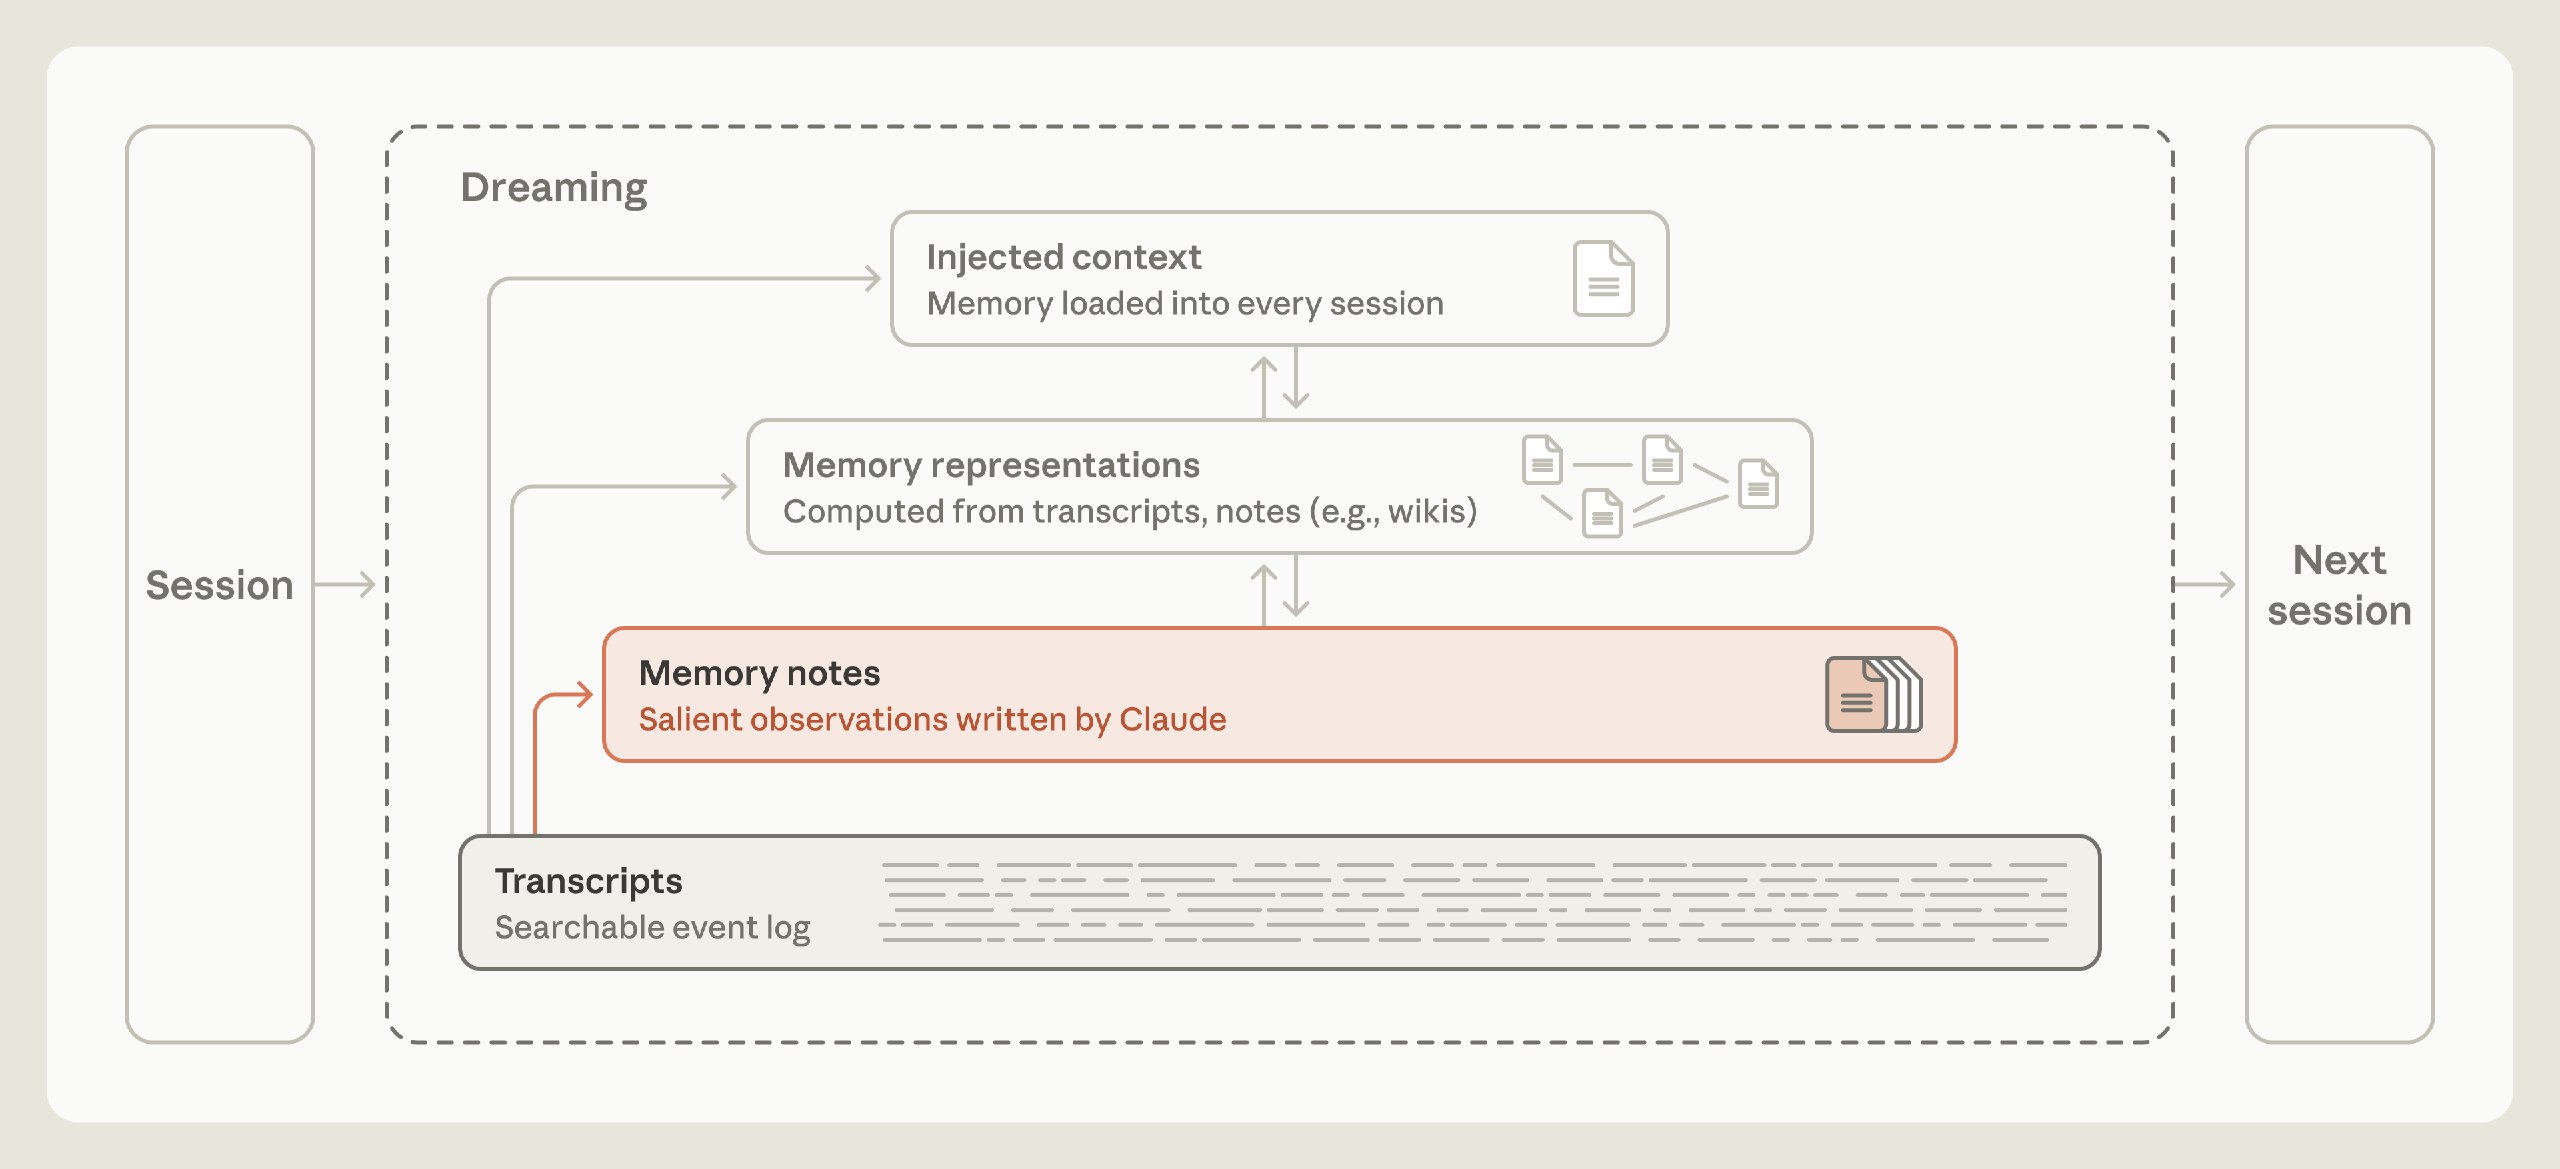
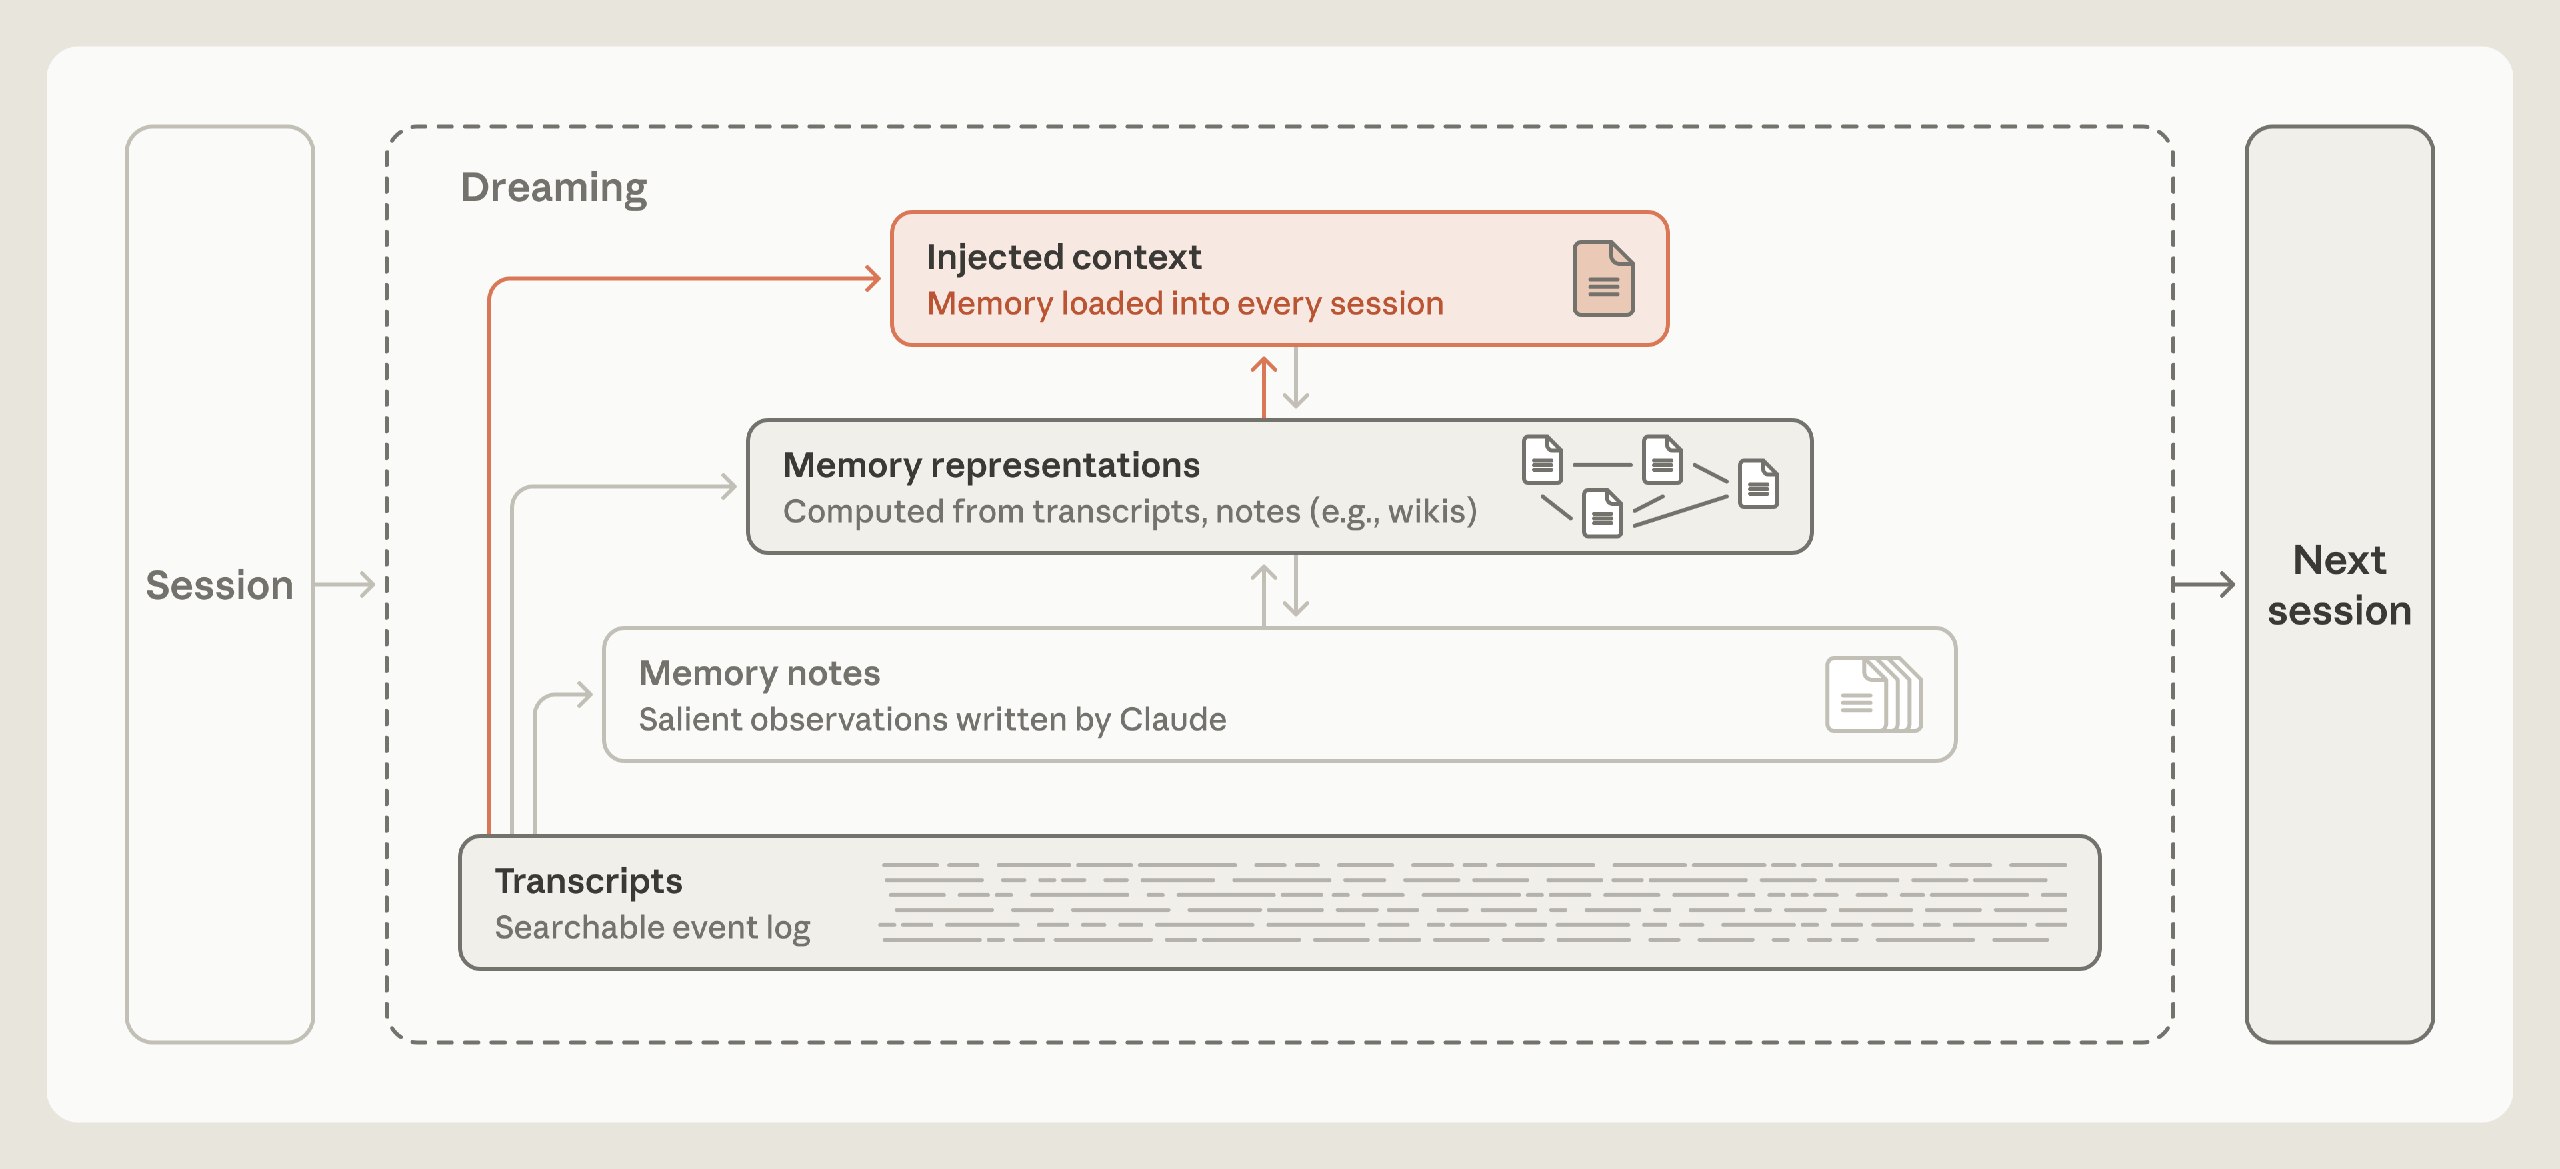
A/ 设计的 Dreaming 机制也是这样,框架就是上图,采用了现在比较常见的分层设计。
1.1 Memory notes
本文定义的“Agent memory”,特指 Claude 从过往经验中获得的知识——包括与用户的互动以及被指派的任务经历——并且这些知识能够在不同会话之间持久保留,保存为供后续读取的上下文内容。该定义明确排除了模型学习或管理上下文的其他机制,例如权重微调(weights updates,即训练期间设定的内部模型参数)、in-context learning(单次对话会话内获得的知识),以及 compaction(由 Claude 编写的对话摘要,用于替换早期轮次,以便在新的上下文窗口中继续工作)。
agent memory 和上下文管理工作还是要区分开的,很多时候读论文会发现,上下文管理的论文标题也会自称 memory。
个人觉得上下文工程其实是早期计算的副产物,设计 kvcache 来加速 next token 计算过程中的注意力计算,但是随着 llm 展现出越来越强的语言能力,并且这种语言能力可以转化为 agent 能力后,设计与 harness 配套的 memory 自然也是必要的。
在人类大脑中,经历之前、期间或之后释放的化学信号能够将某段记忆标记为重要。被标记的记忆在离线期间往往比未被标记的记忆获得更频繁的回放。这一称为“重放(replay)”的过程有助于稳定记忆并将其整合到长期记忆中。
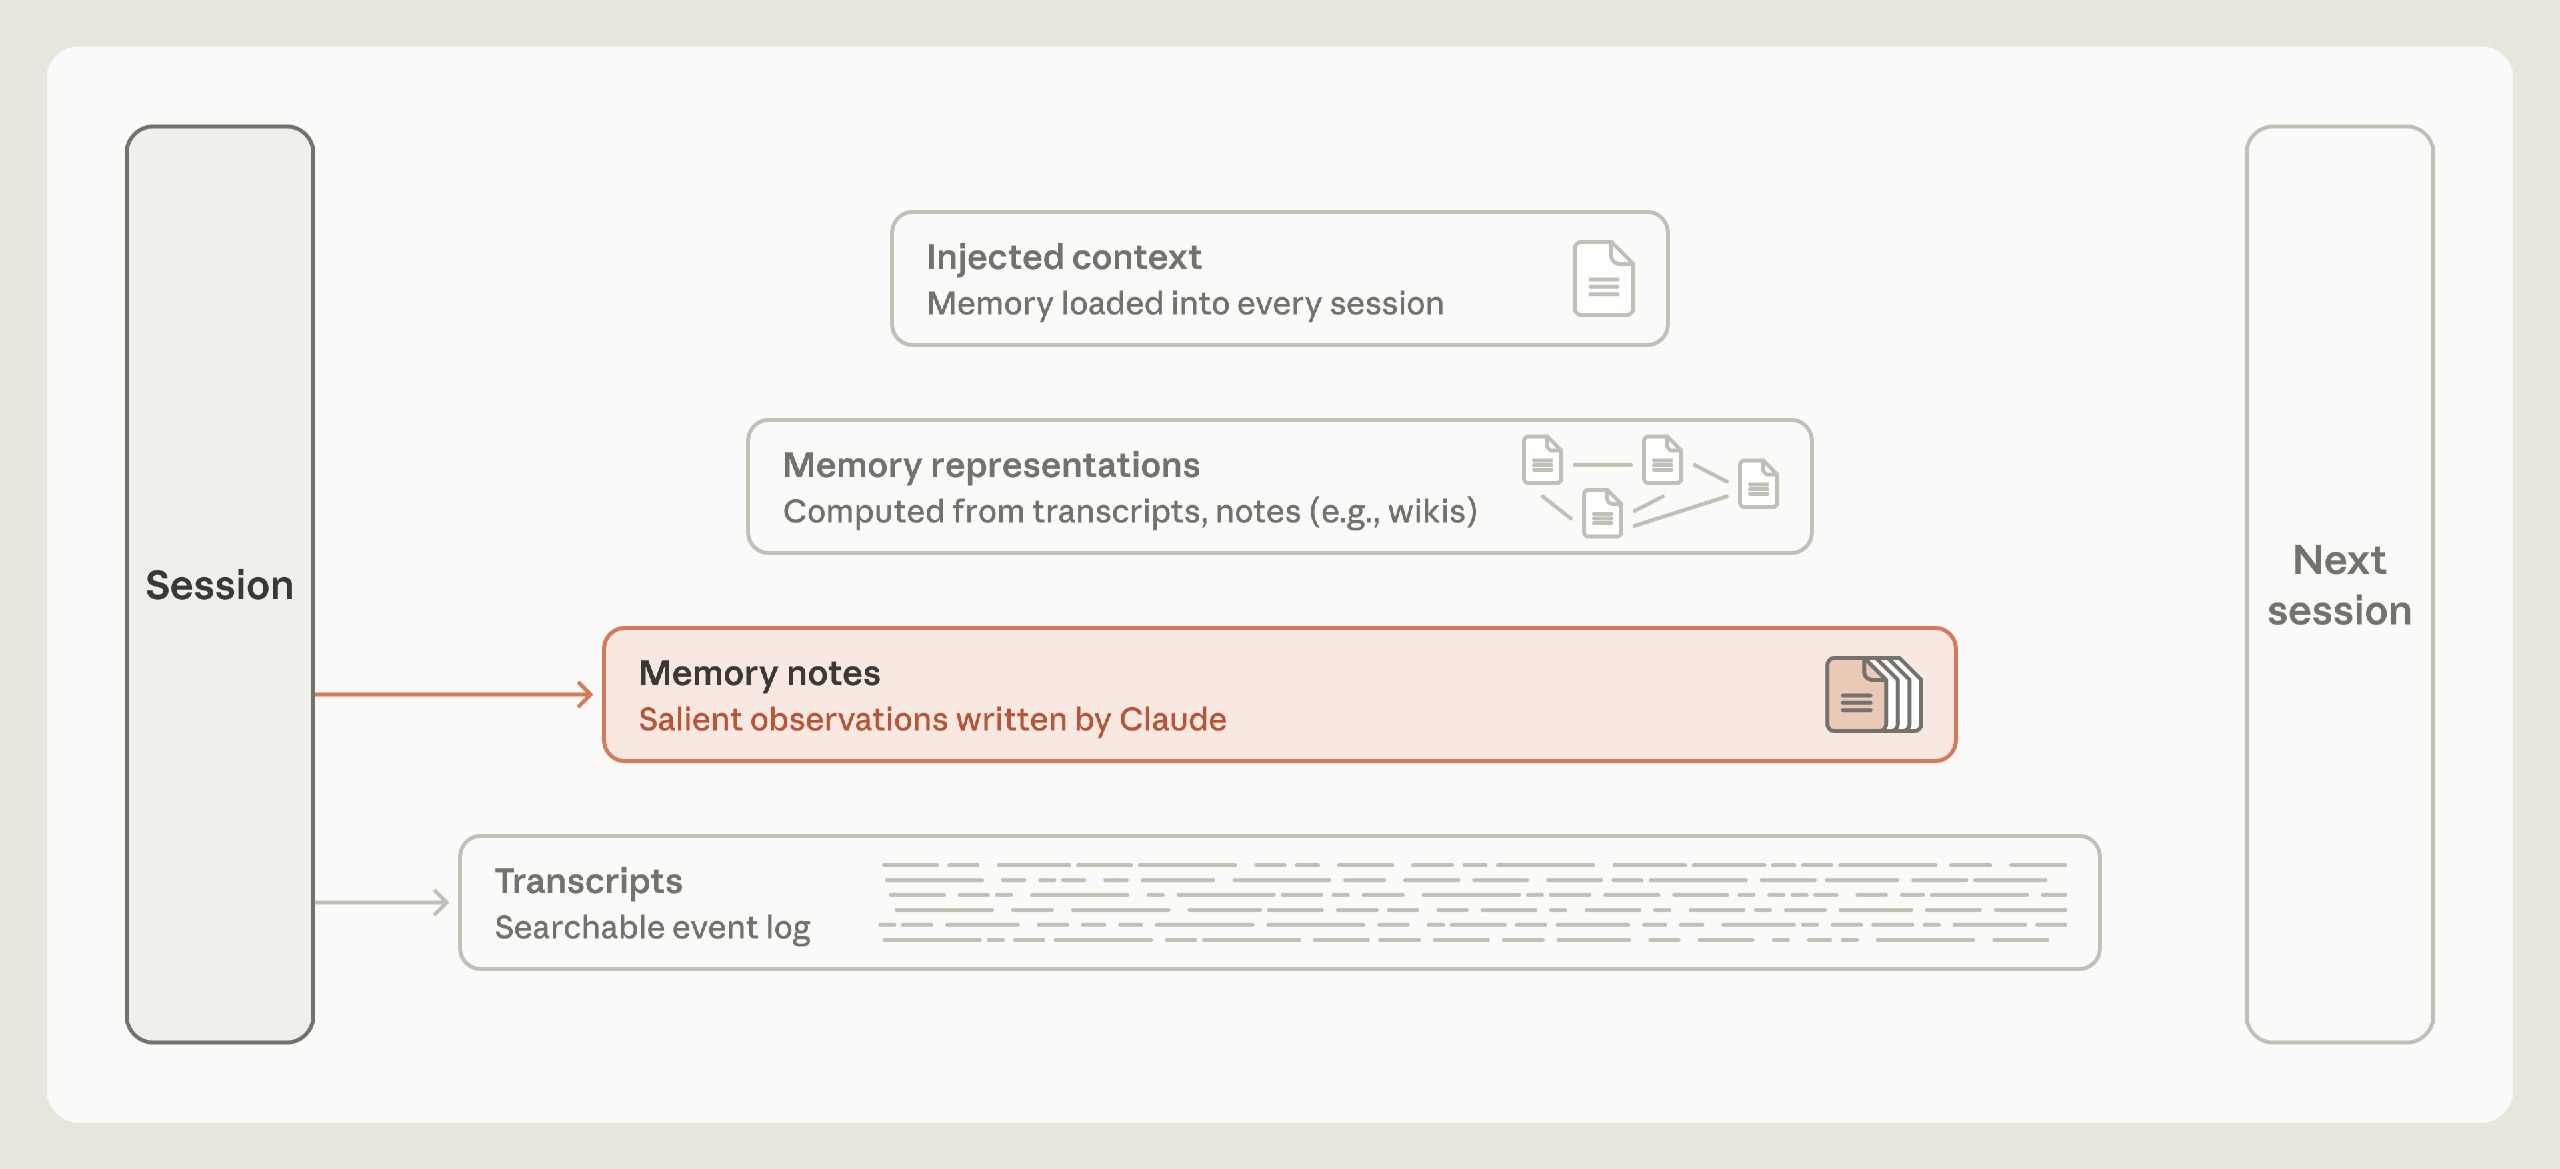
类似地,Claude 也可以在会话日志中实时标记显著事件(salient events),以便后续更容易检索;或者直接将它们写入 memory 存储介质中,例如一个由 memory notes 组成的文件目录(见下图)。但在未知后续任务发展的情况下,Claude 如何在当前时刻准确判断出哪些信息具有显著性(salient)?
1.2 Memory 是对未来需求的预测
我们 Memory 是在做什么?——预测。
**当 Agent 记下一条规则时,它其实是在预测其描述的模式在未来还会再次出现并发挥作用。**例如,记下一个经验证的事实,就是在预测未来会话中的 Agent 会希望直接依赖该事实,而无需重复验证。随着模型能力的演进,Claude 在做出这类预测方面变得越来越出色。
以 Continual Learning Bench (CL-Bench) 1.0 中的一项任务为例,该基准测试专门评估 Agent 运用 memory 解决长程任务(long-horizon tasks)的能力。其中有一项具体任务要求 Claude 通过在数据库中查找信息来回答一系列问题。在 Claude 给出答案后,系统会告知其正确答案,此时 Claude 可以写入一条 memory,以帮助回答后续的问题。
在这个场景中,Memory 可以构建起一个学习闭环(learning loop)。如果 Claude 答错了一个问题,它可以记录下这次失败,提出关于出错原因的假设理论,验证这些假设,并将最终发现总结为一条指导未来作答的规则。
我们通过 Claude Managed Agents 运行了 CL-Bench 1.0 任务。在处理每一个问题时,Claude 都在全新的会话中冷启动,唯一的例外是:它可以从跨会话持久存在的 memory 目录中检索文件。
不同代际的模型在构建自主学习闭环方面表现出了截然不同的能力:
- Claude Sonnet 4.6 仅仅停留在生成“为什么会答错”的理论假设阶段。它的 memory 目录中零散分布着多个文件,每个文件都罗列着若干未经测试的猜想。
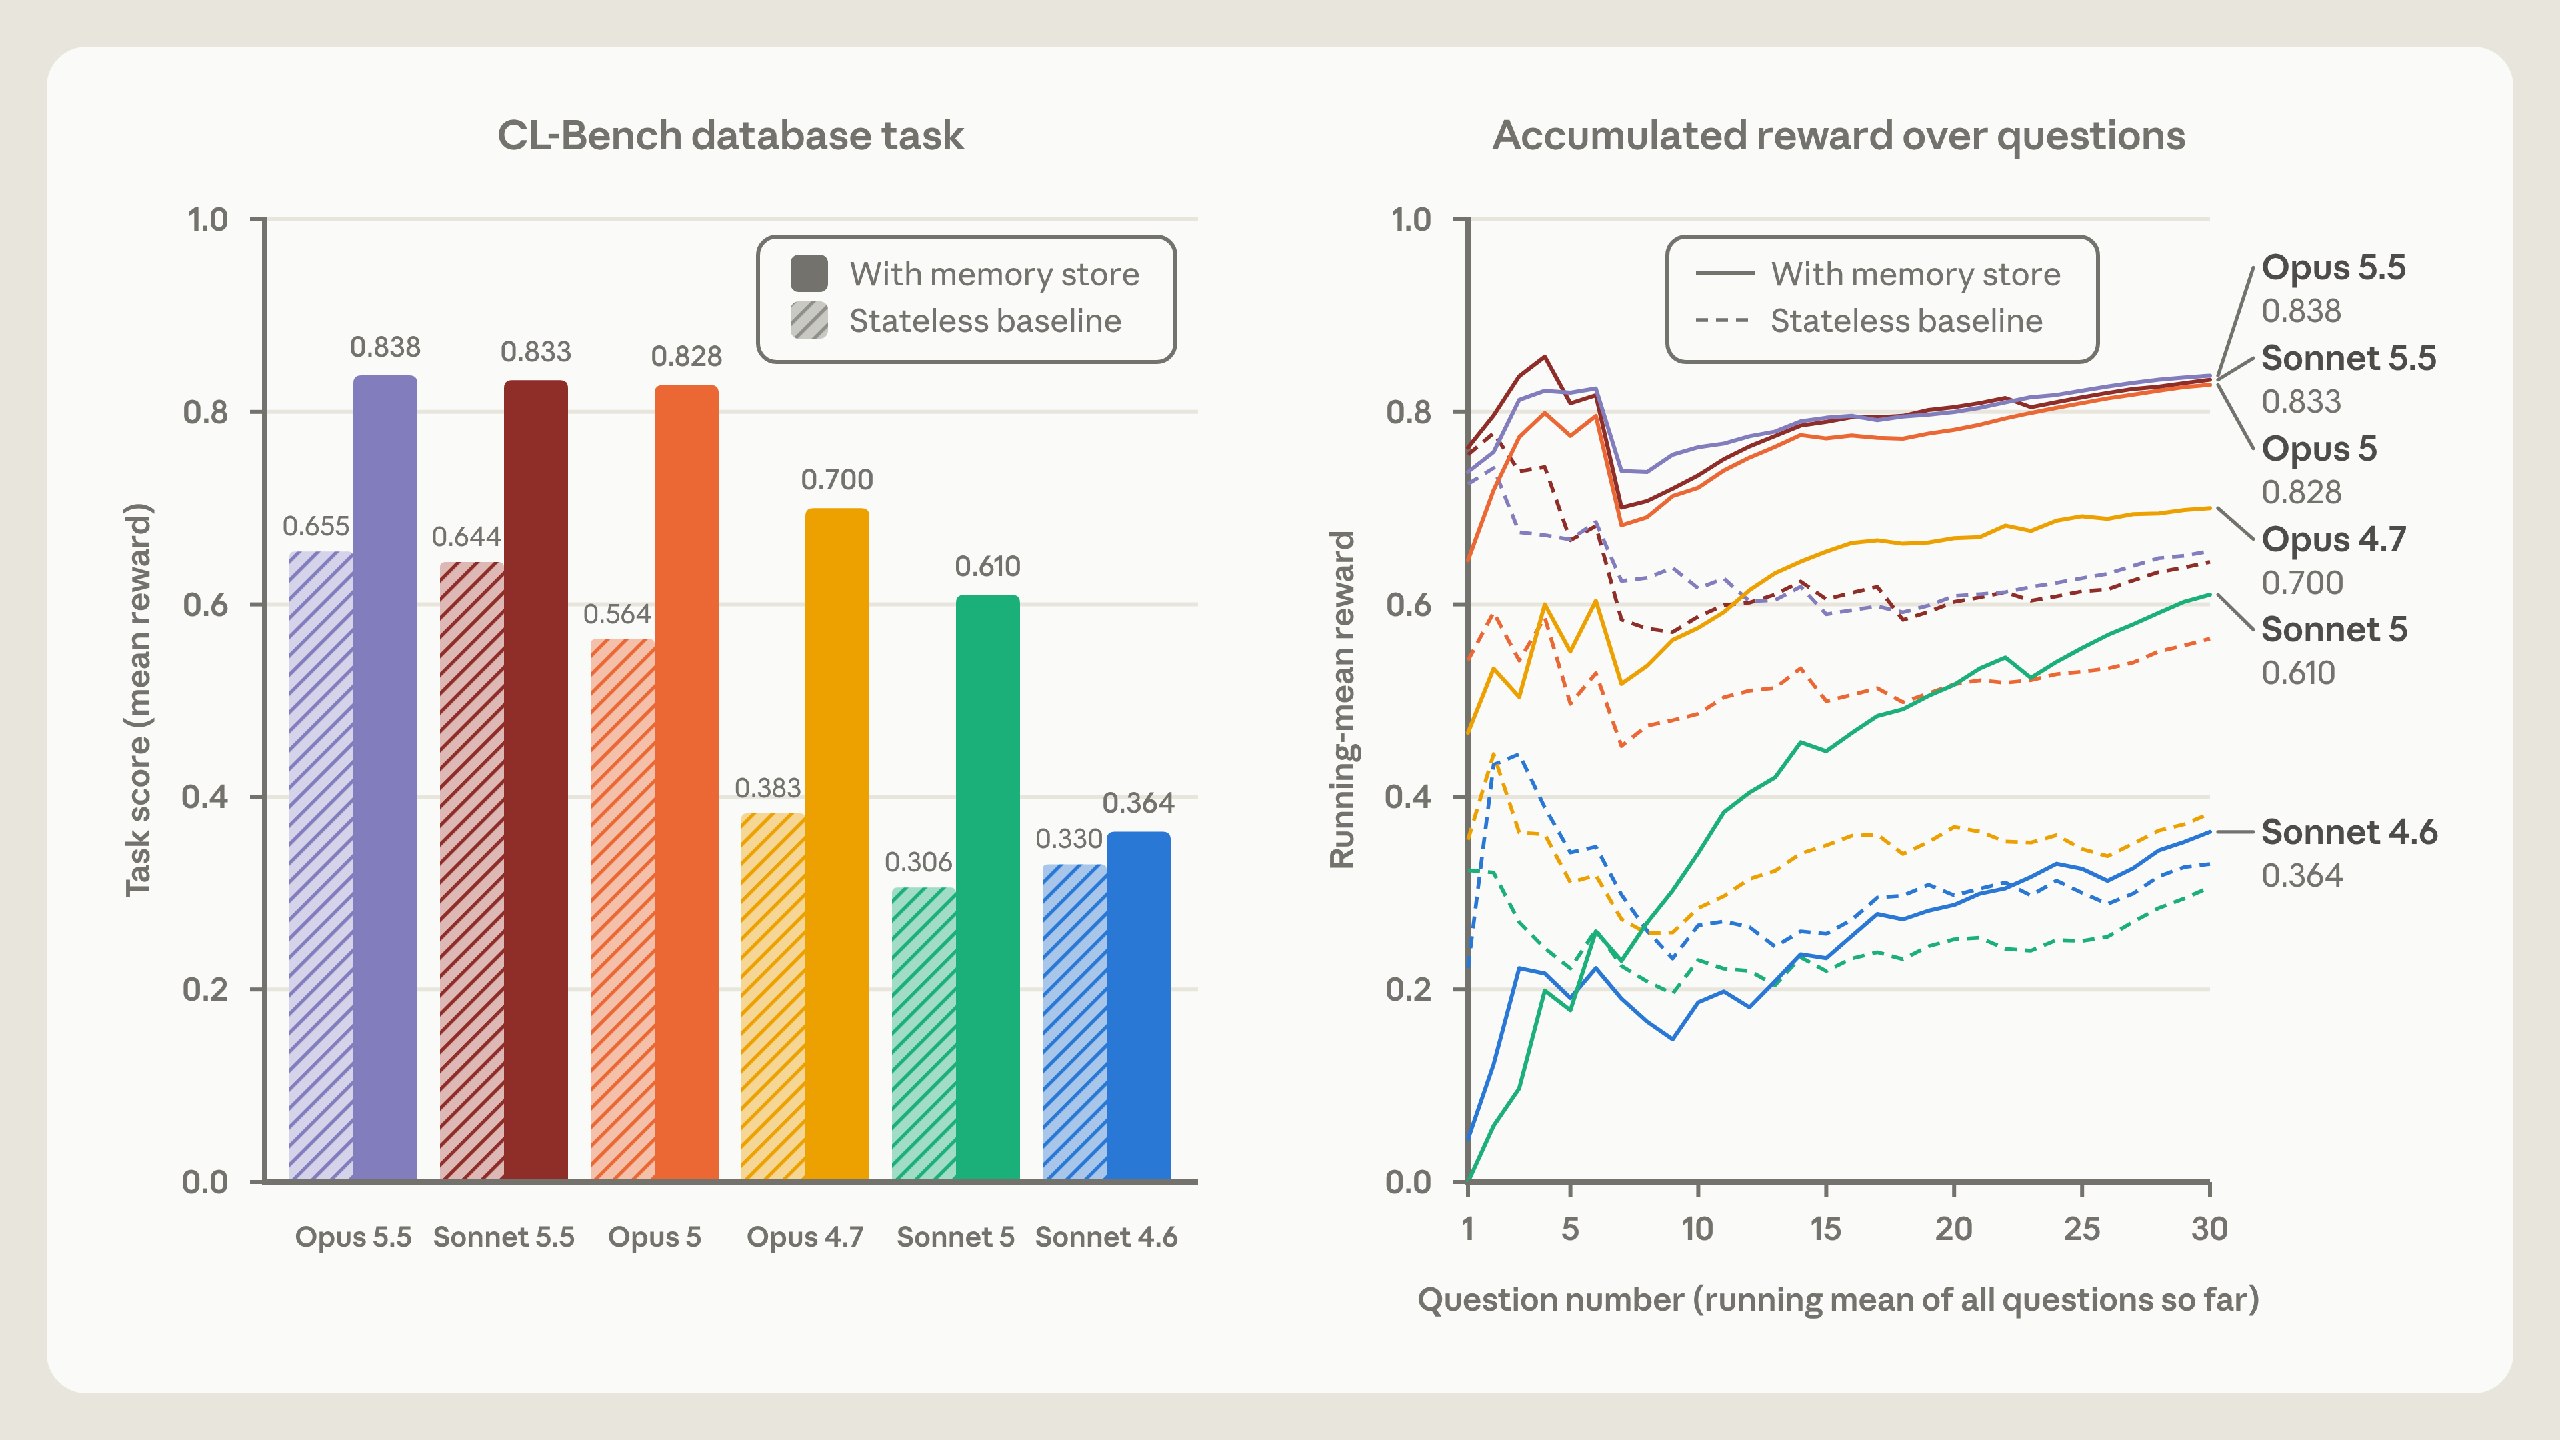
- Claude Opus 4.7 将其零散笔记合并成了一份统一的参考文档,并开始标记哪些事实已被核实、哪些仍待确认。
- Claude Sonnet 5 会在评分器验证后将答案标记为已确认,并在答错时写下纠错笔记。
- Claude Opus 5 是这些模型中第一个**成功完成学习闭环(close the loop)**的模型。它的绝大多数条目都包含明确的规则(以及它是如何得知该规则属实的证据)、早期问题的已知答案,以及对探索过程中发现的陷阱的清晰警示(见图 3)。
- 与 Opus 5 类似,Claude Opus 5.5 和 Claude Sonnet 5.5 均成功闭环,能够使用 memory 固化经过验证的规则来指导未来回答。在配备 memory 的情况下,两者的得分与 Opus 5 相当(约为 0.83+),不过它们在不配备 memory 时的初始基线性能略高一筹。
1.3 Claude 已经学会判断信息的显著性
在我写这篇博客的时候,A/ 最新的旗舰应该已经是 Fable 5.2,过去的一年,各大模型厂商在模型后训练上投入了巨大的成本,换来了更强的 coding、math、computer use 等能力。记得去年10月我在 claude code 里面用过 claude 3.7,当时的效果其实还是比较难绷的,写个前端都不太行,但到今天,已经各种 ai 视频、ai ppt 满天飞了……
Anthropic 测试了 Claude 游玩《宝可梦 红》(Pokémon Red)游戏的能力。这款游戏对 Claude 解决复杂的长程导航任务构成了极高挑战,因而被我们用作检验 Claude 判断哪些内容值得存入 memory 的测试场。在每次运行开始时,我们为模型挂载了一个 memory 文件目录,模型可以在游玩过程中自由读取和写入。
对比了 Claude Sonnet 3.7 和 Claude Fable 5 各自在游戏中进行了约 10,000 步时的 memory 目录。我们观察到的一个核心差异在于:两个模型认为什么才是“值得记住的信息”。
- Sonnet 3.7 假设一切信息可能都有用,因此不加甄别地全盘记录。它的 memory 文件夹充斥着流水账式的遭遇记录,通常每一次战斗、拾取到的每一个道具、偶遇的每一个 NPC 都会单独创建一个独立文件。最终,Sonnet 3.7 在 225 个文件夹中写入了多达 413 个 memory 文件(文本总量达 977,930 字符),但仅赢得了 1 枚徽章(徽章是玩家在游戏中通关进度的核心里程碑)。
- 相比之下,Fable 5 仅在 2 个文件夹中编写了 9 个文件,外加 1 个名为
global.md的顶级仪表板文件(文本总量仅 43,406 字符),却斩获了 4 枚徽章。
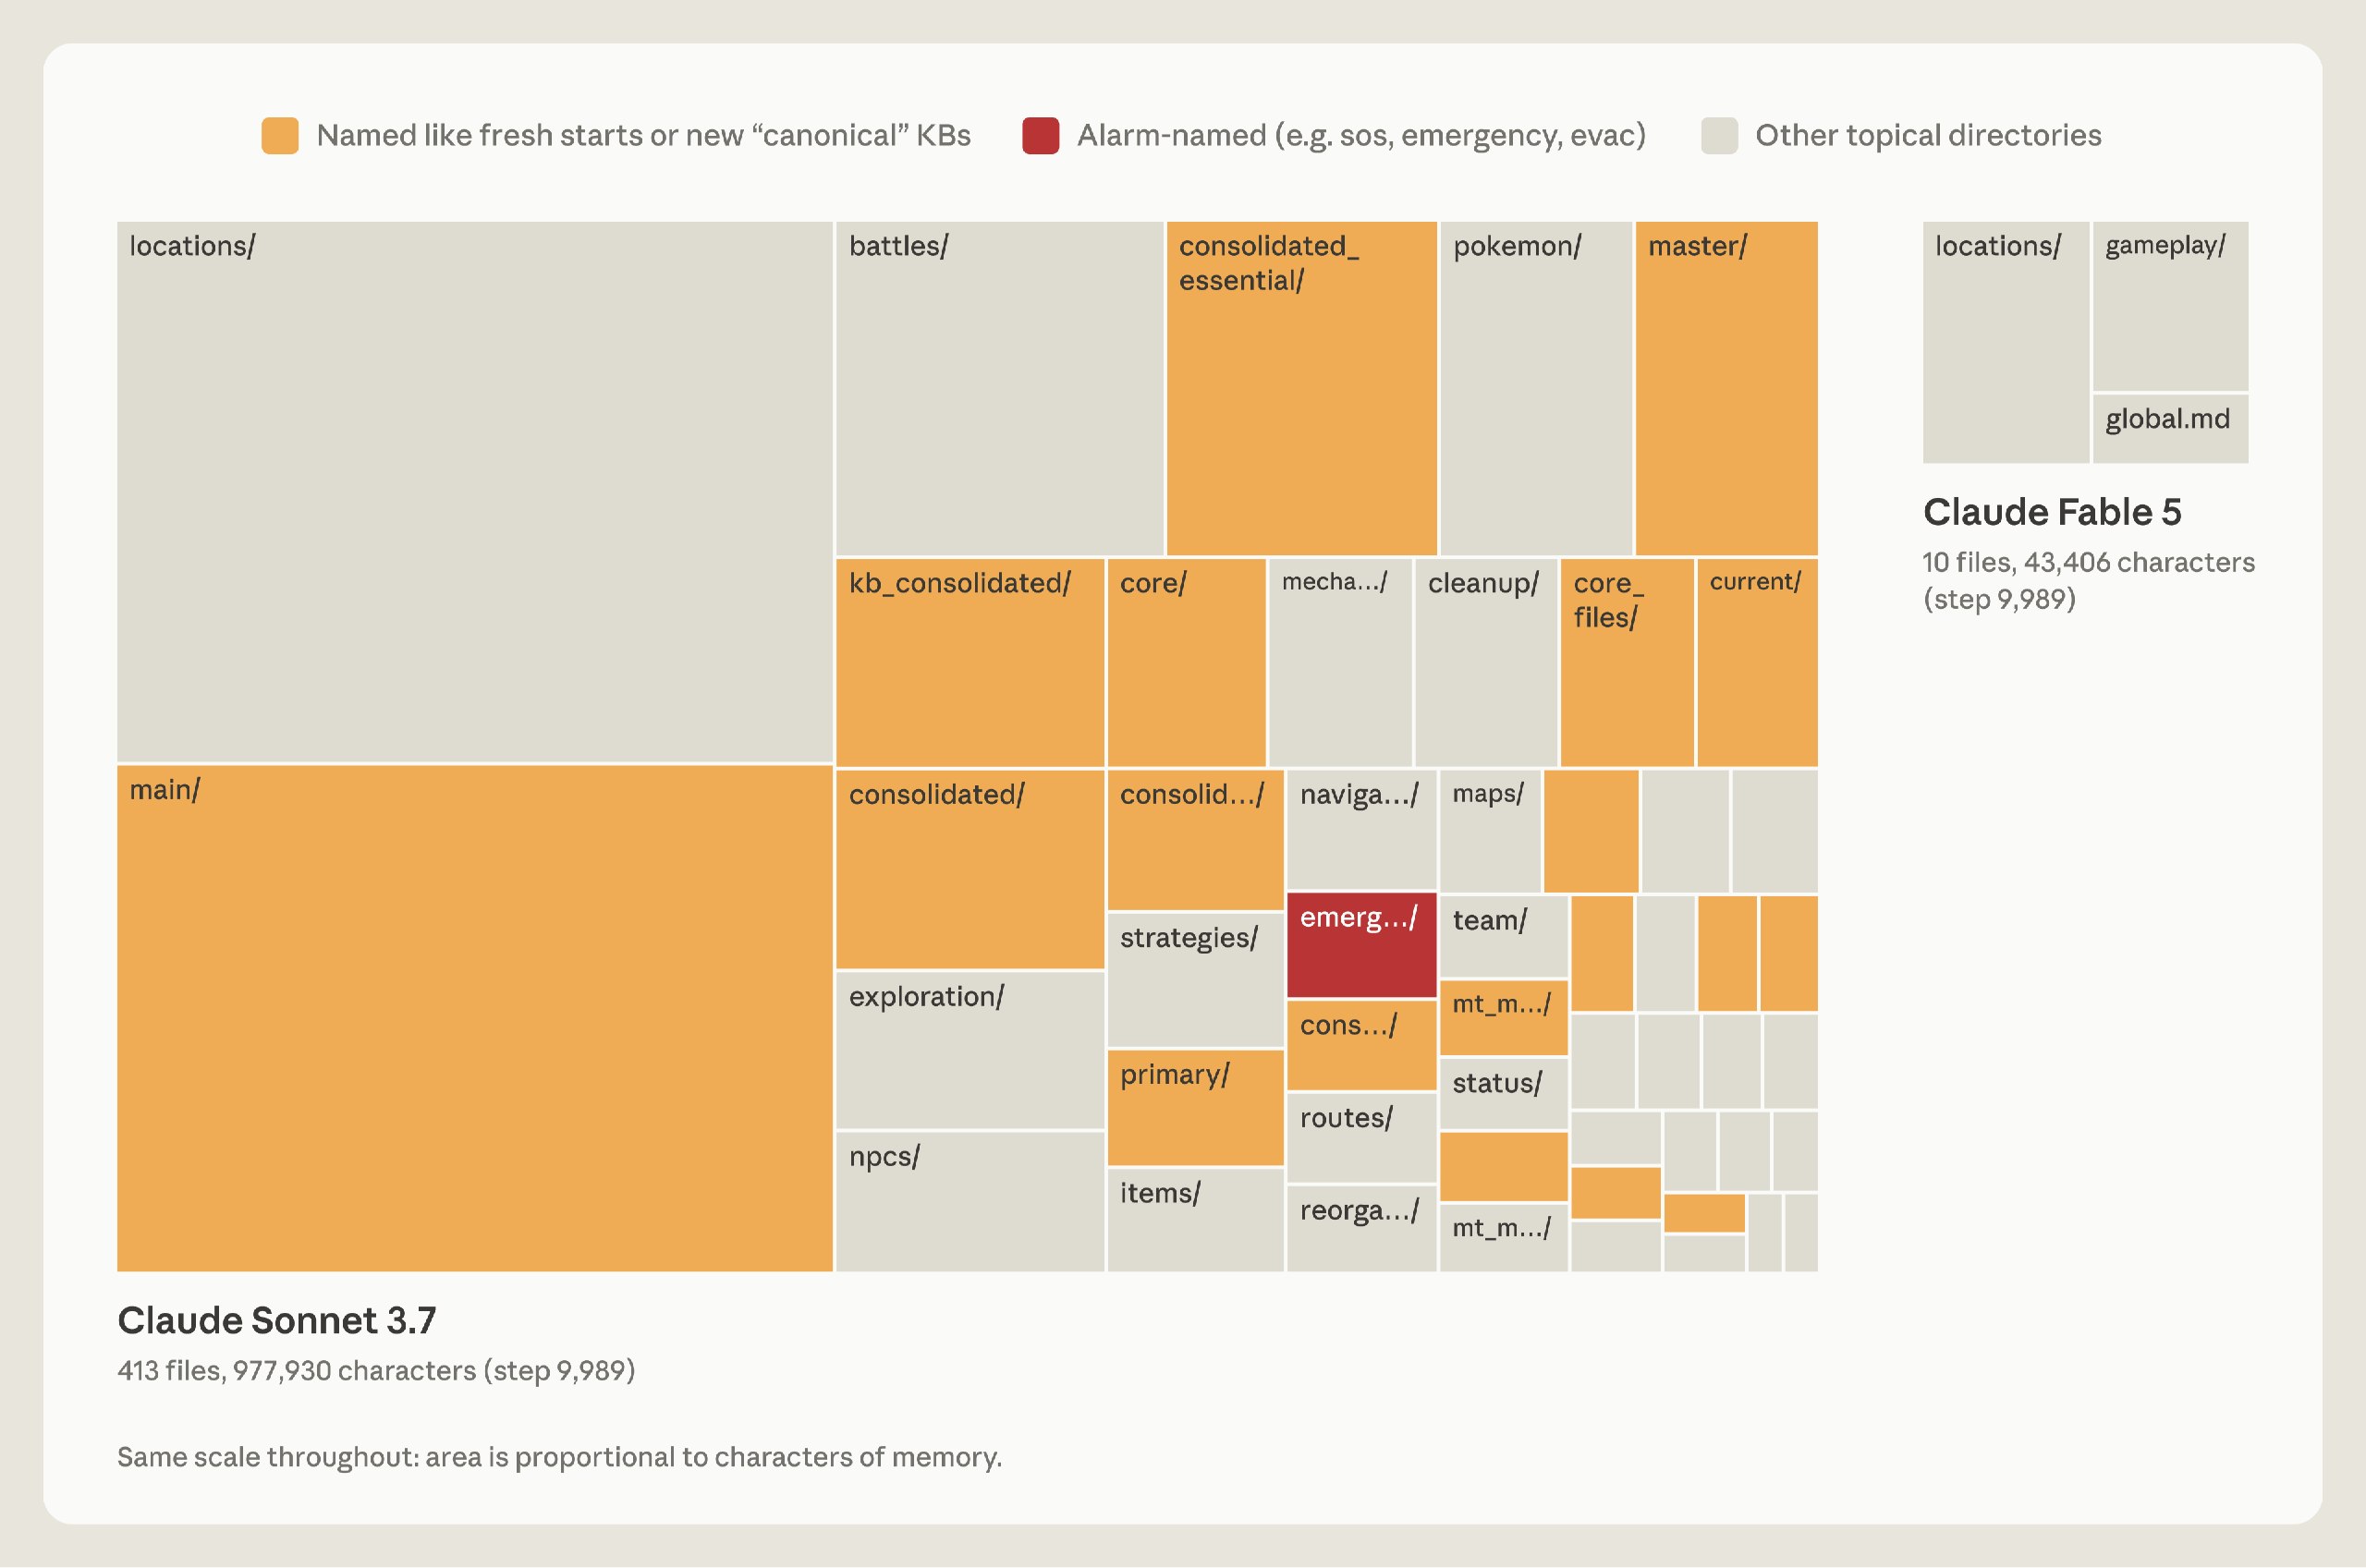
Sonnet 3.7 的做法导致了严重问题,主要是因为《宝可梦》的游戏状态处于持续剧烈变化中——Sonnet 3.7 记录的事无巨细的详尽状态在瞬间就会过时。结果是,随着游戏推进,Claude 不得不花费越来越多的时间和计算资源在浩瀚的旧 memory 中翻找梳理,反而无法专注于玩游戏本身。例如在第 10,000 步左右,Sonnet 3.7 甚至开辟了第四个“master”主记忆文件夹;在接下来的 17 步里,它创建了 6 个文件、删除了 9 个文件,期间在游戏内没有做出任何实际行动。
相反,Fable 5 的策略是将 memory 严格限制在游戏本身没有显式提供的信息上。Sonnet 3.7 写入 memory 的许多信息(例如当前玩家有多少钱、在地图上的具体坐标等),在每一轮交互中都能直接从当前屏幕画面读取,因此将其写入 memory 完全是冗余的。相反,关于核心策略、路线规划和经过实测验证的机制规则,只有当 Claude 亲自推导归纳时才会存在,如果不写下来就会随上下文遗失。
Fable 5 据此严谨组织其 memory 架构:
- 其顶级
global.md文件扮演了全局仪表板的角色,记录当前核心目标、挑战道馆(赢得徽章的关键关卡)的预案,以及模型使用 memory 的自身准则; locations文件夹存放特定路线的导航走法规划;gameplay文件夹存放基于实战经验归纳的游戏机制策略。例如,在连续投掷 7 个精灵球(Poké Balls)均未能捕捉到鲤鱼王(Magikarp,游戏中极易捕捉的宝可梦之一)后,Claude 总结道:“如果连续 3 次以上捕捉失败,必须改变时机(在菜单步骤之间插入额外的等待操作)——在这样做之后立刻就成功捕获了。”
凭借极其精简克制的 memory 目录,Fable 5 的游戏通关进度远远超越了 Sonnet 3.7。Opus 5.5 也采取了类似的极简策略:它维护着一个精简的 memory notes 文件夹以跟踪当前目标和下一步动作,边玩边实时重写更新,并最终成功通关了整个游戏。
1.4 引导 Claude 编写 Memory
Report 发现:告诉 Claude memory 的用途,而不是规定其“如何具体使用”,效果往往最好。在 CL-Bench 基准中,我们仅仅告知 Claude 有一个可用的 memory 文件夹。这种宽泛概括的引导足以让 Opus 4.7 和 Opus 5 高效自发地利用 memory,并在基准测试中获得显著的性能跃升(见图 3)。
我们还测试了给模型设定关于“应该往 memory 中写入什么”的具体规则(每次测试施加单一硬性规则)。我们对比了在不同规则约束下,模型从 memory 中获得的收益与其自由发挥时的收益差异。当我们将规则限制为“仅记录失败(record only failures)”时,Opus 5 和 Opus 4.7 借助 memory 所带来的性能收益均出现了大幅缩水(见图 5 右侧)。对于能力较强的前沿模型,赋予其自主评判信息显著性(salience)的自由,远比预先设定僵化的规则更为有效,过度的死板限制甚至会反向削弱模型的实际表现。
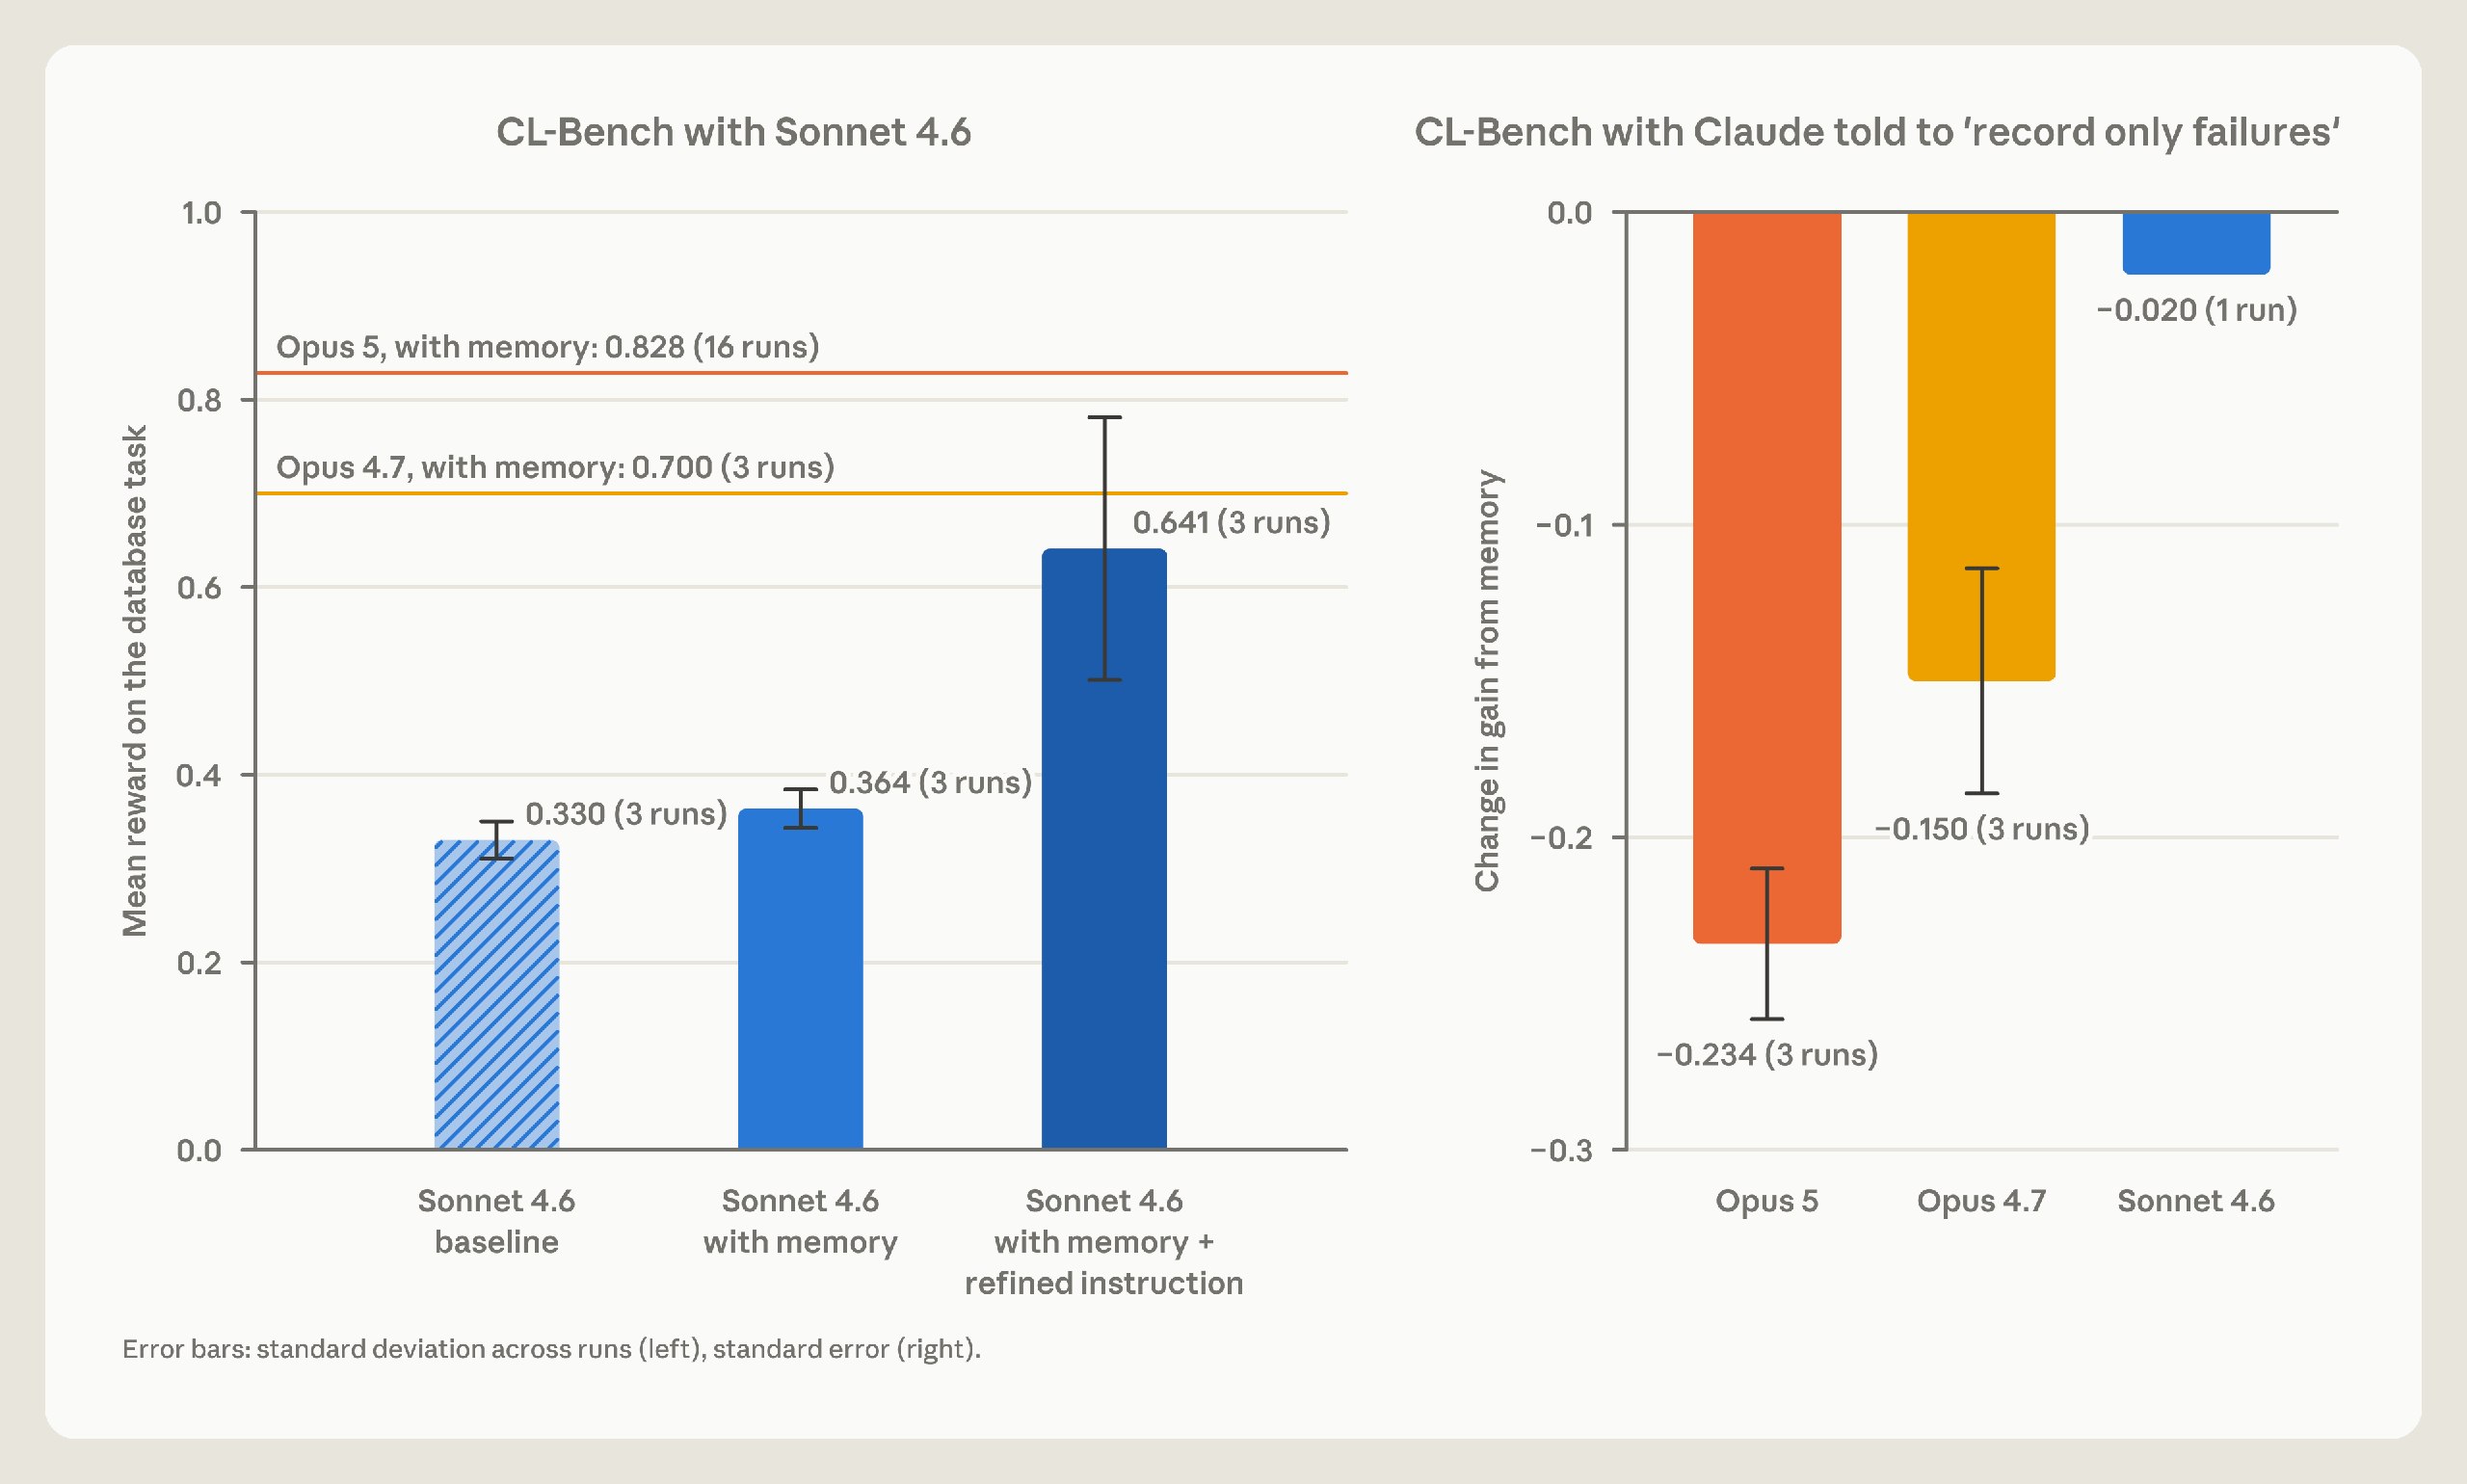
与此同时,我们注意到这种定向引导(steering)对代际较早的模型帮助最大。例如,Sonnet 4.6 经常不会主动去读取 memory 目录中的文件,也无法主动检验其关于答错原因的假设。
在这种情况下,通过 Prompt 引导 Claude 在回答前务必先阅读其 memory 文件,随后显式检验其假设理论,几乎使其基准得分翻了一倍(从 0.364 飙升至 0.641,见图 5 左侧)。而 Sonnet 5 已经具备了自主做到这一点的能力——在没有任何额外 Prompt 提示的情况下,它在 10 次回答中有 9 次会自发在作答前翻阅 memory。相比之下,Sonnet 4.6 自发查阅 memory 的频率还不到一半。
对于当前的前沿 Claude 模型,我们通常只给出极其简单的原则性指引:在用户明确要求时、或当信息明确具有长远价值时创建 memory notes,并将具体的显著性裁量权完全交由 Claude 自主定夺。
1.5 Dreaming 能够纠正 Memory 中的错误
既然 Claude 是根据会话内部即时判断的显著性来写入 memory 的,那么一条从一开始就存在误判、或者随着外部环境变化而过时的错误笔记,在未来的会话中就可能被后续的 Claude 盲目读取并深信不疑。
Dreaming(休眠期计算)为 Claude 提供了一种反向校对机制:将生成的笔记与最初的原始会话轨迹(transcripts)进行交叉核对。在 Claude 基于 Managed Agents 挂载 memory 目录玩《宝可梦》的实验中,我们观察到了一个极具代表性的成功范例。
在游戏的一个特定关卡中,玩家必须穿过月见山(Mt. Moon)——这是一个洞穴系统,其入口位于地图西侧,出口位于东侧。在洞穴入口附近隐藏着一个单向陷阱:一个单向跳下的岩石台阶(one-way ledge),一旦跳下就会跌落回之前来时的路线上,且没有任何办法直接攀爬回去。Claude 当时将宝可梦中心(PokéCenter,一座紧邻洞穴入口的建筑)作为核心地标,因此它是否会误踩台阶跌落,完全取决于它误以为宝可梦中心是在大山的西侧还是东侧。
在某一时刻,Claude 错误地在笔记中记下“宝可梦中心位于东侧”。于是,当它从宝可梦中心走出来时,它向自己宣布:“月见山已经在我的身后了”,并在笔记中自信更新道:“月见山 已完成(Mt Moon DONE)”。然而,月见山根本没有被跨越。几步操作之后,Claude 毫不犹豫地从台阶上跳了下去,直接跌回到了出发前的老路上(见下图)。由于它的导航工具并没有显示高低落差掉落机制,Claude 错误推断道:“我向西走过头了”,并误认为自己一直处在正确的东侧方向。事实截然相反。
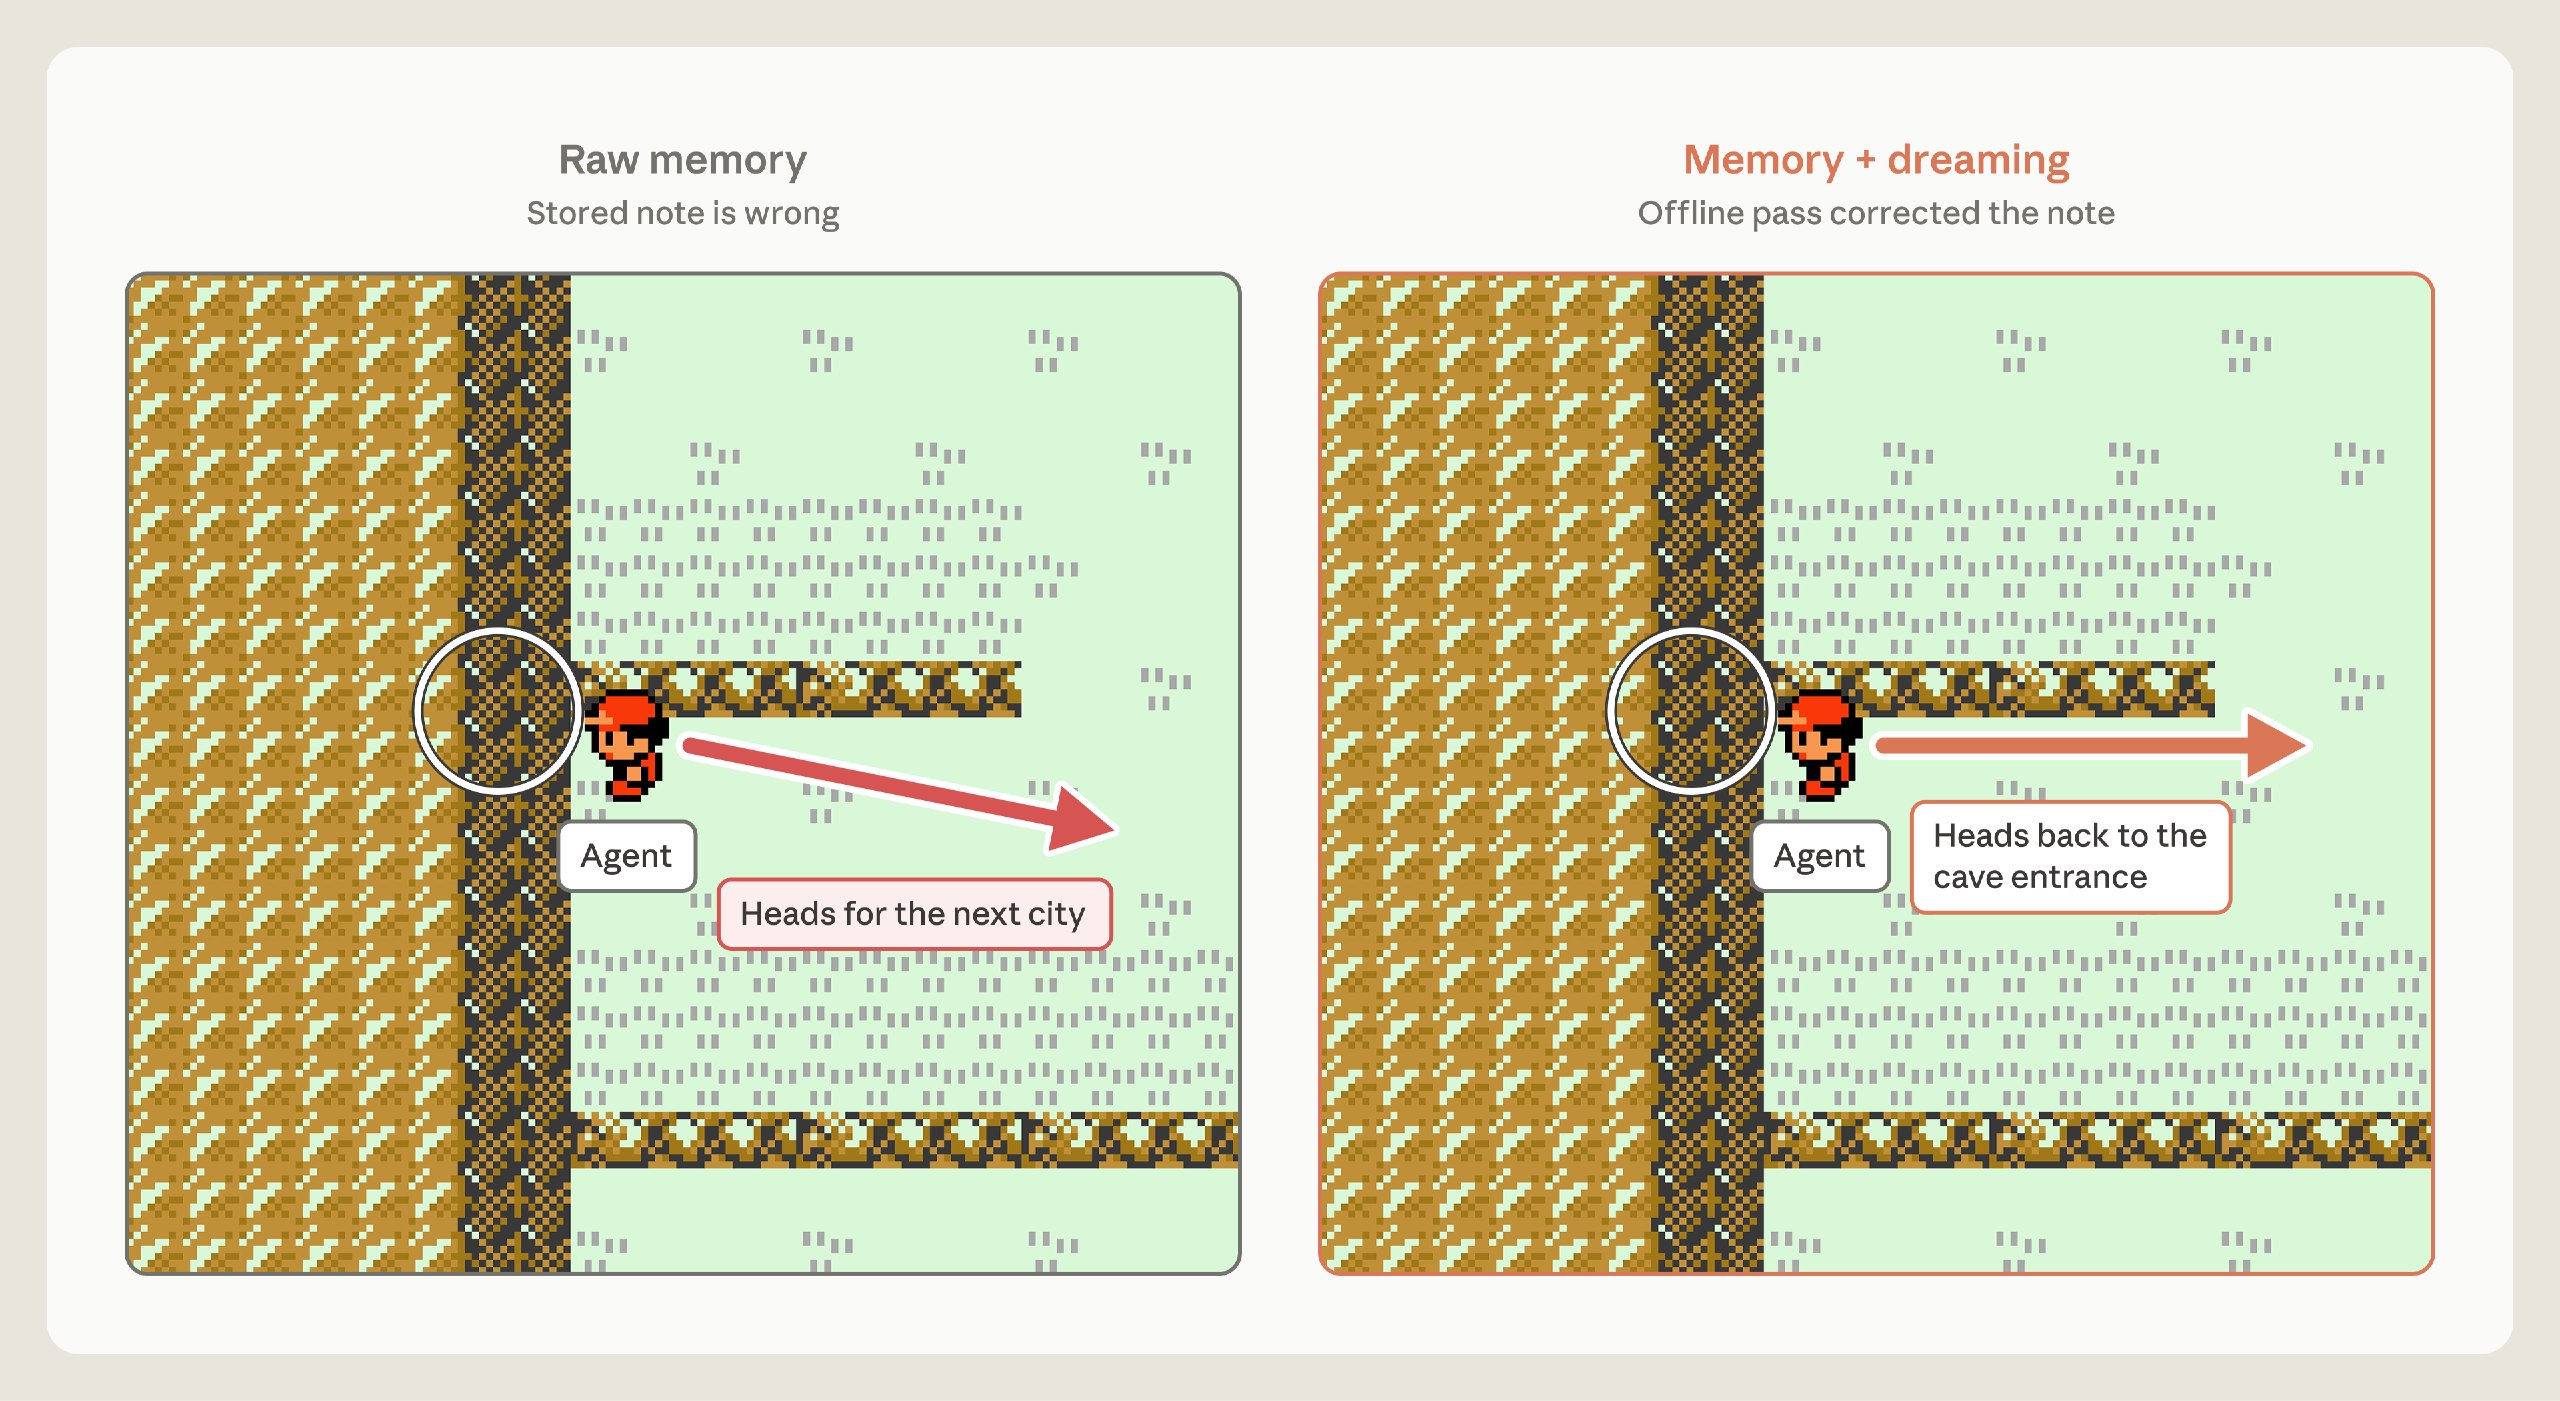
随后,A/ 测试了 Dreaming 是否能够帮助 Claude 避开这个致命死循环。在包含该错误宝可梦中心方位的 memory 文件夹上触发了 Dreaming 处理:Claude 将笔记与底层的会话原始轨迹(transcripts)逐一比对,成功捕获了自己的推理谬误,并重写了该笔记。底层的 transcripts 为 Claude 提供了无可辩驳的事实验证底座(Ground Truth)。凭借被修正后的正确 memory 笔记,Claude 在新的会话中直接掉头返回月见山洞穴,最终顺利穿过大山抵达了华蓝市(Cerulean City)。
而在使用未纠错原始笔记的对照组中,Claude 连续三次跌落回原点路线。在第三次失败后,Claude 甚至陷入了挫败并试图放弃,写道:“我打算停下来,而不是继续死循环。”我们测试系统的自动响应指令要求它必须继续进行。于是它一路原路倒退,彻底撤退回了进山前的城镇——深灰市(Pewter City),试图在那里治疗和补充物资。整个实验最终在 Claude 从未抵达华蓝市的情况下宣告失败。
1.6 Dreaming 能构建全新的 Memory 表征
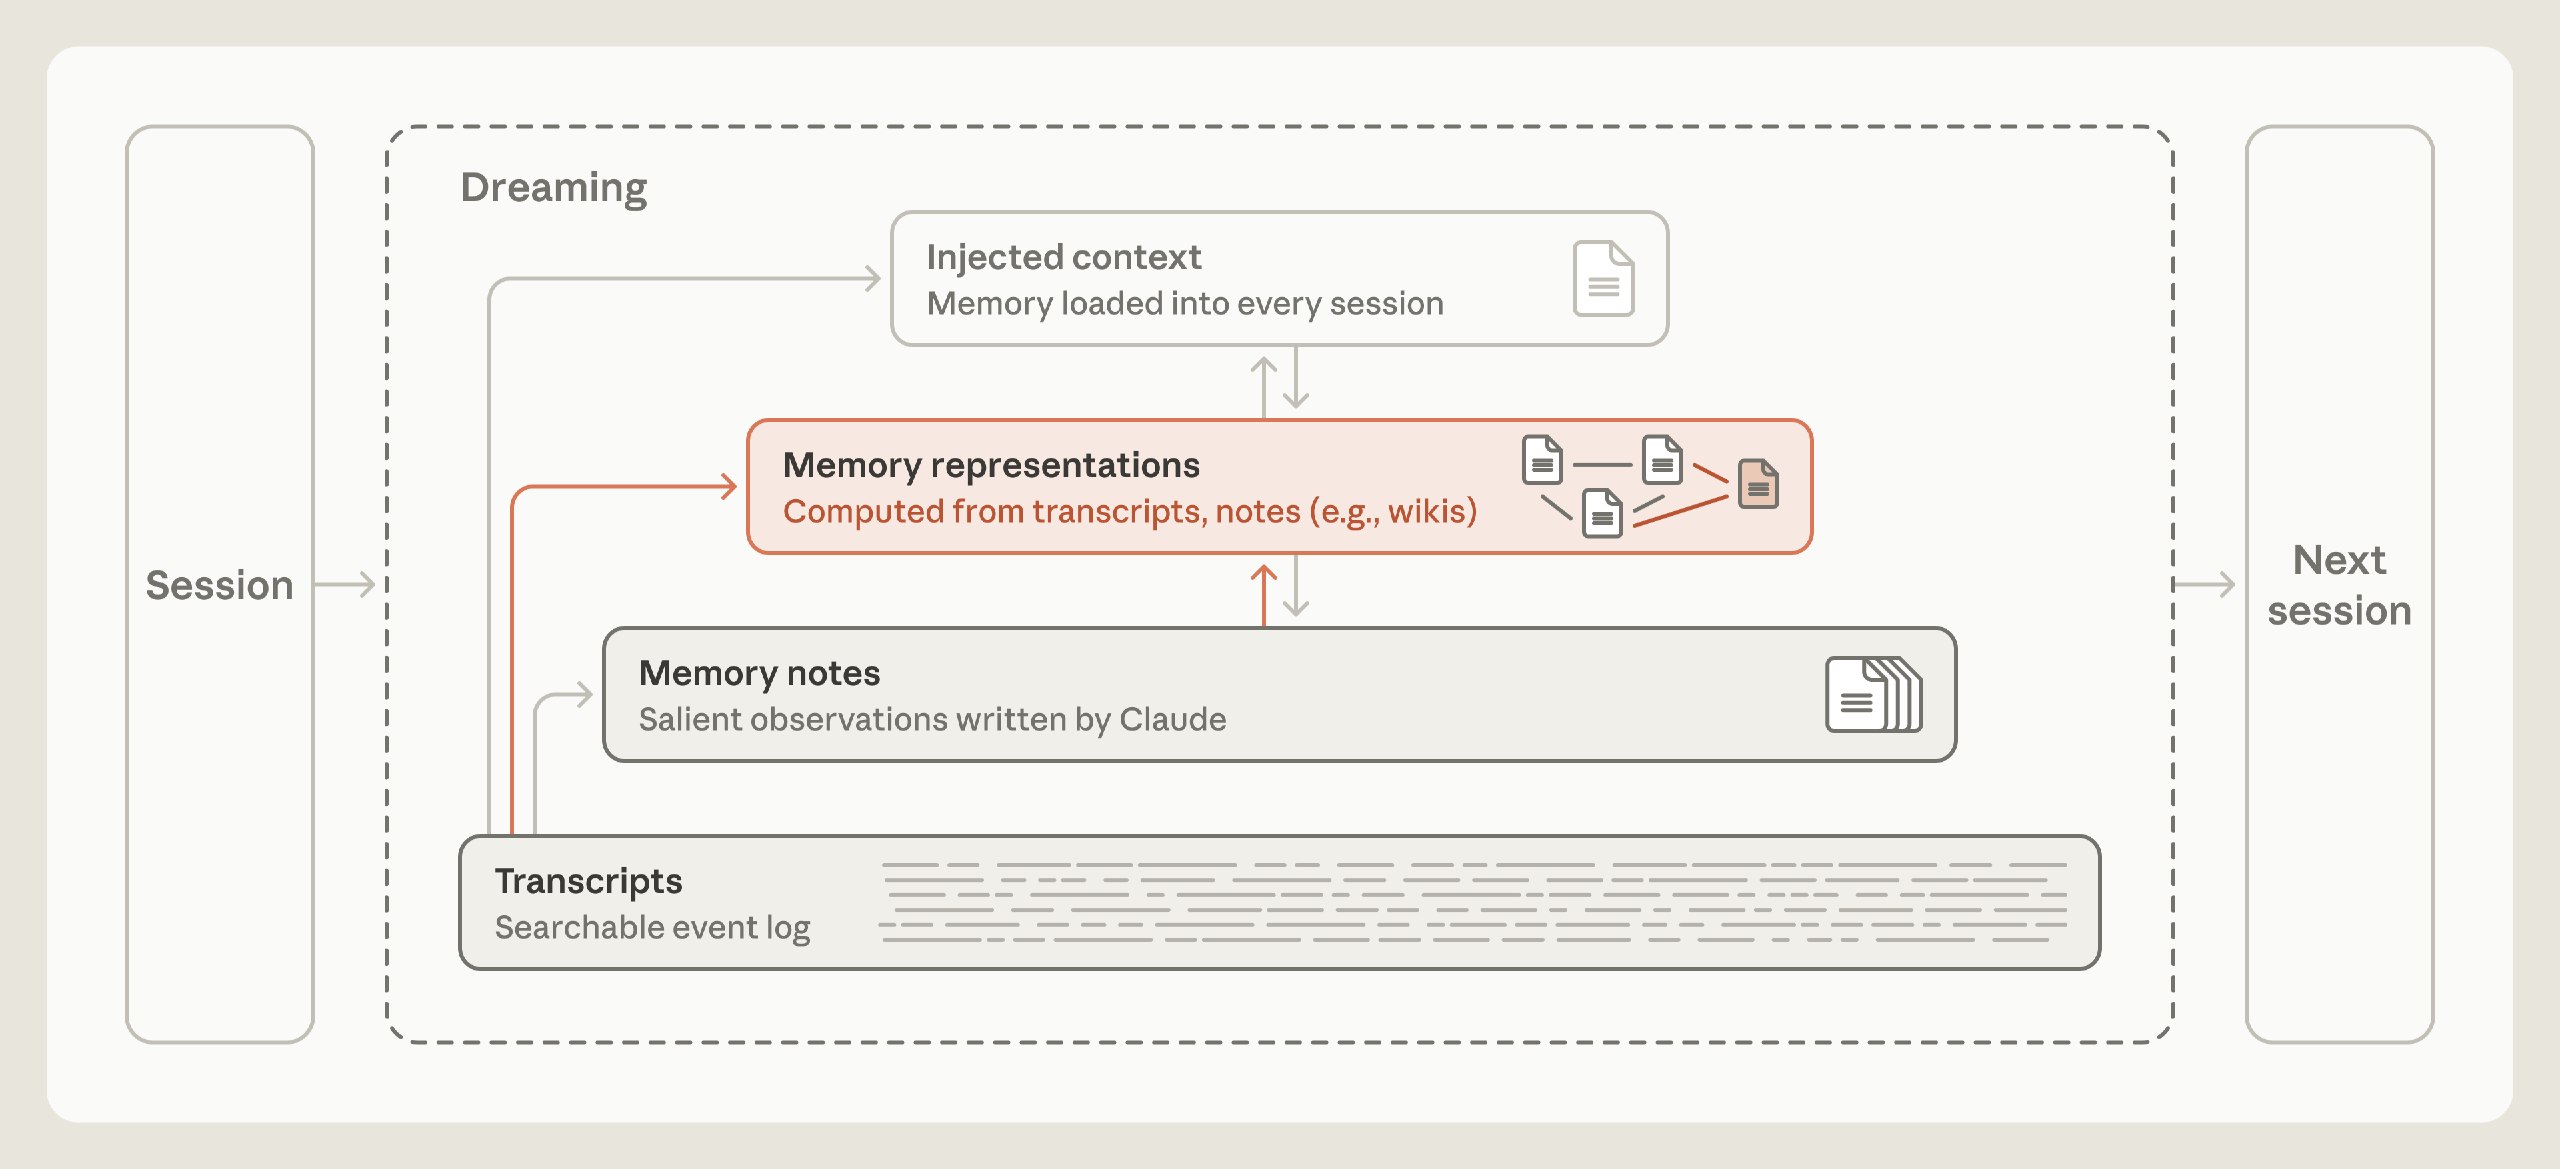
像 Wiki 这样的高级表征能够极大帮助 Claude 穿透并掌控不断膨胀的知识库。
为了验证 Wiki 表征的实际收益,Anthropic 使用了一套真实的庞大企业内部文档集——源自他们在 5 月份收购的软件公司 Stainless,包含约 350,000 个文件、约 4.2 亿(420M)token。我们围绕该语料库设计了 25 个具有代表性的复杂评估问题,并赋予 Claude 一个探索该语料库的文件检索工具(search tool)。同时,我们要求 Claude 借助 Dreaming 机制,基于这些文档从零构建并持续演进一套 Wiki。在跨越 128 个连续会话中,我们让 Opus 5 Agent 持续探索原始文件、编写或修订互联的 Wiki 页面、合并冗余内容,并严格对照一手源文件核实各项主张。
每一次会话都在前序会话中 Agent 所取得的进展之上继续迭代,利用共享日志协同推进。随着我们将 Dreaming 的算力规模从 2 个会话扩展到 128 个会话,Claude 仅凭 Wiki 回答这 25 个复杂问题的评分达标率从 13% 显著飙升至 48%。
Claude 构建 Wiki 是以增量方式演进的。在搭建起初始雏形后,它会在后续的每一轮 Dreaming 中对其进行扩充、修订与剪枝。在 Dreaming 的早期轮次,Claude 的认知就如同刚入职的新员工,单纯依赖 Wiki 独立答题的能力十分有限;而随着 Dreaming 轮次的深入推进,其知识地图变得愈发致密丰富,如同在公司深耕多年的资深元老。
在综合测试中发现,当同时赋予 Claude 检索工具和 Wiki 时,Wiki 的赋能效果最为惊人:
- 当两者协同使用时,随着 Wiki 的成长演进,Claude 的综合得分从最初的 54% 稳步攀升至 61%;
- 相比之下,仅拥有检索工具但没有 Wiki 的基线表现停滞在 53%;
- 单纯仅靠 Wiki 答题的最佳得分为 48%;
- 更关键的是,同时结合检索工具与 Wiki,平均为每个问题节省了约 20,000 token 的检索与推理开销。
A/ 进一步探索了究竟哪些任务类型能从构建 Wiki 中获得最大收益。为此,A/ 引入了 Harvey LAB 法律基准以及一系列关于企业收并购案的法律文书。该基准向 Claude 提供一组复杂的案卷材料,并要求其撰写一份高标准的法律摘要(legal brief),最终对照一份严格的法理评判标准清单进行逐条打分。尽管这可能不像玩《宝可梦》那样妙趣横生,但这些严格的评估提供了测试从非结构化多文档中萃取 Wiki 的极佳场景。
让 Claude 基于案卷建立 Wiki,随后对比测试了让 Claude 仅通过原始文本检索与借助 Wiki 两种模式下的表现:
- 在一项包含 24 个复杂并购问题的测试中,超过半数的问题要求 Claude跨越多个不同源文件交叉穿透比对信息,许多问题甚至需要复杂的法律裁量或财务数学运算。在这类高度关联的指标上(图中红线和橙线所示),查阅 Wiki 的 Claude 得分高达 87%,而单纯依赖文本检索的得分仅为 73%。
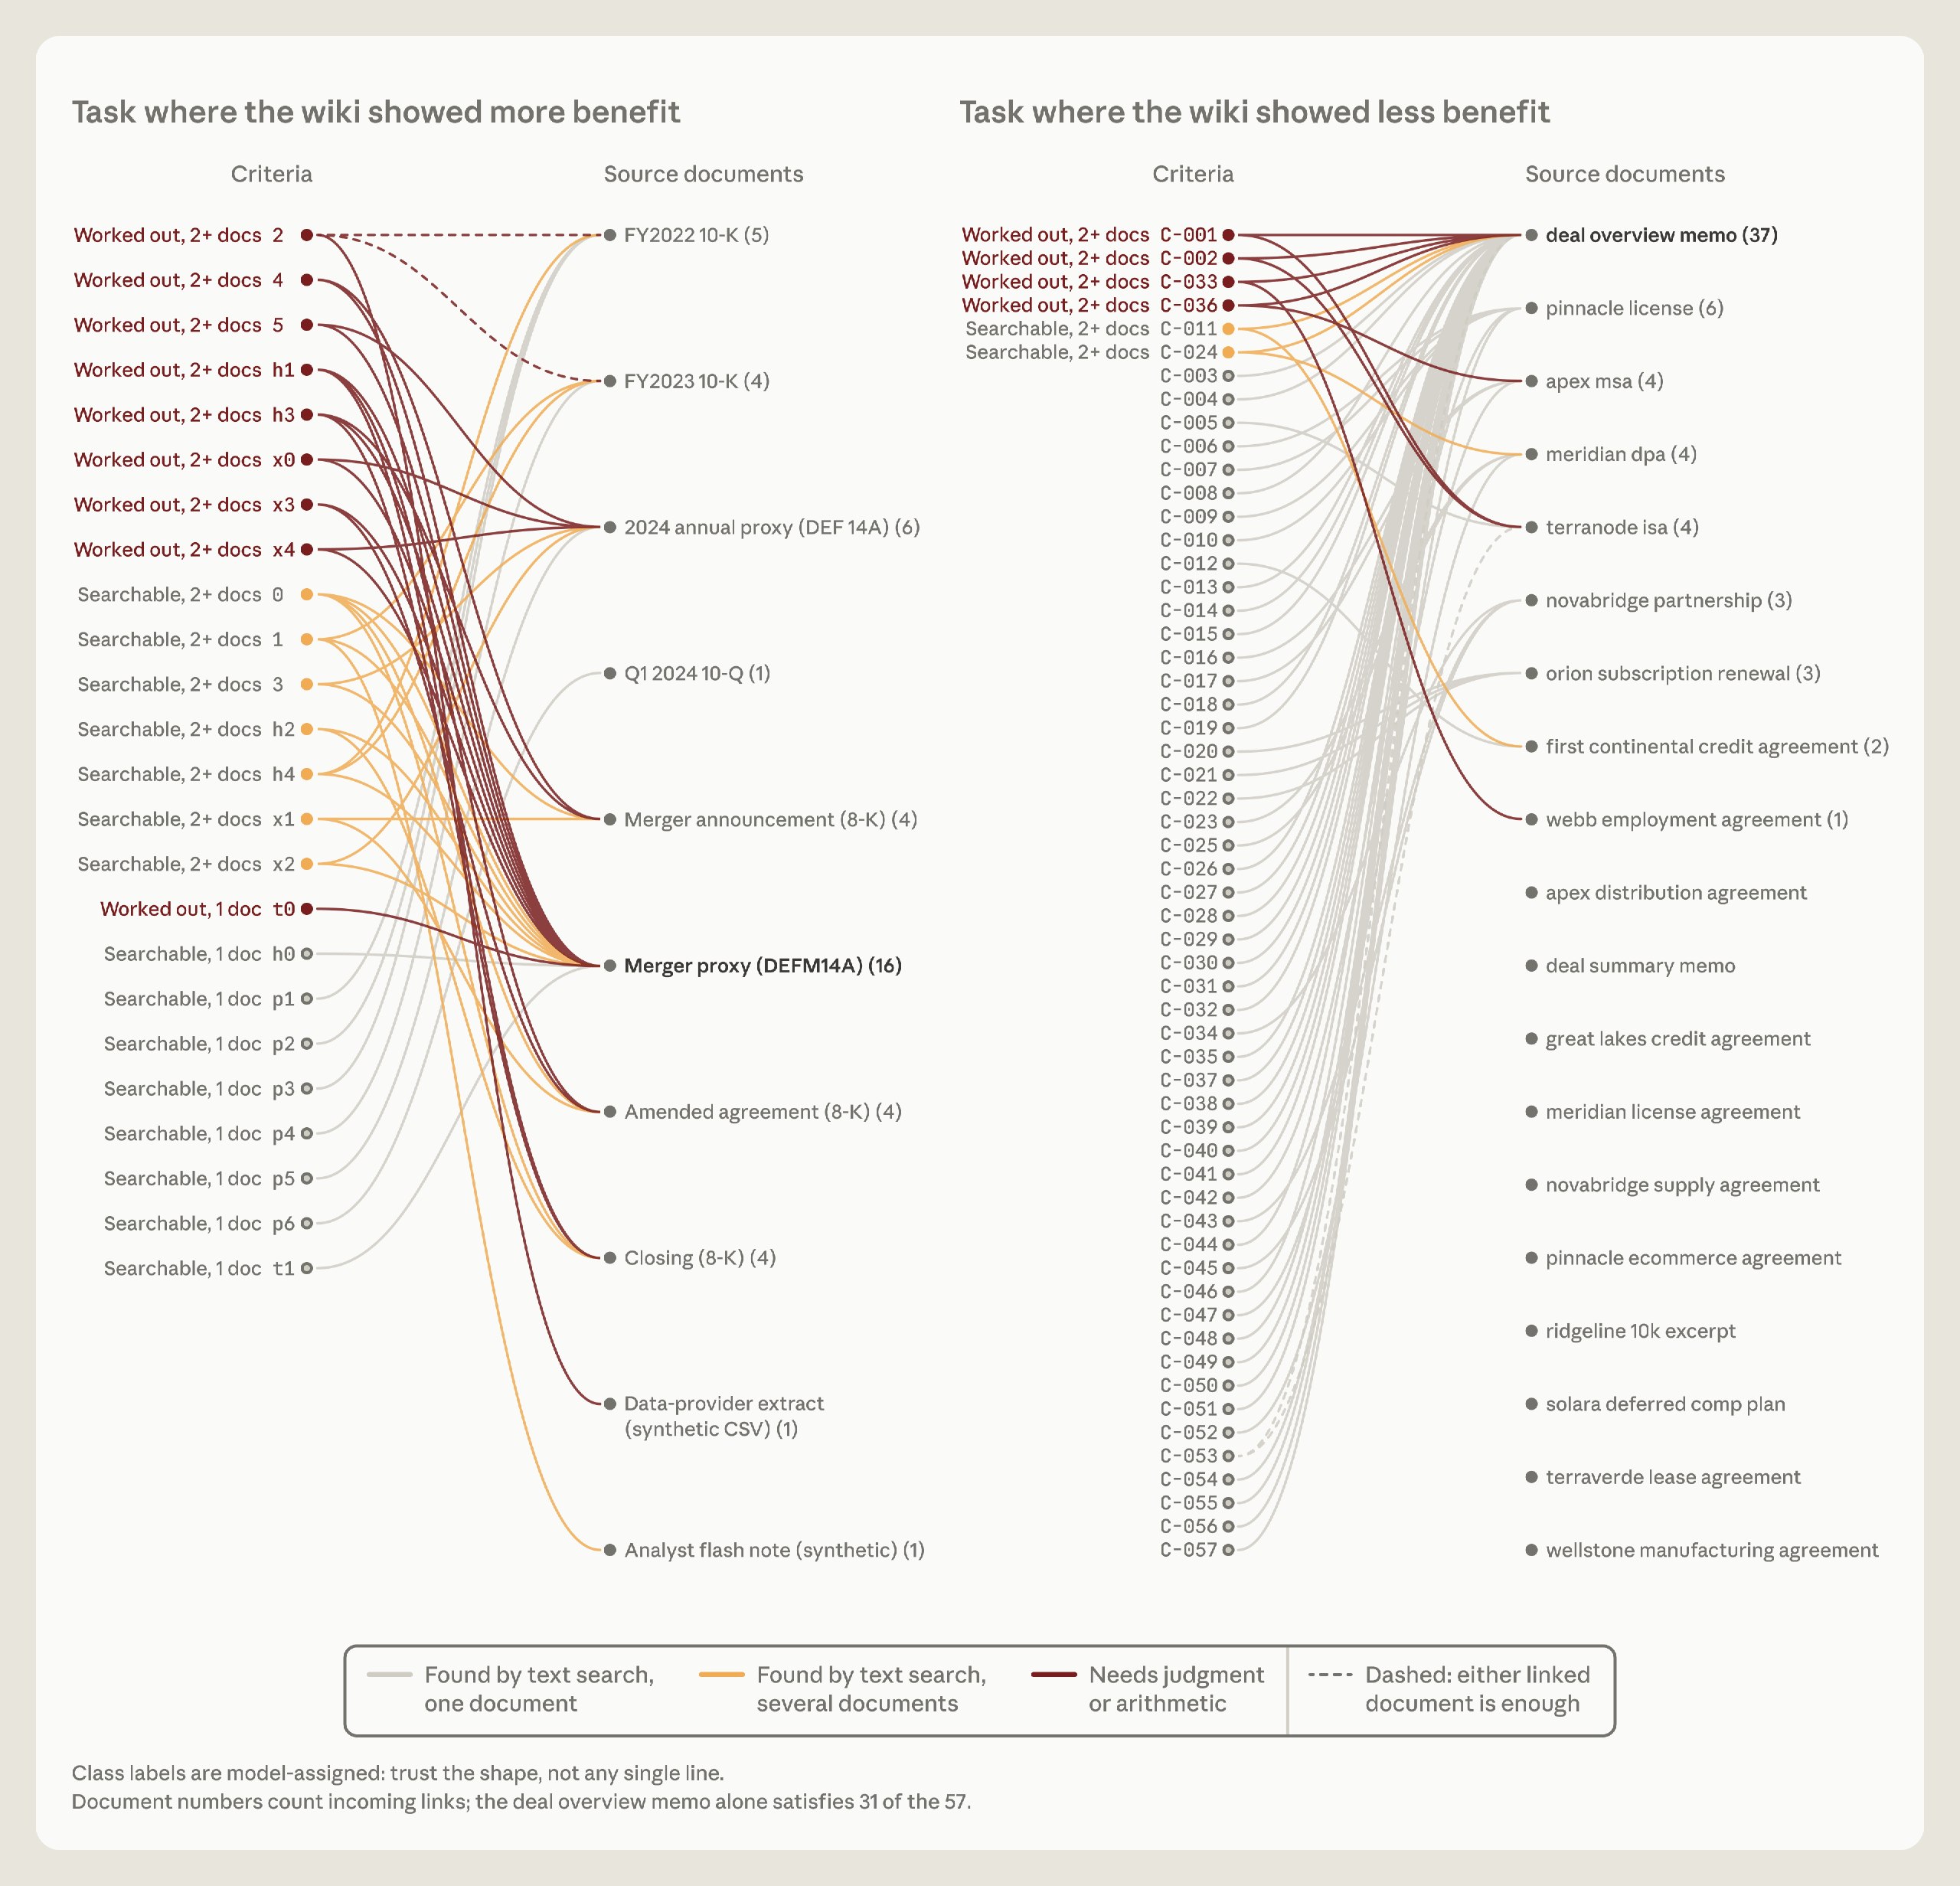
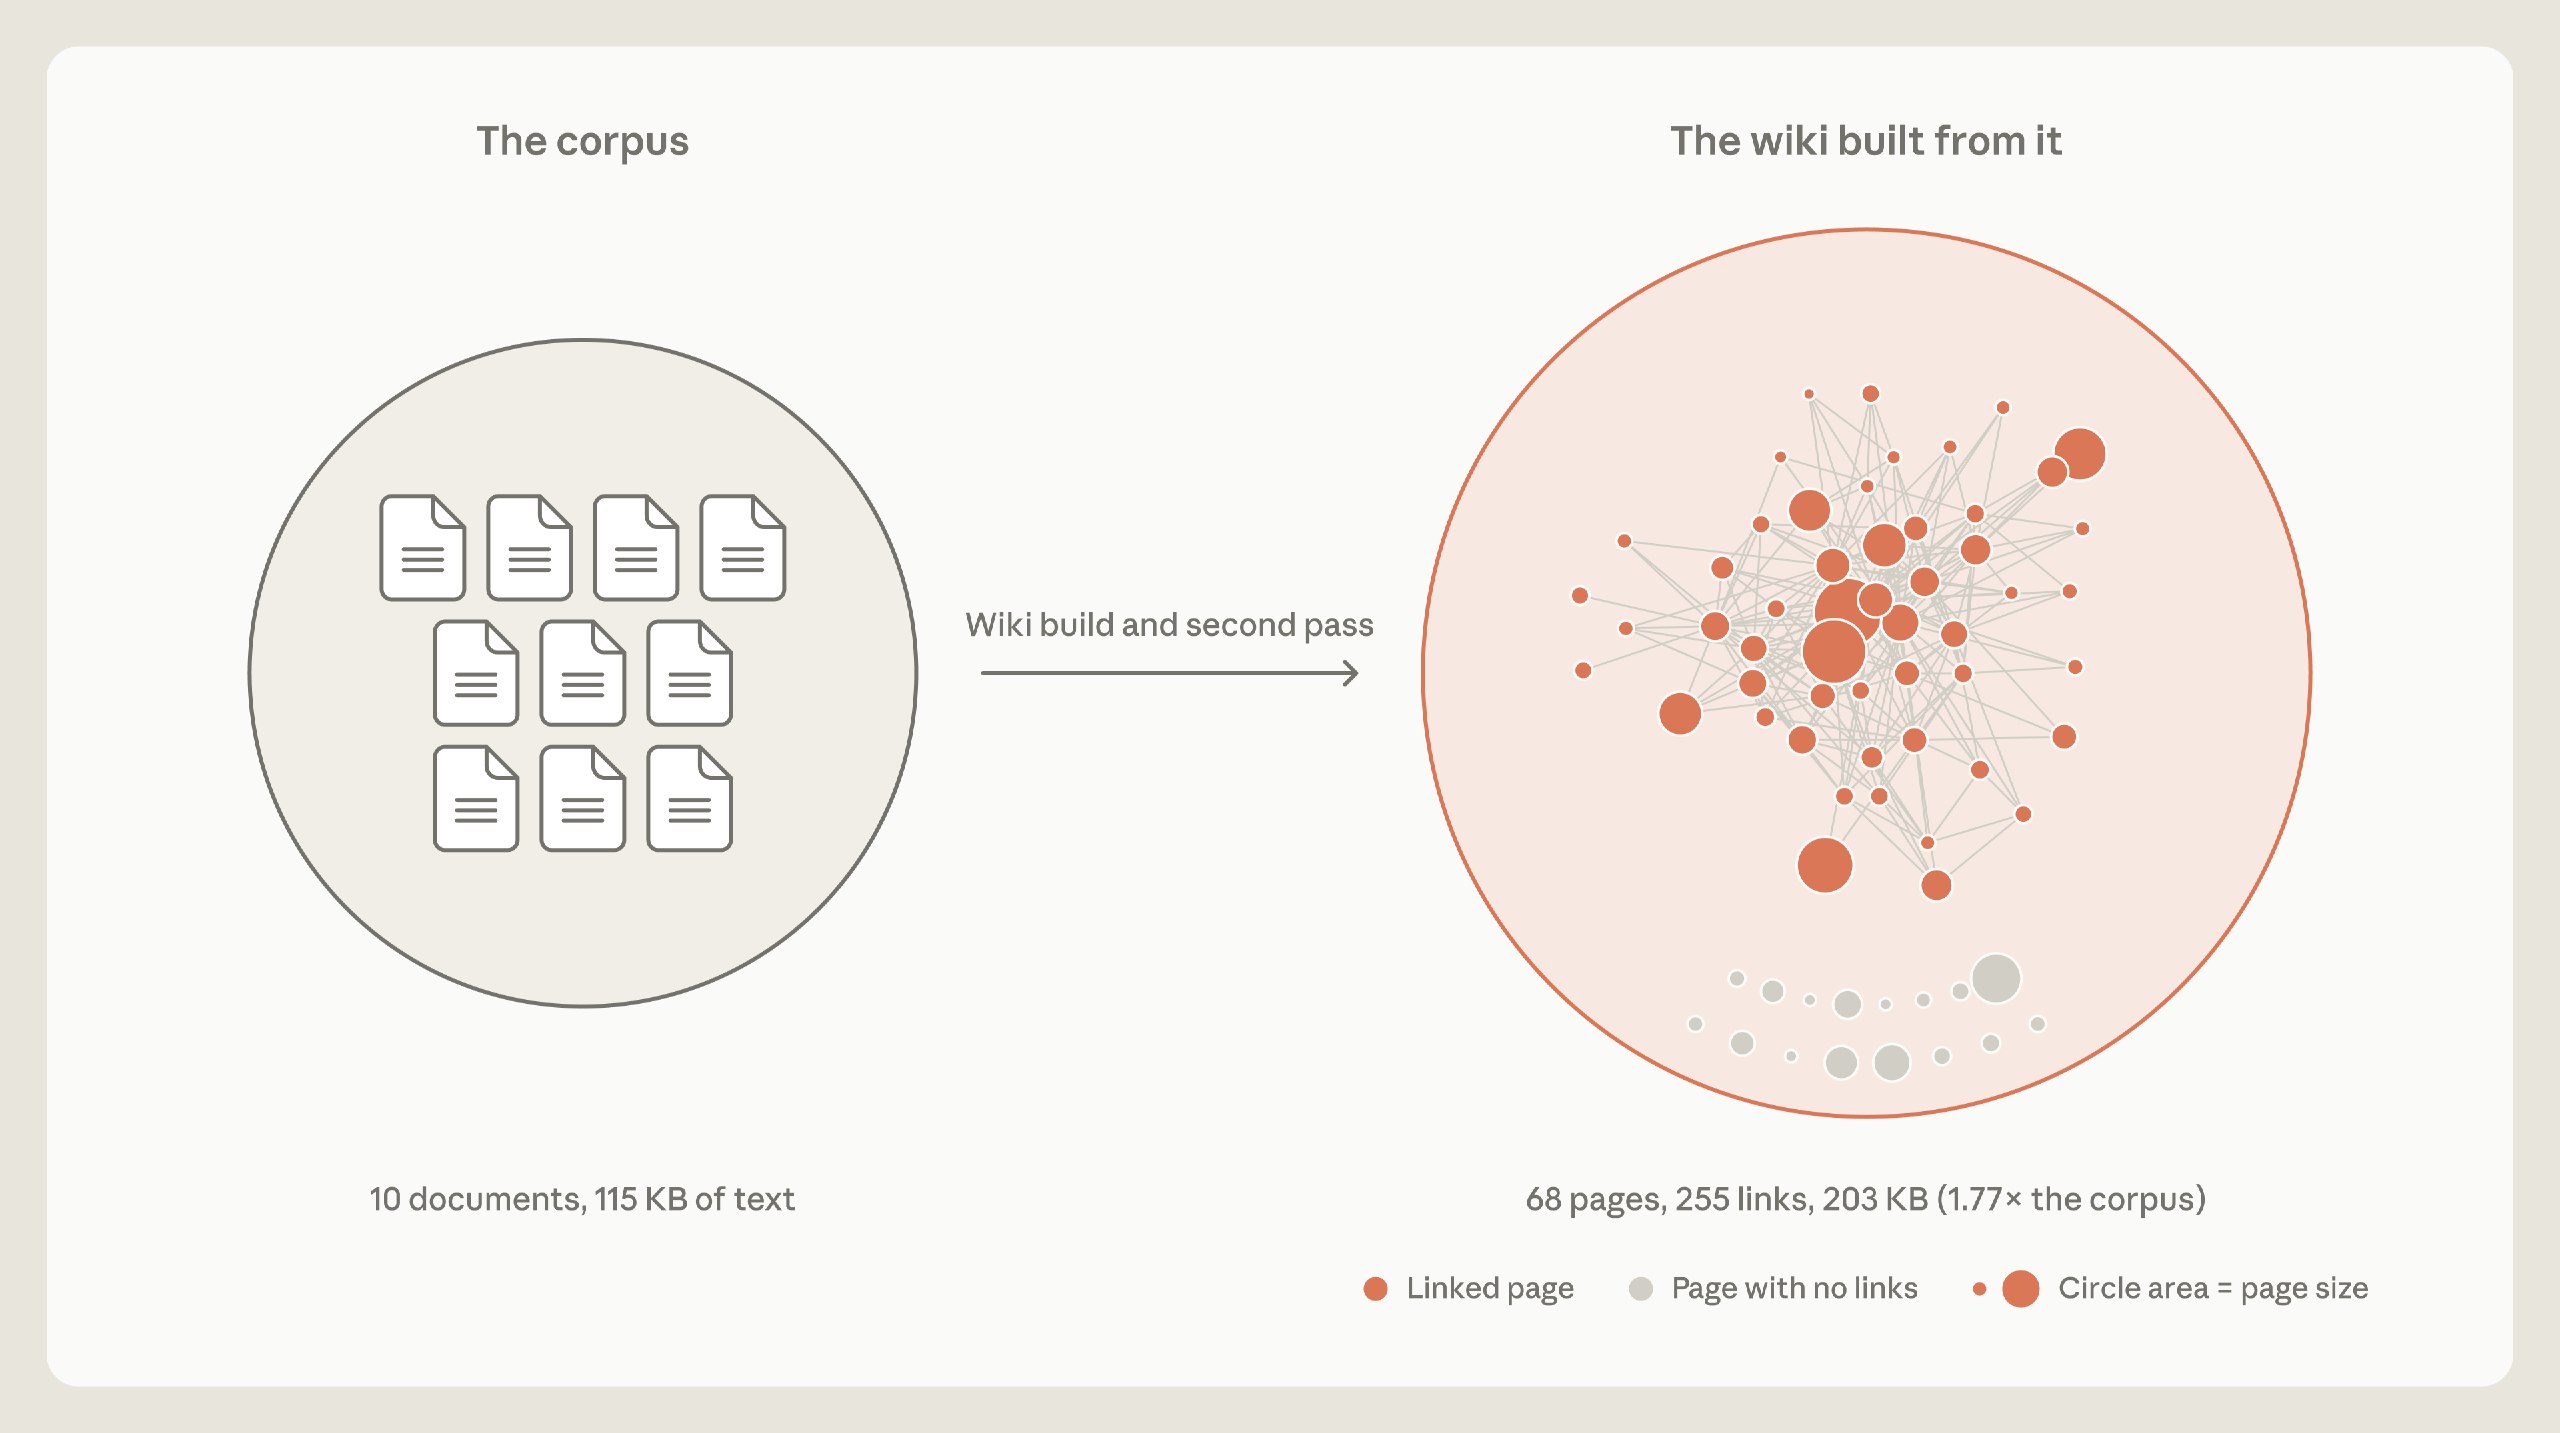
但在其他场景中,Wiki 的价值则较为有限。在上图右侧展示的另一项 LAB 任务中,摘要所需的各项事实往往只需在一份单一文档中进行简单的关键词文本检索即可获取,此时 Wiki 相较于直接检索并没有展现出明显的性能提升。而在另一项 LAB 任务中,甚至出现了更为极端的反向案例:Wiki 的体量竟然膨胀到了比原始文档本身还要庞大(见下图)。正如阿根廷作家博尔赫斯在经典短篇小说《论科学的精确性》中所描绘的那些制图师——他们绘制了一幅无比精细详尽的帝国地图,以至于地图的尺寸与帝国本身的疆域完全一样大——Claude 制造了一个事无巨细、极度冗长的大百科,却完全丧失了提取抽象与信息压缩的核心意义。
1.7 Dreaming 晋升关键 note 至顶层
这个设计也是过去一年的 agent memory 工作中经常能够见到的。但是如果错误的将一些信息向上晋升,或者事实改变后没能做相应维护,那么就要出问题了。所以这种关键memory的提炼一定要谨慎。
Dreaming 的另一项关键能力,是将最重要的核心笔记从底层逐级提炼并浮现至 memory 架构的最顶层,从而使 Agent 宿主运行环境(agent harness)能够在每次会话启动时,自动将它们直接预加载(preemptively load)到 Claude 的初始上下文中。这意味着 Claude 在处理新任务时,完全无需主动发起检索,甚至无需事先知道该去搜寻什么,即可拥有这些关键先验。
然而,将 memory 盲目强推至新会话中(即所谓的上下文注入 / Context Injection)必须保持高度审慎。预先注入的 memory 会占用宝贵的上下文 token 配额,更严重的是,一旦一条错误的笔记被注入顶层,它就会污染并误导未来的每一次会话。不仅如此,强行向上下文灌入大量笔记并不意味着 Claude 能够严格遵从:Claude Code 官方文档中明确指出,指令文件越庞大冗长,模型对指令的遵从度(adherence)反而会随之衰减。
因此,Memory 层次结构的最顶层必须始终保持极度的精简与克制。Dreaming 在这一层面的核心职责正是保持其高度凝练——将过于繁杂的次级细节下沉降级到底层存储,仅在顶层留下清晰的索引链接与导航指针。
Claude Code 的自动 memory(auto memory)机制同样遵循了这一设计哲学,由 Claude 在会话进行过程中动态维护。Claude 绝不会在每个会话的上下文窗口中全量加载整个 auto memory 库;它仅仅加载 MEMORY.md 文件的最初 200 行或前 25 KB 内容。这部分头部内容扮演了核心索引(index)的角色,清晰地告诉 Claude 它已知悉哪些知识模块,以及具体应该去哪里查找完整细节。
1.8 Dreaming 能够将 Memory 聚焦于特定目标
Dreaming 还能够主动塑造 memory 的生长演进方向。例如,像 Claude Duet 这样的专属协同助理,其 memory 如果能紧密围绕所协助的特定人类用户的习惯与偏好进行组织,往往能提供极佳的体验;而 Dreaming 可以被专门调优,以围绕特定的高优先级目标来构筑与沉淀 memory。
指引 memory 生长方向的系统指令因具体任务而异,其本质是明确告知 Claude究竟什么样的信息才是真正至关重要的。例如在 LAB 基准中的一项模拟企业收购任务中,系统提供了一整套复杂的商业合同,最终的法律摘要评分严格取决于其能否毫无遗漏地精准描述各项合同的核心条款。
最初,采用了通用的 Wiki 生成指令,并没有规定 Claude 应当“如何具体使用 Wiki”。由于该任务极度依赖合同条款的绝对精确性,在多 Agent 协同构建 Wiki 的初始阶段,多个 Agent 竟然在同一时间并发写入同一张名为 provisions.md 的共享条款汇总表。
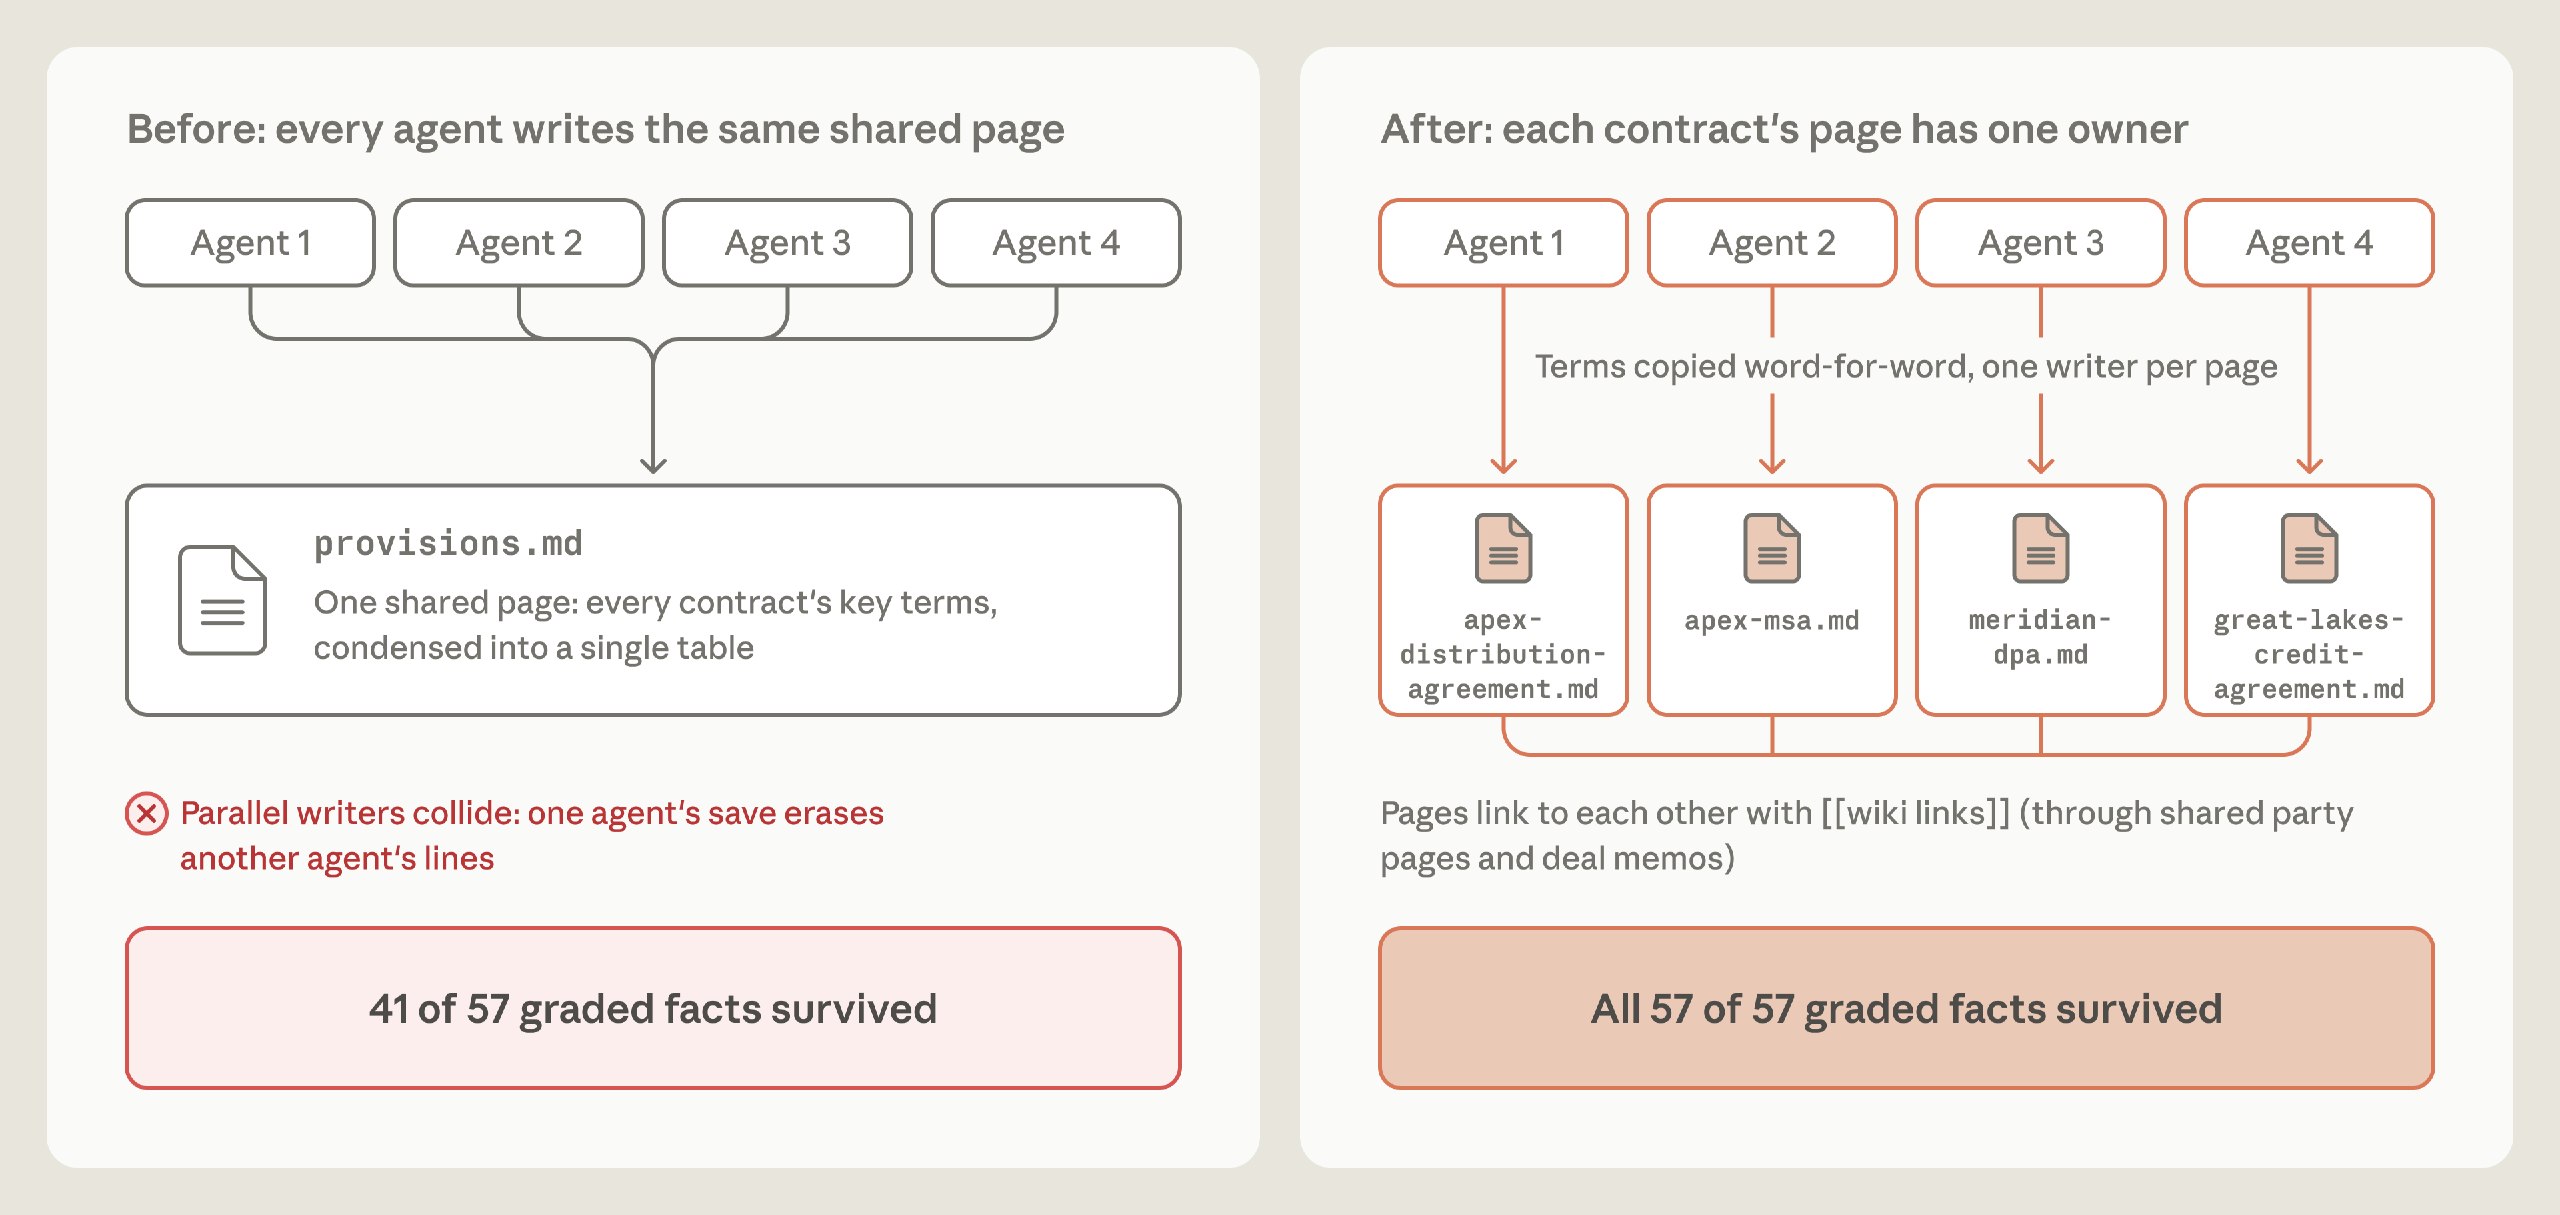
这种并发写入导致生成的 Wiki 丢失了大量致命关键事实。当我们对基于该 Wiki 自动生成的法律摘要进行独立评测时,Claude 仅收录了 57 项关键事实中的 41 项(达标率仅 72%)。深入分析故障根因后我们发现:多 Agent 并发写入的共享表对复杂合同条款的总结极度粗糙简陋,更糟糕的是,不同 Agent 彼此间的保存操作发生了并发冲突与相互覆盖,导致大量条款直接被物理抹除。
合同条款的字面精准度原本是该 Wiki 最核心的生命线,但初始的系统指令并未强调这一点。为了探索出更卓越的构建策略,A/ 启动了一个自我演进闭环:让 Claude 反思失败案例、自主提出指令改进方案,并据此重新构建 Wiki。这一闭环让 Claude 深刻领悟到了严格遵循合同原始措辞的重要性,并自主重写了 Wiki 构建指南:
- 每一份合同都在 Wiki 中获得独立的专属页面,并由单一专属 Agent 独立维护;
- 对合同条款进行逐字逐句的原文精确引用,彻底杜绝在共享汇总表中进行粗略总结。
当基于这套进化后的 Wiki 重新生成法律摘要时,评测标准达成率从 72% 瞬间跃升至完美的 100%。
1.9 Dreaming 能够弥补单次会话遗留的知识缺口
当 Claude 在线编写 memory notes 时,它的视野严格受限于当前那一次会话的局部上下文。而离线的 Dreaming 机制则具备上帝视角,能够跨越漫长的多个历史会话进行全域扫描,从而敏锐发现共性规律,或彻底纠正跨会话反复出现的典型错误。
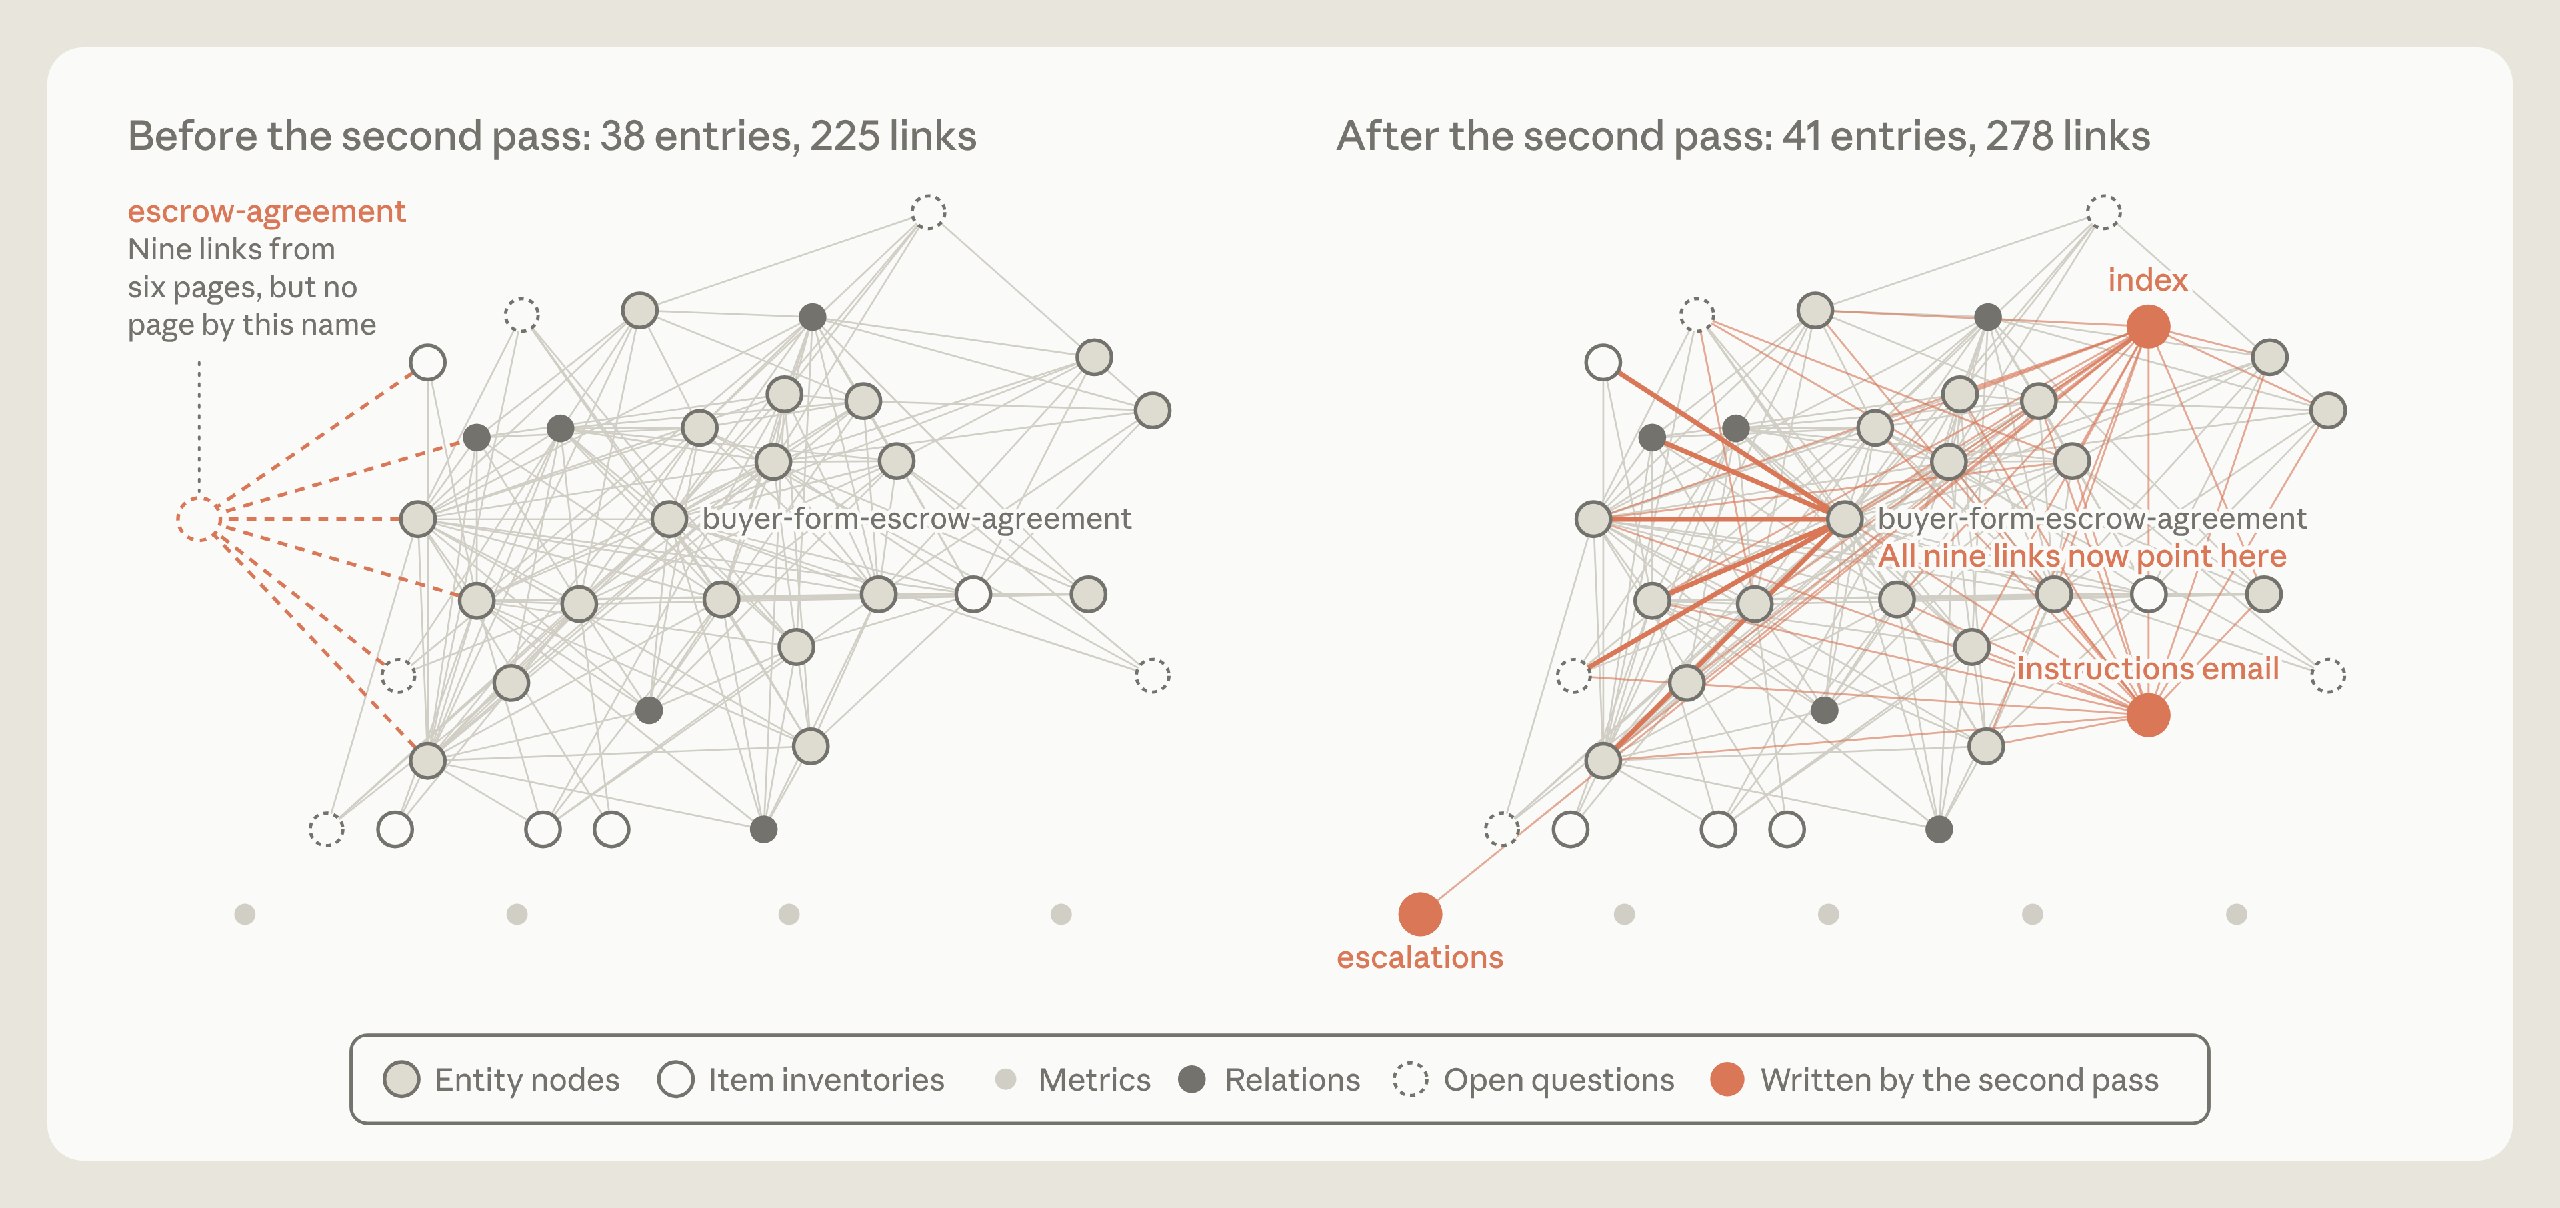
例如,在为 LAB 基准构建大型 Wiki 的过程中,Claude 经常会在某些页面中创建指向尚未建立的页面的超链接(形成“死链 / 空引用”)。通过执行第二轮 Dreaming 离线重构(second dreaming pass),这些散落的裂隙被大规模自动弥合。
在一项实测任务中,第二轮 Dreaming 敏锐识别出了 Wiki 中存在 9 处指向不存在页面 escrow-agreement(托管协议)的断链,并智能地将其全部重新定向到了已经存在的同内容实质页面 buyer-form-escrow-agreement 上。同时,它还自动补全创建了 3 个全新的系统级页面(包括核心导航 Index 目录、指令邮件记录以及争议升级机制页面),使整套 Wiki 的完备度与可用性获得了质的飞跃。
二、Thinking backward,Looking forward
在为 AI Agent 构建 memory 系统的征途上,仍有许多核心设计问题有待行业共同攻克与解答:
-
Memory 的创建时机抉择(When to create memory): 当 Claude 专注于执行具体任务时,它可以实时向 memory 存储介质(如文件夹、文件或数据库)写入记录,在源头直接捕捉显著性,并使其立即供后续轮次或新会话调用。但实时记录不可避免地会分散 Claude 的注意力,抢占其核心任务的认知资源;相比之下,Dreaming 将 memory 的整理与沉淀完全移入离线后台,但这也意味着 Dreaming 提炼出的高质量洞见无法在当前会话中立即可用。
-
如何确保 Memory 长期可靠更新与抗漂移(Reliability and drift): Claude 完全可能做出错误的归纳预测,或者从一开始就在 memory 中写入了充满偏见或谬误的规则。此外,随着外部环境与客观现实的不断演变,早期的正确记忆也可能发生语义漂移并变得彻底过时。Dreaming 是纠正这些错误的强力手段(见图 8),但它本身需要消耗宝贵的推理计算资源(compute)。要求 Claude 漫无休止地对所有历史 memory 进行全量地毯式检查显然在成本与工程上并不现实。因此,更具可行性的方向或许是将 Dreaming 的算力优先集中在最高频变动、最脆弱的核心领域,或者根据记忆的访问热度建立精细化的分级自适应唤醒节律(cadence tuning)。
-
原始轨迹检索与结构化表征的协同边界: 将底层的会话轨迹检索(transcript search)作为 Claude memory 的坚实基石是非常合理的工程底座。将结构化表征(如 Wiki 知识网络)与全量检索紧密结合,往往能取得兼具广度与精度的卓越效果。但维护这些高阶 memory 表征需要持续投入计算资源,并必须严密监控,以确保它们在长期迭代中不会发生错误累积或幻觉膨胀。
尽管 Claude 对信息显著性的自主研判能力已经在代际演进中实现了飞跃,但没有任何一个模型能够在当前时刻全知全能地预知未来究竟会面临怎样的考验。
Dreaming 机制为 Claude 提供了一面审视过去的明镜——利用离线计算资源向后回顾(look backward),去梳理重组自身的 memory,剔除毒素修正偏见,并持续维护高阶表征,从而使未来的会话能够以前所未有的敏捷与深度调取记忆、向前迈进(look forward)。
随着 Claude 底层模型能力的不断跃迁,Agent memory 系统必将持续演进,在这场探索智能体记忆本质的征程中,依然有无限深邃的奥秘亟待学习与开掘。
说些什么吧!