
零、写在前面
终于也是摸到卡了,有空的时间练练手,虽然感觉这些已经过时了。
本章主要梳理一下下面的内容:
- “推理"对于一个大语言模型意味着什么
- 回顾 LLM 常规的预训练与后训练阶段
- 介绍提升 LLM 推理能力的几种主要方法
- 推理与模式匹配的区别
- 我们为什么要从零构建推理模型
印象里,GPT3.5刚出的时候唐的不行,真正让我感觉有点惊讶的应该就是GPT4.0发布的时候,这个时候已经能解决部分 cf 的思维题了,这背后一个很重要的东西就是——推理(reasoning)。
LLM 已经改变了我们处理和生成文本的方式,但它们此前的成功在很大程度上来自统计模式识别。而推理方法的新进展,让 LLM 有能力处理更复杂的任务,例如求解逻辑谜题和多步骤数学题。
此外,推理也是让 AI 智能体(agent)真正可用的关键技术——当一个 agent 需要把任务拆解成步骤、调用工具、从错误中恢复时,都离不开推理。诸如 OpenClaw 这类 agent 应用已经在使用推理型 LLM。
一、在 LLM 语境下定义"推理”
在 LLM 的语境下,推理指的是模型在给出最终答案之前生成中间步骤。
这些中间步骤可能表现为可见的逐步解释,也可能被包裹在特殊标签里(例如 <think>...</think>)而对用户隐藏。无论哪种情况,核心思想是一致的:鼓励或训练模型把 token 花在中间求解过程上,而不是直接跳到结论。
相应地,推理模型(reasoning model) 指这样一类 LLM:它通过训练或提示技术得到了改进,能够产出上述中间步骤,从而在编程、逻辑谜题、数学题这类复杂任务上通常获得更高的准确率。
思维链(Chain-of-Thought, CoT) 这种生成中间步骤的范式通常被称为思维链(CoT)。我们常说模型在"一步步思考"问题,意思是它把中间的推理过程显式化、更容易follow。很多时候大家不怎么区分 reasoning 和 thinking。这并不意味着 LLM 真的以人类的方式在推理或思考。
另:关于最早的 CoT 论文,我有过相关整理:CoT精读
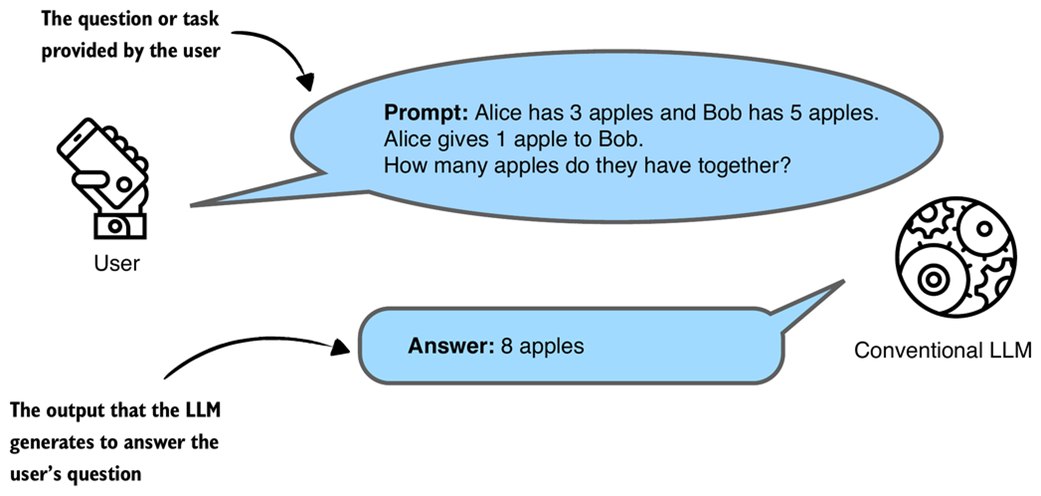
常规的、非推理的 LLM 用一个简短回答响应问题:
LLM 多步(CoT)推理的一个简单例子:
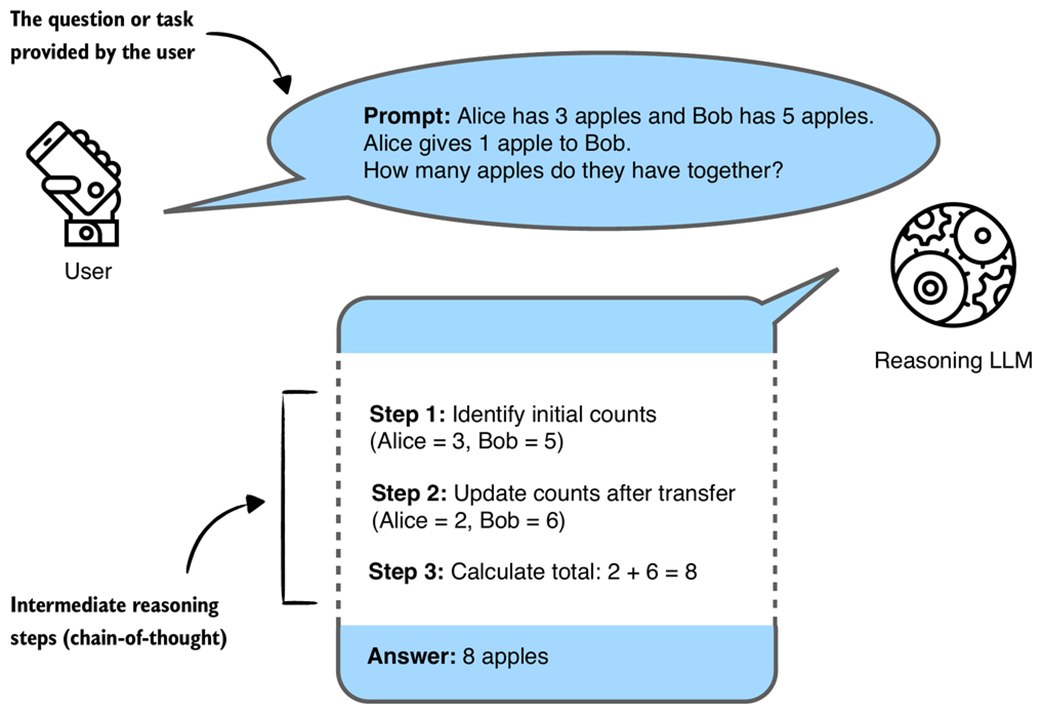
上图是思维链推理的典型示例,但必须强调:LLM 的推理不同于传统的、确定性的推理。
例如,一个符号逻辑引擎或定理证明器遵循严格的、基于规则的步骤,保证一致性和正确性。符号逻辑引擎的工作方式就像照菜谱做菜——每一步都是固定的,每次都必须产生相同的结果。用烹饪来类比:只要严格按步骤做,你总是得到同一道菜。
与符号逻辑引擎相反,LLM 是自回归地生成推理的,也就是说它一次预测一个 token,依据的是训练数据中的统计模式。因此,LLM 的"推理步骤"即使看起来很有说服力,也不保证在逻辑上是严密的。
所以我们就聚焦于那些能改进 LLM 推理、从而让 LLM 更擅长处理复杂任务的基础技术。
LLM 推理 vs 人类推理 LLM 的推理过程在表面上与人类思维很相似,尤其是在中间步骤的表述方式上。但要认清一个关键差异:人类可以通过有意识地应用逻辑规则,或者基于对世界的内部模型进行推理,来实现确定性推理。这里的"确定性"指的是:从相同的事实出发、走相同的步骤,我们总会得到相同的结论。相比之下,当前 LLM 的推理是概率性的——它一次生成一个 token,依据训练数据中的统计模式,不保证逻辑一致性。
人类推理常常表现为有意识地操作概念、直觉地理解抽象关系、或从少量样本中归纳。而 LLM 恰恰相反,它靠从海量文本中捕捉模式来工作,并不依赖内置的推理规则,也不依赖任何形式的意识思考。
简言之,尽管推理增强后的 LLM 输出可能看起来很像人,但底层机制差异巨大,并且仍是一个活跃的探索领域。
二、标准的 LLM Training Pipeline
简要概括一下常规的(非推理)LLM 通常是如何训练的。
在应用任何具体的推理方法之前,常规 LLM 的训练通常分为两个阶段:预训练(pre-training)和后训练(post-training)。
现在也有很多说法会在两者之间区分出一个中期训练(mid-training) 阶段,例如继续在代码、数学或长上下文数据上训练模型。这里就简单地把这个阶段归入预训练。
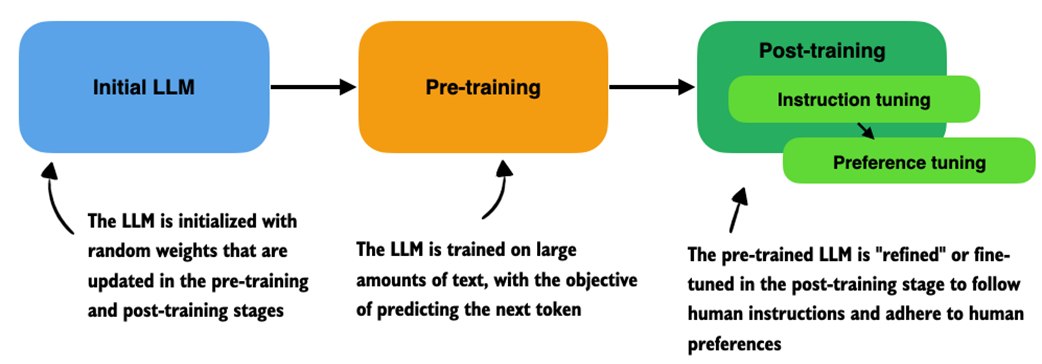
在典型 LLM 训练流水线的预训练阶段,LLM 在海量无标注文本上训练——常常是数 TB 的数据、数万亿 token,来源包括书籍、网站、研究论文等许多其他材料。预训练的目标是让 LLM 学会预测这些文本中的下一个词(即下一个 token)。
词(word)与 token token 是语言模型处理的文本小单元。根据文本被"分词器(tokenizer)“切分的方式不同,一个 token 可以是一个完整的词、一个词的一部分,甚至是一个标点符号。 例如,句子
"An LLM can be useful."在常见分词器下可能被切成"An"、" L"、"LM"、" can"、" be"、" useful"、"."这些 token,然后它们被转换成模型可以消费的数值 ID。 分词器并不是 LLM 本身的直接组成部分,但它是 LLM 文本处理与生成流水线中一个关键组件。下一章我们会看到分词在实践中是如何工作的。
在海量数据集上预训练让 LLM 变得非常能干,这通常涉及数 TB 文本(相当于数万亿 token)。这种训练需要数千张 GPU 运行数月,花费可达数百万美元。这里的"能干"指的是 LLM 开始生成与人类书写非常接近的文本。并且在一定程度上,预训练后的 LLM 会开始表现出所谓的涌现特性(emergent properties)——它们能够执行一些并未被显式训练过的任务,比如翻译、代码生成等等。
这些预训练模型只是后训练阶段的基座模型(base model)。后训练使用两项关键技术:监督微调(SFT,也叫指令微调 / instruction tuning)和偏好调优(preference tuning)(通常通过一种叫"人类反馈强化学习(RLHF)“的技术实现),用来教会 LLM 响应用户的提问,如下图:
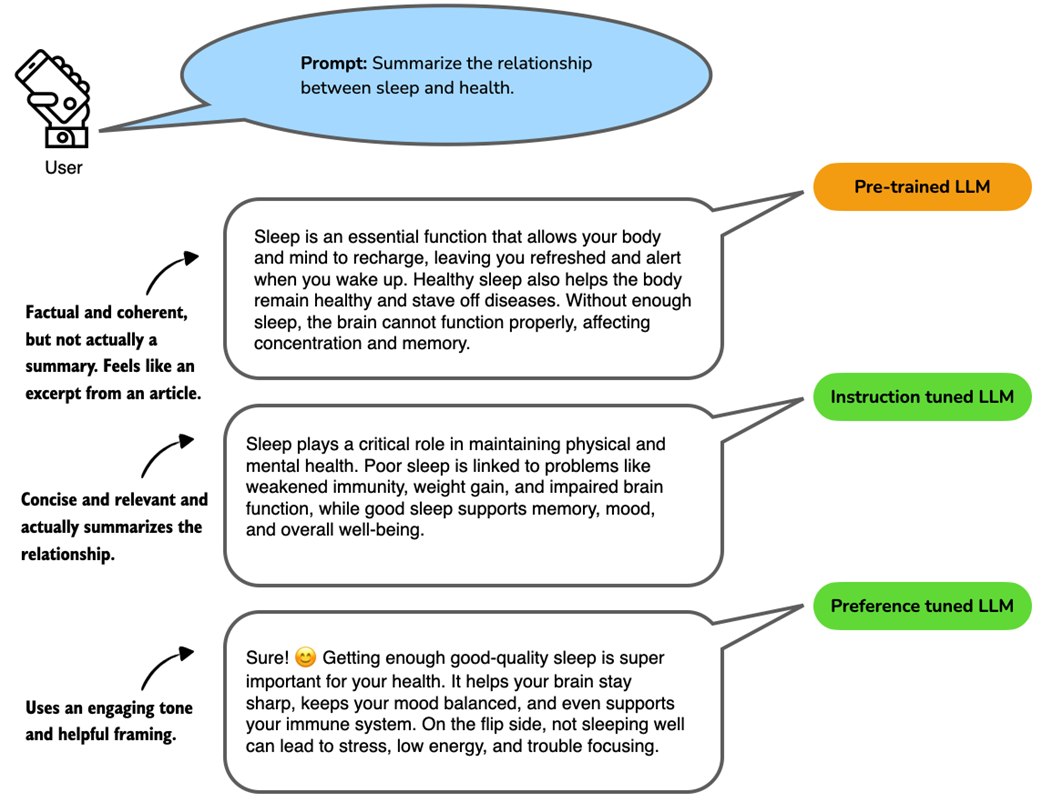
指令微调提升了 LLM 处理"个人助理式"任务的能力,例如问答、文本摘要与翻译等等。接下来的偏好调优阶段再对这些能力做精炼:顾名思义,它让回答更贴合用户偏好。有些读者可能熟悉"人类反馈强化学习"或 RLHF 这类术语,它们是实现偏好调优的具体技术。
总之,我们可以把预训练理解为"原始的语言预测”(通过 next token 预测),它赋予 LLM 一些基本属性和产出连贯文本的能力;后训练阶段则通过指令微调提升 LLM 对任务的理解,并通过偏好调优精炼 LLM,使其产出符合偏好风格的答案。
值得注意的是,即便经过指令微调,一个模型也还不是“chatbot”。聊天界面额外加了一层,在交互式、多轮的场景中引导模型响应,这通常涉及系统提示词(system prompt)、对话历史管理以及其他编排工作。
三、用训练与推理技术改进 LLM 推理
LLM 的推理在公众视野中走红,始于 2024 年 9 月 12 日 OpenAI 在 ChatGPT 中宣布 o1 模型,它让"LLM 推理"这个概念流行起来。在公告文章(https://openai.com/index/introducing-openai-o1-preview/ )中,OpenAI 提到:“我们开发了一系列新的 AI 模型,它们被设计成在回应之前花更多时间思考。”
OpenAI 还写道:“这些增强的推理能力,对你处理科学、编程、数学及类似领域的复杂问题时可能特别有用。”
几个月后的 2025 年 1 月,DeepSeek 发布了 DeepSeek-R1 模型与技术报告(https://arxiv.org/abs/2501.12948 ),详细说明了开发推理模型的训练方法论。这件事引起了巨大反响:他们不仅免费开放了一个能与专有 o1 模型竞争甚至超越其性能的模型,还分享了一份训练此类模型的蓝图。
开发和提升 LLM 推理能力的不同思路,可以归为三大: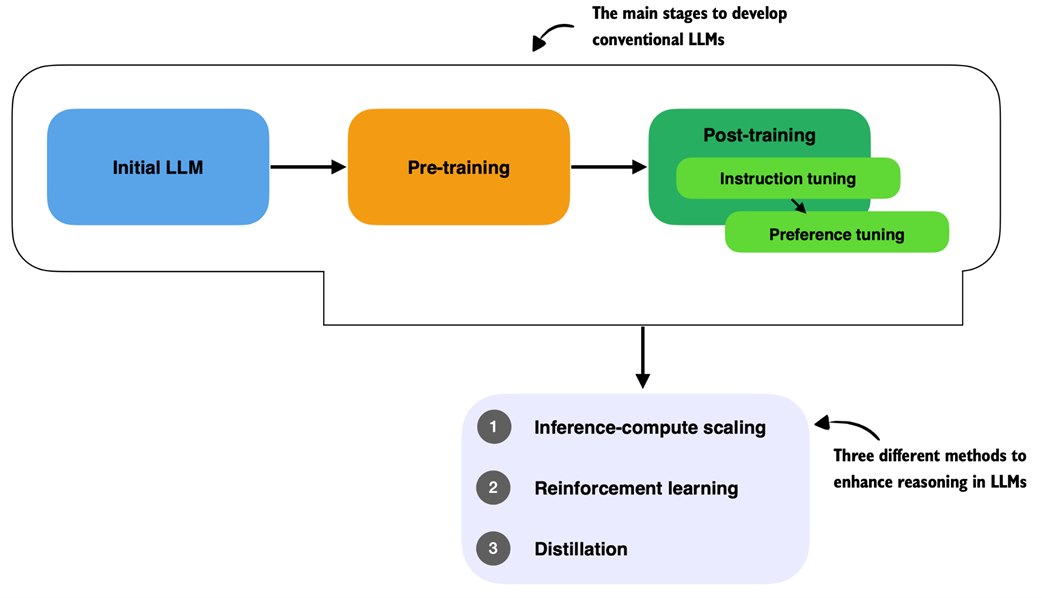
这些方法通常应用于已经过常规预训练和后训练(包括指令微调与偏好调优)的 LLM。下面这份清单简要介绍我们将在全书中详细考察的三种常见方法。
-
inference-time compute scaling——也常被称为 inference-compute scaling、test-time scaling 或其他变体。这类方法在推理时(用户向模型提问时)提升模型的推理能力,而不训练或修改底层模型权重。核心思想是用更多计算资源换取更好的性能,通过思维链推理、各种采样流程等技术,即使模型是固定的也能变得更强。
-
强化学习(Reinforcement Learning, RL)——指通过鼓励模型采取能带来高奖励信号的行动来提升推理能力的训练方法。这些奖励可以是宽泛的,例如任务是否成功或启发式打分;也可以是窄定义、可验证的,例如数学题或编程任务中的正确答案。 与不修改模型就能提升推理表现的推理时计算量扩展不同,RL 会在训练过程中更新模型权重。这使得模型能够通过与环境反馈的交互,以试错的方式学习和精炼推理策略。
-
蒸馏(Distillation)——把强大大模型学到的复杂推理模式迁移到更小或更高效的模型中。在 LLM 语境下,这通常意味着:用一个更大、更强的模型生成的高质量标注指令数据集来做监督微调(SFT)。这一技术在 LLM 文献中常被称为知识蒸馏(knowledge distillation)或简称蒸馏。需要注意,它与深度学习中传统的知识蒸馏略有不同——传统的做法是较小的"学生"模型通常同时从较大"教师"模型的输出和 logits 中学习。
面向推理的强化学习 vs 偏好调优 在开发推理模型的语境下,必须把这里的 RL 与 RLHF(人类反馈强化学习)区分开——后者是在开发常规 LLM 的偏好调优阶段使用的。 两者使用同样的底层过程(RL),主要差别在于奖励如何获得和验证:RLHF 依赖人类判断,而面向推理的 RL 依赖自动化的验证器或环境。 RLHF 把人类对模型输出的显式评价或排序作为奖励信号,直接引导模型走向人类偏好的行为。相比之下,推理模型语境下的 RL 通常依赖自动化或基于环境的奖励信号,它可能更客观,但也可能与人类偏好对齐得更差。举例来说,推理模型开发流水线中的 RL 可能通过为"正确性"提供显式奖励,训练模型在数学证明上表现出色;而 RLHF 则会让人类评估者对多个回答进行排序,以鼓励与人类标准和主观偏好紧密对齐的输出。
四、模式匹配 vs 逻辑推理
如上一节所述,在预训练期间,LLM 接触海量文本,并通过识别和复现其中的统计关联来学习预测下一个 token。这个过程让它能生成流畅连贯的文本,但它从根本上基于学到的统计规律性,而不是显式规则或有保证的逻辑推断。
LLM 响应提示的方式,是生成与训练中见过的模式在统计上一致的文本延续。其中包含大量"前提→结论"式的模式,看起来很像逻辑推断。关键区别在于:模型并没有显式地表示前提并应用形式化规则,它只是从训练数据中的相似样本预测最可能的延续。
看这个例子:
Prompt
德国的首都是……

Response
柏林。
LLM 输出"柏林”,并不是在逻辑上推导出这个答案。它是在回忆从训练数据中学到的强统计关联。这种行为正是我们所说的模式匹配(pattern matching):模型基于学到的相关性来补全文本,而不是应用结构化的推理步骤。
但那些超出模式识别的任务呢——也就是正确答案依赖于从给定事实中得出结论的任务?这就把我们引向另一种能力:逻辑推理(logical reasoning)。
逻辑推理涉及系统地运用规则来得出结论。与模式匹配不同,它依赖中间的推理步骤,以及识别矛盾、依据形式关系推出蕴含的能力。
把下面这个提示作为例子:
Prompt: "所有鸟都会飞。企鹅是鸟。企鹅会飞吗?"
这件事有两种评估方式。
第一,在封闭世界(仅凭提示)设定下,从提示中的两个前提(论断、假设)——“所有鸟都会飞"和"企鹅是鸟”——出发,有效的答案是"是的,企鹅会飞"。
第二,在开放世界(带背景知识)设定下,如果允许引入提示之外的背景知识(例如企鹅不会飞),那么这个外部事实就与从前提推出的结论相冲突,如下图所示。一个推理系统应当注意到这个不一致,并且要么请求澄清,要么弱化第一个陈述(例如改成"大多数鸟会飞,企鹅等除外")。
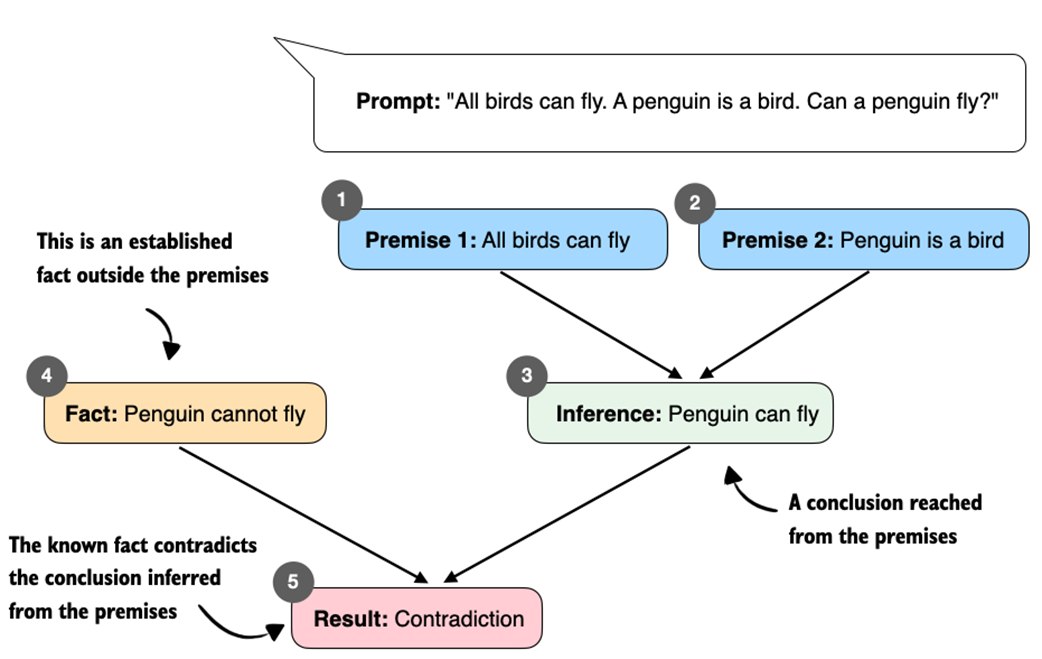
上图展示了一个基于逻辑推理的系统可以如何处理前面那个"所有鸟都会飞……“的提示。
相反,一个统计式的(模式匹配的)LLM 并不会显式追踪上图那样的矛盾,它只是基于学到的文本分布做预测。举例说,如果"所有鸟都会飞"这类信息在训练数据中被强烈强化,模型就可能自信地回答:“是的,企鹅会飞。”
下一节我们来看一个具体的例子:LLM 到底如何处理这个"所有鸟都会飞……“的提示。
逻辑推理与基于规则的系统 为什么显式的基于规则的系统没有那么流行?规则系统在 80、90 年代曾被广泛用于医疗诊断、法律决策和工程领域,如今仍在关键领域(医学、法律、航空航天)使用——这些领域往往要求显式的推断和透明的决策过程。它们的实现很困难,因为在很大程度上依赖人工设计的启发式规则。(启发式是简单的决策规则,能快速给出"足够好"的答案,但不保证最优。)相比之下,包括 LLM 在内的深度神经网络不实现手写规则,它们从数据中学习决策模式,在大规模训练下可以非常灵活。
五、在没有显式规则的情况下模拟推理
我们已经看到,相互矛盾的前提会导致逻辑上的不一致。常规 LLM 并不显式追踪矛盾,而是基于学到的文本分布生成回答。
来看一个具体的例子:像 OpenAI ChatGPT 中的 GPT-4o 这样未经推理增强的 LLM,如何响应上一节讨论的"所有鸟都会飞……“提示。
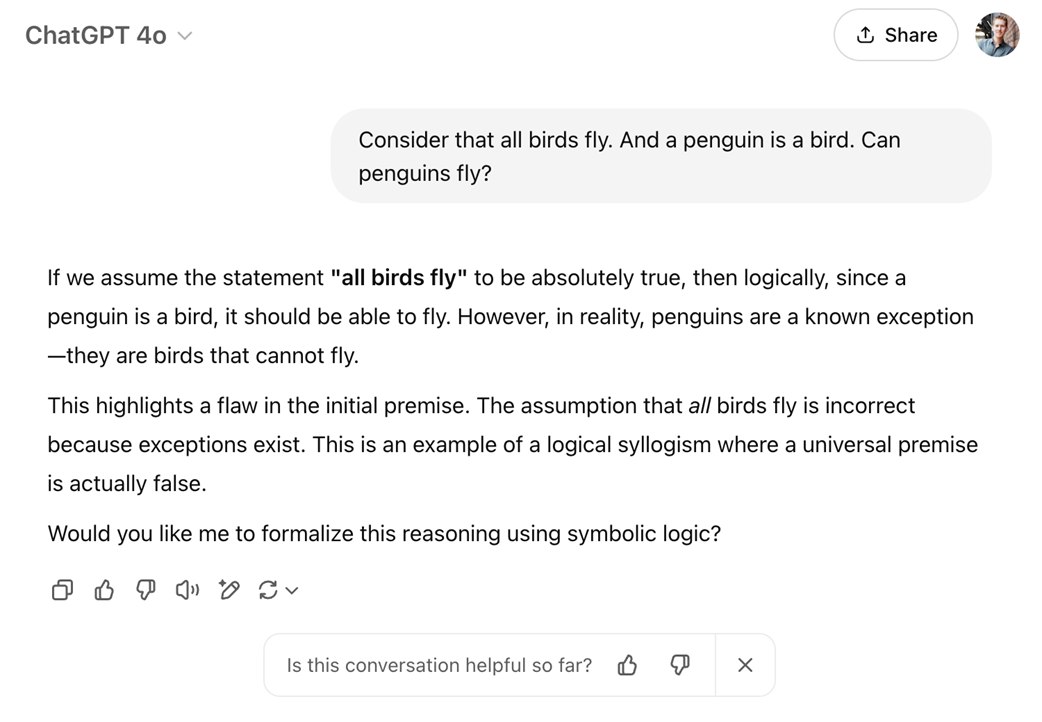
上图的例子显示,GPT-4o 看起来答对了,尽管它并不被视为推理模型——不像 OpenAI 的 o1、o3、o4-mini 以及更新的 GPT-5,那些模型是明确用推理方法论开发出来的。
那么 4o 模型是如何生成它的回答的?这是否意味着 GPT-4o 在做显式的逻辑推理?不一定。至少可以说,4o 非常擅长在熟悉的情境中模拟逻辑推理。
GPT-4o 并不实现显式的矛盾检查,它基于概率加权的模式生成答案。如果训练数据中包含大量纠正这一矛盾的例子(例如"企鹅不会飞"这类文本),从而使模型学到"企鹅"与"不会飞"之间的统计关联,那么这种方法就足够有效。正如我们在上图中看到的,这让模型无需显式实现基于规则或显式逻辑推理的方法论就能答对。
换句话说,模型之所以隐式地识别出矛盾,是因为它在训练中已经频繁遇到过完全相同的推理场景。这种有效性高度依赖大量接触"类推理"模式后建立起来的统计关联。
所以,即使一个常规 LLM 看起来在做逻辑演绎,它执行的也不是显式的、基于规则的逻辑,而是在利用其海量训练数据中的模式。
尽管如此,GPT-4o 在这里的成功很好地说明了:**大规模训练下的隐式模式匹配可以变得多么强大。**这类基于模式的"推理"通常在以下场景中会表现挣扎:
- 逻辑情境是新颖的(训练数据中未曾遇到过)。
- 推理复杂度很高,涉及错综复杂的多步逻辑关系。
我们可以说:LLM 通过学到的模式来模拟逻辑推理;而我们可以用特定的推理方法——包括推理计算量扩展,以及强化学习这类后训练策略——把它进一步提升。但它们在内部并没有显式执行任何基于规则的逻辑。
另外值得提一点:**LLM 中的推理存在于一个连续谱(spectrum)上。**这意味着,即使在 OpenAI 的 o1、DeepSeek-R1 这类专门的推理模型出现之前,LLM 就已经能够模拟推理行为了。例如,这些模型已经表现出符合我们前面定义的行为,比如生成中间步骤来得出正确结论。我们今天明确标注为"推理模型"的东西,本质上是这种能力更精致的版本。而这些被提升的推理能力,是通过借助特定的推理计算量扩展技术以及有针对性的后训练方法——例如强化学习——来实现的,这些方法的设计目的正是改进和强化类推理的行为。
六、为什么要从零构建推理模型?
自 2025 年 1 月 DeepSeek-R1 发布以来,提升 LLM 的推理能力已成为 AI 领域最热门的话题之一,这有其充分理由:更强的推理技能让 LLM 能处理更复杂的问题,从而在用户关心的各类任务上更有能力。
这一转变也反映在 OpenAI CEO 于 2025 年 2 月 12 日的一段表态中:
“我们接下来会发布 GPT-4.5,也就是内部称为 Orion 的模型,作为我们最后一个非思维链(non-chain-of-thought)模型。在那之后,我们的一个首要目标是统一 o 系列模型和 GPT 系列模型,创建能够使用我们所有工具、知道何时该长时间思考、何时不必、并且对极广泛任务都有用的系统。”
上面这段话凸显了头部 LLM 提供商向推理模型的重大转变。其中"思维链(chain-of-thought)“指的是一种prompt engineerning方法,它引导语言模型逐步推理以提升推理能力
同样值得注意的是"知道何时该长时间思考、何时不必"这个说法。它暗示了一个重要的设计考量:推理并不总是必要或可取的。
例如,推理模型被设计为擅长复杂任务,如解谜题、高阶数学问题和有挑战性的编程任务;它们在 agent 系统中也常常有用,尤其是任务分解、规划和选择使用哪个工具。但在更简单的任务上,比如摘要、翻译、基于知识的问答,它们并不是必需的。
事实上,把推理模型用于一切反而低效且昂贵。推理模型通常使用成本更高、输出更啰嗦,并且有时因为"过度思考(overthinking)“而更容易出错。这里适用一条简单原则:为任务选择正确的工具(或正确类型的 LLM)。
推理模型往往比非推理模型更贵,原因有两个。
第一,它们倾向于产出更长的输出,因为其中包含解释答案如何得出的中间步骤。如图下图所示,LLM 一次生成一个 token,而每个 token 都需要一次完整的前向传播。如果一个推理模型的回答长度是两倍,生成过程就大致需要两倍的前向传播次数,从而增加了计算成本。
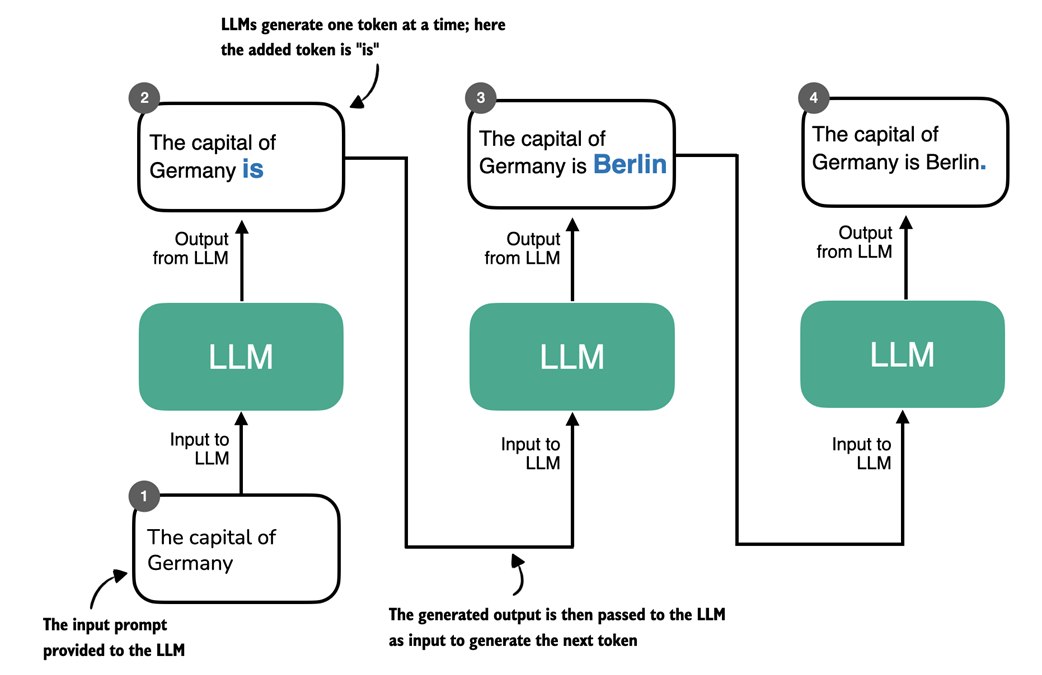
第二,许多推理工作流对单个任务需要多次运行模型,例如采样多个候选解答、调用工具、或运行一个验证器。这些额外的调用成倍增加了处理的 token 总数,使成本进一步超出上图所示的单次调用行为。
而这恰恰是"从零实现这些模型和方法"有价值的原因——这是理解它们如何工作的最佳途径之一。如果我们理解了 LLM 以及这些推理模型如何工作,就能更好地理解这些权衡取舍。
七、从零构建推理模型的路线图
总体而言,路线图很简单:我们从一个常规 LLM 出发,学会如何评估它的推理行为,然后探索改进它的两大途径——推理技术与训练技术。下图概括了主要步骤。
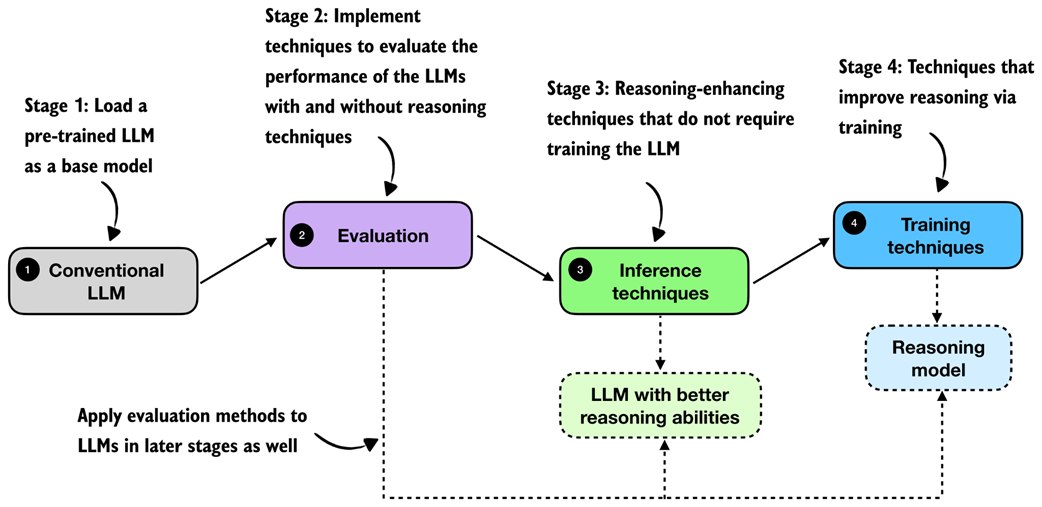
- 阶段 1 在上图中是一个明确的步骤,因为实践中推理方法通常应用于已有的基座 LLM,而不是从零训练。所以我们从一个已经预训练好的常规 LLM 开始,把它当作我们希望改进的baseline。
- 阶段 2 实现评估工具,用来判断某个方法是否真的有帮助。这正是为什么阶段 3 和 4 会回到评估:在通过推理时方法或额外训练改进推理行为之后,我们回到阶段 2 度量这个改动是否真的有效。
- 阶段 3 在推理时改进推理行为,不改变模型权重;而阶段 4 通过额外训练改进模型本身,把预训练 LLM 变成一个专用的推理模型。
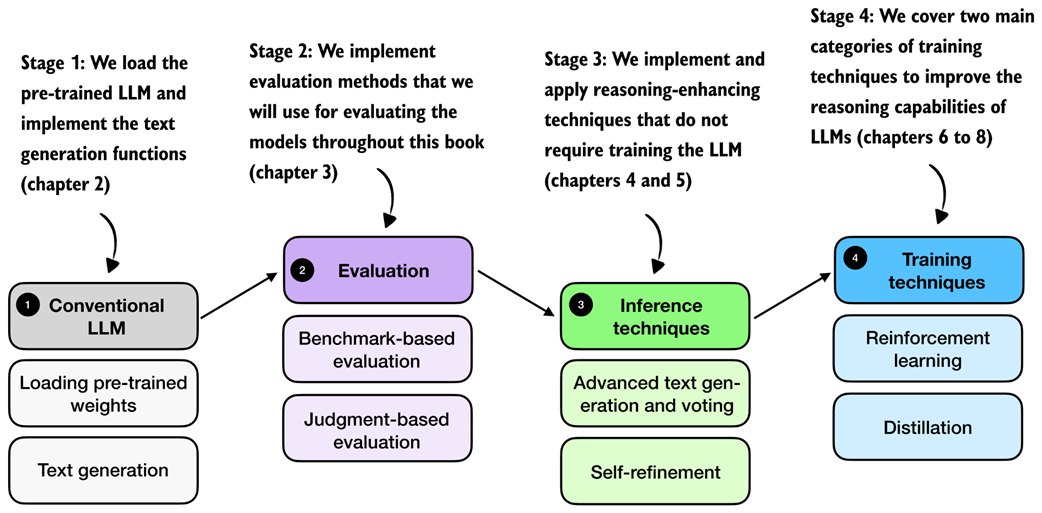
第 2 章引入基座模型,第 3 章建立评估方法,第 4、5 章覆盖两种推理时技术,第 6–8 章覆盖两种训练时技术。
八、小结
-
常规 LLM 训练发生在若干阶段:
- 预训练——模型从海量文本中学习语言模式。
- 指令微调——改进模型对用户提示的响应。
- 偏好调优——让模型输出与人类偏好对齐。
- 推理方法是在一个常规 LLM 之上应用的。
-
LLM 中的推理指的是改进模型,使其在给出最终答案之前显式生成中间步骤(思维链),这通常会提升多步任务上的准确率。
-
LLM 中的推理不同于基于规则的推理,它很可能也与人类推理的运作方式不同;目前的共识是,LLM 中的推理依赖于统计模式匹配。
-
LLM 中的模式匹配纯粹依赖从数据中学到的统计关联,这带来流畅的文本生成,但缺乏显式的逻辑推断。
-
改进 LLM 推理可以通过以下途径实现:
- 推理时计算量扩展——不重新训练即可增强推理(例如思维链提示)。
- 强化学习——用奖励信号显式训练模型。
- 监督微调与蒸馏——使用来自更强推理模型的样本。
-
从零构建推理模型能让我们对 LLM 的能力、局限和计算权衡获得实践性的洞察。
说些什么吧!