
零、写在前面
方法本身并不复杂,但是背后的观察是很值得学习的,试图对一下大佬的电波
作者的报告:[CVPR 2026] [Best Paper Finalist] ViT³: Unlocking Test-Time Training in Vision
之前读过:论文精读 | Delta Mem,当时一直没想明白为什么压缩的 memory state,要想办法做到用 k 去逼近 v。
其实就是照搬的 $ViT^3$ 的方法,读完之后对于注意力机制有了新的认识。
而且,复杂精妙的设计 和 Simple 但是 Scale well 之间如何权衡,也是一个值得思考的问题。
一、标题
来源:CVPR 2026 Best Paper Finalist
代码:ViTTT
1.1 ViT³ ?
ViT³: Vision Test-Time Training
标题中的 Unlocking 也很关键。作者并不是第一个提出 TTT layer,而是认为 TTT 在视觉领域的潜力被一个巨大的设计空间“锁住”了:
- inner loss 应该选什么;
- inner learning rate 应该多大;
- 每个序列分多少 mini-batch;
- inner loop 更新多少次;
- inner model 用线性层、MLP、GLU 还是卷积;
- inner model 应该加宽还是加深。
二、摘要
2.1 问题
Vision Transformer 的 Softmax attention 在序列长度为 N 时需要 O(N²) 计算与显存。图像分辨率提高、检测与分割输入变长后,这个二次复杂度会迅速成为瓶颈。
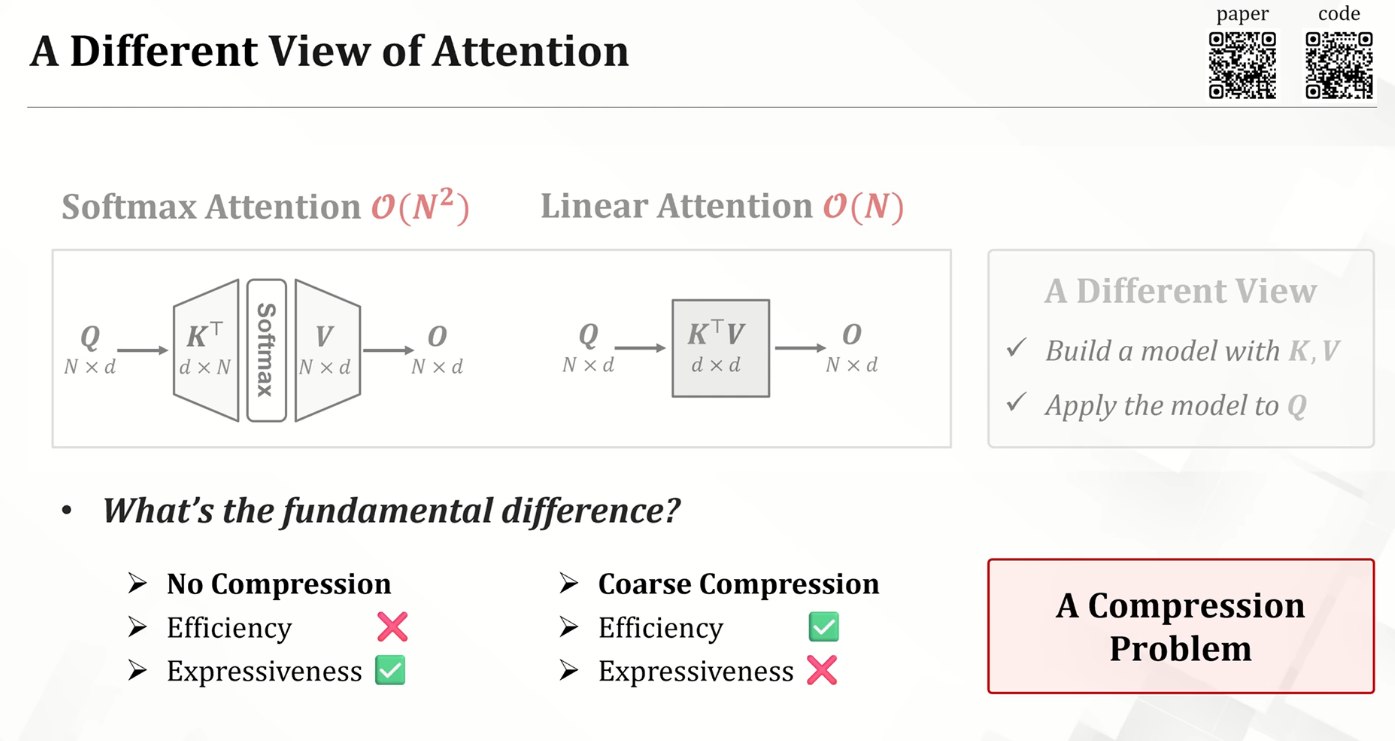
Linear attention、Mamba 等工作尝试把复杂度降为 O(N),但线性注意力通常需要把整个上下文压缩到容量有限的状态中,表达能力容易弱于高度优化的 Softmax Transformer。
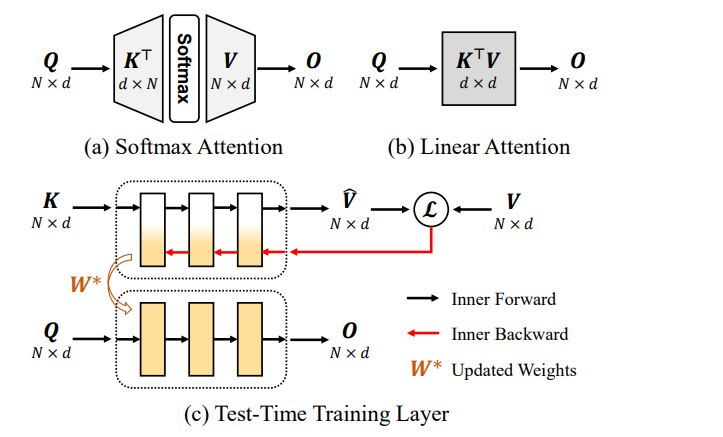
TTT 提供了另一种视角:
当前序列的 K、V
      ↓ 视作临时训练集
在测试时快速更新 inner model 的权重 W
      ↓
用更新后的 F_W*(Q) 产生输出
问题在于,TTT 的灵活性带来了大量尚未系统研究的选择。已有工作证明它“可以工作”,但没有给出视觉场景中稳定、有效且高效的设计准则。
2.2 本文工作
作者围绕两个维度进行系统消融:
- Inner training configuration:loss、learning rate、batch size、epoch;
- Inner model design:网络宽度、深度、结构类型与计算成本。
最终总结出六条经验:
- mixed second derivative 消失的 inner loss 不适合 TTT;
- 视觉任务中,一次 full-batch inner update 效果很好;
- 较大的 inner learning rate(论文取
1.0)有效; - 增大 inner model 容量能够持续提升性能;
- 在当前训练机制下,加深 inner model 会出现明显优化困难;
- 卷积尤其适合作为视觉 TTT 的 inner model。
2.3 结论
作者将这些结论组合成 ViT³:
-
使用 dot-product inner loss;
-
对每个输入执行一次 full-batch gradient update;
作者认为,nlp 任务,上下文具有因果关系,但是对于视觉任务,mini-batch gradient update反而不那么work。
-
inner learning rate 为
1.0; -
主要 inner model 使用简化 gated linear unit;
-
每个 TTT block 中有一个 head 使用 depthwise convolution;
-
构建非层级
ViT³、四阶段层级H-ViT³和生成模型DiT³。
实验覆盖:
- ImageNet-1K 图像分类;
- COCO 目标检测与实例分割;
- ADE20K 语义分割;
- ImageNet-1K class-conditional image generation;
- 高分辨率吞吐与显存测试。
三 、引言
3.1 从 Softmax attention 到 linear attention
标准 attention 为:
$$ O=\operatorname{Softmax}(QK^\top)V. $$
当 $Q,K,V ∈ R^{N×d}$ 时,需要显式或隐式处理 N × N 的 token 关系,复杂度随 N² 增长。
Linear attention 通过核映射和矩阵乘法结合律,把计算顺序从:
$$ (QK^\top)V $$变成:
$$ Q(K^\top V), $$
从而先将上下文压缩为 d × d 状态 K^T V,再作用于所有 query,复杂度降为 O(N)。
但这种方法的问题也很直接:
- 所有 token 信息被压缩进固定大小的线性矩阵;
- 压缩规则基本由一次矩阵乘法决定;
- 内部状态缺乏非线性与可适应的学习过程;
- 长序列中可能丢失大量关键上下文。
序列建模本质就是压缩问题,我们希望实现高效序列建模就必须做压缩,因为不压缩存储就存不下来,并且计算非常昂贵,也只能做一些稀疏的方法来降低一些计算,这是不本质的。
我们希望将 context 进行压缩,这样存储和计算都能降低,同时我们还希望模型能有较好的压缩能力,信息损失不能太大,这是一个既要又要的问题。
而 deeplearning 本质就是通过学习来进行压缩的强大压缩方法,在此背景下,本文的 TTT 就应运而生了。
3.2 TTT 为什么可能比 linear attention 更强?
作者将三种机制统一解释为“为当前上下文构造一个函数”:
| 机制 | 对上下文的表示 | 本质 | 复杂度 |
|---|---|---|---|
| Softmax attention | 保留全部 K,V |
隐藏宽度为 N 的两层 MLP |
O(N²) |
| Linear attention | W = K^T V |
一个 d × d 线性层 |
O(N) |
| TTT | 通过若干梯度步得到 W* |
任意可训练的紧凑网络 F_W |
取决于 inner model,可为 O(N) |
TTT 的优势在于,inner model 不必局限为一个线性矩阵。它可以是:
- MLP;
- gated linear unit;
- depthwise convolution;
- 理论上也可以是更深的网络或其他架构。
因此,TTT 将“上下文压缩”从固定公式升级为一个 learned compression process。
3.3 核心研究问题
作者明确提出:
如何为高效且高表达能力的 Test-Time Training module 建立设计原则,并进一步打开 TTT 的改进空间?
这使论文更像一篇 design-space study + strong baseline paper,而不只是单点模块创新。
真的需要多读优秀论文来提升自己的 taste,这篇论文的引言结构非常清楚:
Softmax attention 很强,但 O(N²)
→ Linear attention 是 O(N),但容量不足
→ TTT 允许任意 inner model,理论空间更大
→ 设计空间太大,缺少原则
→ 系统消融得到六条原则
→ 组合为 ViT³,并在四类任务上验证
先建立了一个统一视角,让读者理解“为什么 TTT 值得研究”。
四、相关工作
4.1 Vision Transformer 与高效注意力
ViT、DeiT、Swin 等模型证明了 attention 在分类、检测和分割中的能力,但标准全局 attention 随序列长度二次增长。
已有高效化路线主要包括:
- 局部 attention:只计算局部窗口内的 token 关系;
- 稀疏 attention:选择部分 token pair;
- 低秩或核化 attention:近似 Softmax 或改变计算顺序;
- 线性序列模型:linear attention、Mamba/SSM 等;
- 层级架构:逐级下采样,在高层减少 token 数量。
ViT³ 属于线性复杂度路线,但它的状态不是固定 SSM recurrence,也不是简单 K^T V,而是由 inner-loop learning 得到的 fast weights。
4.2 Test-Time Training
论文引用的 TTT 路线把序列建模解释成在线学习:
- 当前 token 的 key-value pair 构成临时数据;
- inner model 在上下文内部学习;
- 更新后的权重携带当前序列的信息;
- query 通过该模型读取上下文。
相关工作已将 TTT 用于:
- language modeling;
- 长视频生成;
- 3D reconstruction;
- test-time scaling 和 recurrent-depth 类计算。
ViT³ 的区别是,它不只把已有 TTT layer 搬到图像上,而是系统回答“视觉 TTT 应该怎样训练、怎样设计 inner model”。
4.3 与 fast weight programmer、meta-learning 的关系
TTT 的 W* 是典型 fast weights:
W0是跨样本学习的慢参数;W*是针对当前输入临时得到的快参数;- 外层训练要反向传播穿过 inner update;
- 本质上是一个可微的双层优化问题。
因此它和 MAML/meta-learning 很接近:外层不是只学习最终权重,而是在学习一个“容易被当前上下文快速更新”的初始化与表示空间。
4.4 与传统 Test-Time Adaptation 的区别
| 维度 | 传统 Test-Time Adaptation | ViT³ 中的 TTT layer |
|---|---|---|
| 目的 | 适应 domain shift / corrupted test data | 完成单个输入内部的 sequence modeling |
| 更新对象 | 通常是整个模型或 BN/adapter | 每个 block 内的 compact inner model |
| 持续性 | 可能跨测试样本累计 | 通常每个序列从学习到的 W0 重新开始 |
| 监督信号 | entropy、consistency 等 | (K,V) 自监督重构目标 |
| 外层训练 | 不一定为测试更新而训练 | 显式反传穿过 inner update,端到端学习 |
所以这篇论文中的 TTT 更准确地理解为 per-input differentiable learning layer。
五、Preliminaries
5.1 Softmax attention:一个宽度为 N 的隐式 MLP
设输入:
$$ x\in\mathbb{R}^{N\times C}, $$投影得到:
$$ Q=xW_Q,\quad K=xW_K,\quad V=xW_V, $$其中 $Q,K,V \in R^{N×d}$。
单头 Softmax attention 为:
$$ O_i=\sum_{j=1}^{N} \frac{\exp(Q_iK_j^\top)}{\sum_{k=1}^{N}\exp(Q_iK_k^\top)}V_j. $$作者将其重写为:
$$ O=\sigma(QK^\top)V =\sigma(QW_1)W_2 =\operatorname{MLP}(Q), $$其中:
$$ W_1=K^\top,\qquad W_2=V. $$这个视角的含义是:
K^T相当于第一层权重;V相当于第二层权重;- Softmax 相当于激活函数;
- hidden width 等于 token 数量
N。
它表达力强,但对 N 个 query 运行一个宽度为 N 的网络,自然需要 O(N²)。
5.2 Linear attention:将上下文压缩为 d × d 权重
Linear attention 对 Q,K 使用可分离 kernel feature map φ(·),利用结合律改变计算顺序。忽略归一化标量后:
因此可以解释为:
K,V --一次矩阵乘法--> d×d 线性层 W
Q   --通过该线性层--> 输出 O
优点是复杂度降为 O(N);缺点是所有上下文被压缩到一个线性状态,且压缩过程本身没有通过针对当前序列的优化来选择信息。
5.3 TTT:把 (K,V) 看成一个临时数据集
TTT 定义当前序列的 inner dataset:
$$ \mathcal D=\{(K_i,V_i)\}_{i=1}^{N}. $$
对大小为 B 的 inner batch:
然后执行快速更新:
$$ W\leftarrow W-\eta\frac{\partial \mathcal L(\widehat V_B,V_B)}{\partial W}. $$
经过一个或少数几个 inner steps 后得到 W*,最终输出为:
这里有两个层级:
- Inner loop:用当前序列的
(K,V)更新F_W; - Outer loop:在 ImageNet、COCO 等真实任务上训练整个网络,并反向传播穿过 inner update。
W0 不是随机初始化,而是 outer model 的可学习参数。外层训练实际上在学习:
- 怎样生成适合作为临时训练集的
K,V; - 什么样的
W0能用一步梯度快速吸收上下文; - 更新后的
F_{W*}如何为 query 产生有用表示。
5.4 为什么仍然是线性复杂度?
如果 inner model 对每个 token 的计算成本是常数级、总成本为 O(N),那么:
- 在
K上 inner forward:O(N); - 对 inner loss backward:
O(N); - 在
Q上 outer/query forward:O(N)。
因此总复杂度仍为 O(N)。
考虑一下常数的话,作者估算一次 inner epoch 大约需要:
K forward 1× + backward 2× + Q forward 1× ≈ 4 个 forward-equivalent FLOPs
所以 TTT 的优势主要会在 N 足够大时显现。
六、Test-Time Training Designs
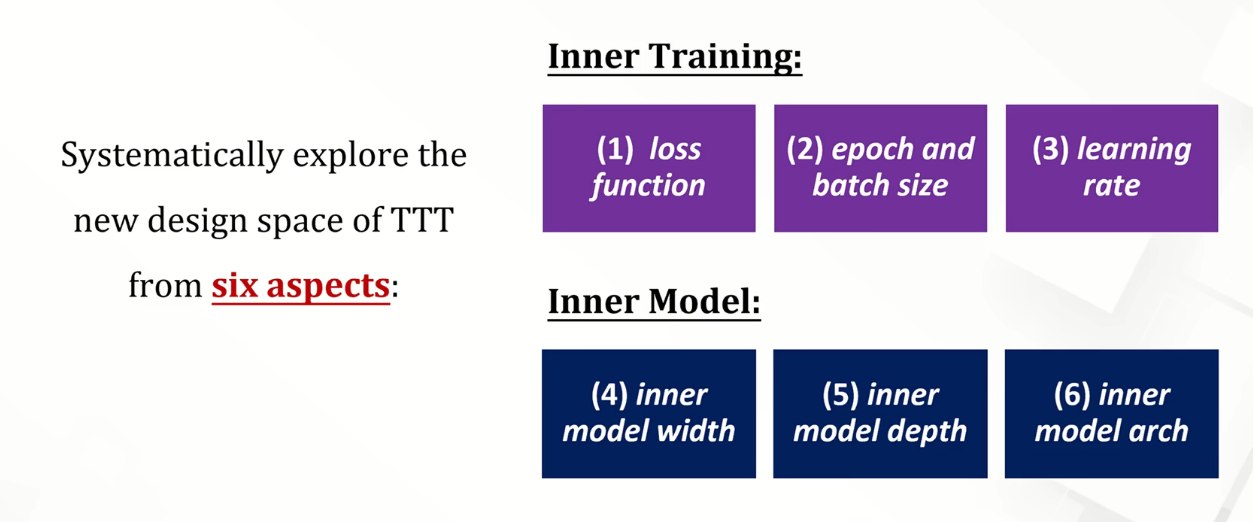
作者用 DeiT-S 作为统一 baseline,将 attention 替换为 TTT layer,在 ImageNet-1K 上训练 300 epochs。每次只改变一个 inner design,尽量隔离变量。
6.1 Insight 1:mixed second derivative 消失的 loss 不适合 TTT
现象
| Inner loss | Params | FLOPs | FPS | ImageNet Top-1 |
|---|---|---|---|---|
| Dot Product | 23.5M | 4.58G | 1315 | 78.9 |
| MSE / L2 | 23.5M | 4.63G | 1296 | 79.2 |
| RMSE | 23.5M | 4.63G | 1269 | 78.8 |
| MAE / L1 | 23.5M | 4.63G | 1292 | 76.5 |
| Smooth L1 | 23.5M | 4.63G | 1292 | 78.1 |
MAE 明显最差,Smooth L1 也弱于 Dot Product、MSE 和 RMSE。
原因
$V=xW_V$ 来自 outer model 的 value projection。外层梯度必须穿过 inner update:
$$ G=\frac{\partial \mathcal L(\widehat V,V)}{\partial W}. $$对 $W_V$ 的梯度包含:
$$ \frac{\partial G}{\partial W_V} \propto \frac{\partial \widehat V}{\partial W} \cdot \frac{\partial^2\mathcal L} {\partial \widehat V\,\partial V} \cdot \frac{\partial V}{\partial W_V}. $$如果 mixed second derivative:
$$ \frac{\partial^2\mathcal L} {\partial \widehat V\,\partial V} $$为零或接近零,外层就难以学习 $W_V$ 应该如何构造 inner target。
例如:
- Dot Product loss 的 mixed derivative 为非零常数;
- MSE 的 mixed derivative也为非零常数;
- MAE 的导数是
sign,除不可导点外二阶混合导数几乎处处为零; - Smooth L1 在其线性区间的 mixed derivative 为零。
深层含义
普通监督学习只关心 loss 对预测值的一阶梯度是否能优化当前模型;TTT 是 nested optimization,还必须关心该梯度能否继续向 outer parameters 传播。
适合普通训练的 loss,不一定适合需要“梯度穿过梯度”的 TTT/meta-learning。
论文最后选择 Dot Product loss,主要因为效果接近最佳且计算最省:
$$ \mathcal L_{dot} =-\frac{1}{B\sqrt d}\sum_{i=1}^{B}\widehat V_iV_i^\top. $$6.2 Insight 2:视觉任务适合一次 full-batch inner update
Batch size 消融
| Inner epochs | Inner batch | FPS | Top-1 |
|---|---|---|---|
| 1 | N |
1315 | 78.9 |
| 1 | N/2 |
1201 | 78.6 |
| 1 | N/3 |
1131 | 78.3 |
| 1 | N/4 |
1101 | 78.1 |
把图像 token 顺序切成多个 mini-batch,会形成隐式因果关系:
- 前一批 token 的更新改变后续批次看到的 inner weights;
- 后一批更新可能覆盖前一批写入的内容;
- token 的处理顺序开始影响最终状态。
这种 sequential/causal bias 适合语言,但图像通常是二维、非因果的全局结构。简单地按序切 mini-batch,可能人为引入错误归纳偏置。
Epoch 消融
| Full-batch epochs | FLOPs | FPS | Top-1 |
|---|---|---|---|
| 1 | 4.58G | 1315 | 78.9 |
| 2 | 4.81G | 971 | 79.1 |
| 3 | 5.04G | 787 | 79.2 |
| 4 | 5.27G | 659 | 57.0,训练发散前最好值 |
更多 inner epochs 只能带来约 +0.3 Top-1,却显著降低吞吐,还可能破坏 outer optimization 的稳定性。
因此作者采用:
一轮、全序列、单次 batch gradient update。
这也是 ViT³ 可以并行处理图像 token 的关键。
6.3 Insight 3:inner learning rate 需要足够大
| Inner LR | 0.1 | 0.2 | 0.5 | 1.0 | 2.0 | 5.0 | 10.0 | Dynamic |
|---|---|---|---|---|---|---|---|---|
| Top-1 | 77.5 | 78.1 | 78.7 | 78.9 | 78.9 | 76.7* | 76.9* | 78.7 |
* 表示发散前的最好结果。
解释:
- LR 太小:一步更新无法把足够的上下文写入
W; - LR 太大:inner update 和 outer optimization 都容易不稳定;
- token-wise dynamic LR 在视觉实验中没有优于固定 LR;
η=1.0在更新幅度、稳定性和实现简单性之间形成良好平衡。
作者还指出,在简单线性 inner model + MSE 的特例中,LR 可以通过缩放 K,V 部分吸收。但在真实网络里,初始化尺度、归一化和其他模块使这种等价关系不再足够可靠,因此 LR 仍是关键超参数。
6.4 Insight 4:加宽 inner model 能持续提高性能
作者使用两层 SiLU MLP,将 hidden ratio 从 1d 增加到 4d:
| Inner model | Params | FLOPs | FPS | Top-1 |
|---|---|---|---|---|
| MLP, ratio 1 | 23.5M | 4.58G | 1315 | 78.9 |
| MLP, ratio 2 | 24.1M | 4.92G | 1119 | 79.2 |
| MLP, ratio 3 | 24.7M | 5.27G | 938 | 79.5 |
| MLP, ratio 4 | 25.2M | 5.62G | 836 | 79.6 |
这说明 TTT 确实能够利用比 d×d linear state 更大的非线性容量,是它相对普通 linear attention 的核心优势。
但 inner capacity 比 outer capacity 更昂贵,因为它要参与 forward、backward 和 query forward。加宽虽有效,却不是免费的。
6.5 Insight 5:当前 TTT 设置下,加深 inner model 反而变差
| Inner model depth | Top-1 |
|---|---|
| 单层 FC | 79.1 |
| 两层 MLP | 78.9 |
| 三层 MLP | 77.5 |
这不是“深网络表达力不足”,而是深 inner model 没有被有效优化。作者观察到:
- deeper inner model 的 training loss 更高;
- training loss 越高,最终 test accuracy 越低;
- 模型理论容量增加,但实际发生 underfitting。
作者把困难分为两层:
- Outer-loop problem:外层需要学习一个适合一步更新的深层初始化
W0,难度更高; - Inner-loop problem:深层网络在极少 inner steps 中更容易出现梯度消失或爆炸,不能有效压缩
(K,V)。
支持证据包括:
| 结构 | Top-1 |
|---|---|
SiLU(FC(x)) |
79.4 |
完整 SwiGLU |
79.0 |
去掉输出投影的简化 gated unit:FC(x) ⊙ SiLU(FC(x)) |
79.7 |
去掉难优化的输出层后,性能反而提高。
标准 residual connection 和将输出矩阵初始化为 identity 只带来有限改善,仍不及浅层受限结构。论文据此认为:
如何让深 inner model 在少步更新中稳定优化,是 TTT 最有价值的未来方向之一。
6.6 Insight 6:卷积非常适合作为视觉 inner model
| Inner model | Params | FLOPs | FPS | Top-1 |
|---|---|---|---|---|
Conv 3×3 |
25.5M | 5.27G | 979 | 79.9 |
DWConv 3×3 |
22.9M | 4.25G | 1366 | 80.1 |
Depthwise convolution 同时得到更少参数、更低 FLOPs、更高 FPS 和最高 Top-1,是非常强的 Pareto choice。
作者的解释是:
- TTT update 已经把全局
(K,V)信息压缩进卷积核参数; - 卷积在 query feature map 上又显式建模局部邻域;
- 更新后的卷积核因此同时包含全局上下文和局部 spatial inductive bias。
对于 3×3 convolution,inner dataset 不再只是 $(K_i,V_i)$,而可以理解为:
即用第 i 个位置周围的九个 key token 预测对应 value。
6.7 六条洞见的逻辑关系
Loss 必须让外层梯度穿过 inner update
                    ↓
图像是非因果二维结构 → 使用 full-batch 并行更新
                    ↓
只有一步更新 → LR 必须足够大
                    ↓
想提高状态容量 → 优先加宽,而不是直接加深
                    ↓
深 inner model 难优化 → 使用浅层受限的 gated unit
                    ↓
视觉需要局部归纳偏置 → 加入 DWConv inner head
这些洞见不是彼此独立的 tricks,而是共同服务于“一步、并行、稳定、高容量的视觉 fast-weight update”。
七、ViT$^3$ : A Test-Time Training Architecture
7.1 ViT³ block 的总体结构
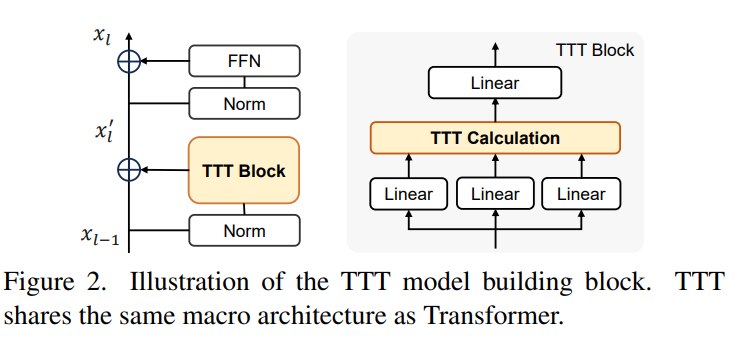
ViT³ 保留 Transformer 的宏观骨架:
x
├─ Norm → Multi-head TTT → residual add
└─ Norm → FFN            → residual add
它替换的是 attention calculation,而不是抛弃整个 Transformer block。
因此论文所谓 pure TTT architecture 更准确的含义是:
所有全局 attention blocks 均由 TTT blocks 替代;网络仍然包含 normalization、FFN、residual connection、patch embedding 等标准组件。
7.2 Inner training 配置
每个 TTT block 对当前输入执行:
- loss:Dot Product loss;
- batch:所有 token 组成一个 full batch;
- epoch:1;
- optimizer/update:一次 gradient descent;
- learning rate:
1.0。
简化伪代码如下:
# Slow parameters W0 are learned by the outer training loop.
Q = x @ W_q
K = x @ W_k
V = x @ W_v

W = W0
V_hat = inner_model(K, W)
inner_loss = dot_product_loss(V_hat, V)
grad_W = grad(inner_loss, W, create_graph=True)
W_star = W - 1.0 * grad_W

O = inner_model(Q, W_star)
create_graph=True 一类的高阶梯度机制非常重要,因为 outer loss 要穿过 W → W* 的更新。
7.3 两种 inner module
ViT³ 使用两种结构:
1. 简化 gated linear unit
$$ F_1(x)=\operatorname{FC}_a(x) \odot \operatorname{SiLU}(\operatorname{FC}_b(x)). $$它的特点是:
- 比单个
d×dlinear state 容量更大; - 没有额外 output projection,降低深层 inner optimization 难度;
- 维持浅层结构,适合一步更新。
2. Depthwise convolution
$$ F_2(x)=\operatorname{DWConv}_{3\times3}(x). $$它以低参数成本引入二维局部结构,并通过测试时更新让卷积核携带全局上下文。
7.4 Multi-head 组合方式
每个 TTT block 中:
- 一个 head 使用
F2 = DWConv; - 其余 heads 使用
F1 = gated unit。
这种设计不是在每个 head 中同时堆叠卷积和 GLU,而是利用 multi-head 机制分配不同 inner architecture:
多数 heads:高容量、全局、gated fast-weight state
一个 head:显式二维局部结构 + 全局更新后的卷积核
7.5 三个模型家族
非层级 ViT³
| Model | Patch | Blocks | Embedding dim | Heads |
|---|---|---|---|---|
| ViT³-T | 16 | 12 | 192 | 6 |
| ViT³-S | 16 | 12 | 384 | 6 |
| ViT³-B | 16 | 12 | 768 | 12 |
与 DeiT/ViT 类似,始终在单一 token resolution 上处理。
四阶段 H-ViT³
| Stage | Resolution | H-ViT³-T | H-ViT³-S | H-ViT³-B |
|---|---|---|---|---|
| 1 | H/4 × W/4 |
B(64,2)×1 |
B(64,2)×2 |
B(96,3)×2 |
| 2 | H/8 × W/8 |
B(128,4)×3 |
B(128,4)×6 |
B(192,6)×6 |
| 3 | H/16 × W/16 |
B(320,10)×9 |
B(320,10)×18 |
B(448,14)×18 |
| 4 | H/32 × W/32 |
B(512,16)×4 |
B(512,16)×8 |
B(640,20)×8 |
B(C,H) 表示 embedding dimension 为 C、head 数为 H 的 ViT³ block。
H-ViT³ 更适合检测和分割,因为它自然输出多尺度 feature maps。
DiT³
作者将 DiT 中的 Softmax attention 替换为 ViT³ block,构建:
- DiT³-S/8、S/4、S/2:12 blocks,dimension 384,6 heads;
- DiT³-B/8、B/4、B/2:12 blocks,dimension 768,12 heads。
论文强调没有针对生成任务额外搜索大量超参数,主要用于验证 TTT block 的可迁移性。
7.6 Positional encoding
模型采用 conditional positional encoding。由于 TTT 为 O(N),作者可以在高分辨率 feature map 上保持全局感受野,而不必像窗口 attention 那样强制局部分块。
7.7 方法的本质
ViT³ layer 可以理解为一个三阶段过程:
WRITE:K,V 通过 self-supervised gradient update 写入 fast weights W*
STORE:W* 作为当前输入的紧凑、非线性上下文状态
READ :Q 通过 F_W*(Q) 读取该状态
因此它既像 attention,也像 associative memory,还像一个每层都执行一次的小型 meta-learner。
八、实验
8.1 实验问题
实验主要回答四个问题:
- 六条 design insights 是否能组合成强分类模型?
- TTT backbone 能否迁移到检测和分割?
- TTT block 是否也适用于 diffusion image generation?
- 线性复杂度能否转化为真实的高分辨率吞吐和显存优势?
8.2 ImageNet-1K 分类设置
- 训练集:1.28M images;
- 验证集:50K images;
- 类别数:1000;
- 从头训练 300 epochs;
- AdamW;
- cosine learning-rate decay;
- 20 epochs linear warm-up;
- weight decay
0.05; - global batch size
4096; - initial LR
4×10^-3; - RandAugment、Mixup、CutMix、Random Erasing;
- 额外报告 MESA 训练策略结果。
8.3 非层级分类结果
| Model | Type | Params | FLOPs | Top-1 |
|---|---|---|---|---|
| DeiT-T | Transformer | 6M | 1.2G | 72.2 |
| Vim-T | Mamba | 7M | 1.5G | 76.1 |
| Agent-DeiT-T | Linear | 6M | 1.2G | 74.9 |
| ViT³-T | TTT | 6M | 1.2G | 76.5 |
| DeiT-S | Transformer | 22M | 4.6G | 79.8 |
| Vim-S | Mamba | 26M | 5.1G | 80.3 |
| Agent-DeiT-S | Linear | 23M | 4.4G | 80.5 |
| ViT³-S | TTT | 24M | 4.8G | 81.6 |
| DeiT-B | Transformer | 87M | 17.6G | 81.8 |
| ConvNeXt-B isotropic | ConvNet | 87M | 16.9G | 82.0 |
| ViT³-B | TTT | 90M | 18.0G | 82.6 |
关键观察:
- ViT³-T 相比 DeiT-T 提升
4.3Top-1; - ViT³-S 相比 DeiT-S 提升
1.8; - 在相似计算量下,ViT³ 超过表中的 Mamba 和 linear attention baseline;
- 模型增大后,相对增益缩小,说明大型 Softmax Transformer 本身已具有较高容量。
8.4 层级分类结果
| Model | Params | FLOPs | Top-1 | +MESA |
|---|---|---|---|---|
| H-ViT³-T | 29M | 4.9G | 83.5 | 84.0 |
| H-ViT³-S | 54M | 8.8G | 84.4 | 84.9 |
| H-ViT³-B | 94M | 16.7G | 84.9 | 85.5 |
对比要点:
- H-ViT³-T 达到 83.5,与 InternImage-T、MILA-T 相当;
- H-ViT³-S 以 54M/8.8G 达到 84.4,高于更大的 VMamba-B(83.9)和 SOFT-L++(84.1);
- 使用 MESA 后,H-ViT³-B 达到 85.5,在论文表格中超过 MILA-B 的 85.3;
- 但若不使用 MESA,H-ViT³ 并没有全面超过所有优化良好的 Transformer,例如 RMT-B 为 85.0、TransNeXt-S 为 84.7。
合理结论应是:
ViT³ 显著提升了线性复杂度模型的上限,并缩小与强 Transformer 的差距,而不是在所有尺度、所有训练配方下全面取代 Softmax attention。
8.5 COCO 检测与实例分割
使用 Mask R-CNN,报告 1× 和 3× schedule。
1× schedule
| Backbone | Box AP | Mask AP |
|---|---|---|
| H-ViT³-T | 47.3 | 42.8 |
| H-ViT³-S | 49.1 | 44.1 |
| H-ViT³-B | 50.0 | 44.6 |
3× schedule
| Backbone | Box AP | Mask AP |
|---|---|---|
| H-ViT³-T | 48.9 | 44.0 |
| H-ViT³-S | 50.5 | 45.0 |
| H-ViT³-B | 51.0 | 45.3 |
主要结论:
- 在长序列、高分辨率场景中,H-ViT³ 稳定优于多数 linear attention baseline;
- H-ViT³-T 的 1× Box AP 与 VMamba-T 同为 47.3,但 mask 指标略高;
- H-ViT³-S 的 3× Box AP 与 MILA-S 同为 50.5,Mask AP 为 45.0;
- 强 Transformer 仍可能更高,例如 DAT-S++ 3× Box AP 为 51.2,说明性能差距尚未完全消失。
8.6 ADE20K 语义分割
使用 UPerNet,FLOPs 按 512×2048 输入计算。
| Backbone | Type | FLOPs | mIoU |
|---|---|---|---|
| H-ViT³-T | TTT | 946G | 48.0 |
| H-ViT³-S | TTT | 1026G | 50.2 |
| H-ViT³-B | TTT | 1195G | 51.7 |
横向比较:
- T scale:H-ViT³-T 48.0,略高于 VMamba-T 47.9;
- S scale:H-ViT³-S 50.2,高于 LocalVMamba-S 50.0、SOFT-S++ 48.9、VVT-M 48.1;
- B scale:H-ViT³-B 51.7,高于 VMamba-B 51.0;
- 但 TransNeXt-S/B 分别达到 52.2/53.0,仍领先 H-ViT³。
这与作者的自我判断一致:当前浅层 inner model 已经形成强 linear baseline,但若想匹敌最佳 Transformer,还需要解决 deep inner model 的优化问题。
8.7 ImageNet class-conditional generation
作者在 DiT 上直接替换 attention,评估 256×256、FID-50K。
| Model | Params | FLOPs | FID ↓ | 相对原 DiT 改善 |
|---|---|---|---|---|
| DiT-S/8 | 33M | 0.36G | 153.60 | — |
| DiT³-S/8 | 35M | 0.40G | 143.49 | -10.11 |
| DiT-S/4 | 33M | 1.41G | 100.41 | — |
| DiT³-S/4 | 35M | 1.57G | 93.77 | -6.64 |
| DiT-S/2 | 33M | 6.06G | 68.40 | — |
| DiT³-S/2 | 35M | 6.23G | 62.65 | -5.75 |
| DiT-B/8 | 131M | 1.42G | 122.74 | — |
| DiT³-B/8 | 135M | 1.51G | 120.41 | -2.33 |
| DiT-B/4 | 130M | 5.56G | 68.38 | — |
| DiT³-B/4 | 134M | 5.88G | 65.25 | -3.13 |
| DiT-B/2 | 130M | 23.01G | 43.47 | — |
| DiT³-B/2 | 134M | 23.35G | 39.31 | -4.16 |
所有六组设置中,DiT³ 的 FID 都优于对应 DiT,说明 TTT block 不只是分类特化模块。
但需要保持克制:这些 FID 的绝对值不是与最新大型生成系统竞争的结果;实验的主要价值是 controlled replacement——在相近参数与 FLOPs 下,替换 attention 后持续改善基线。
8.8 高分辨率效率
作者在 RTX 3090 上比较 ViT³-T 与 DeiT-T。
当分辨率达到:
$$ 1248\times1248, $$patch size 为 16,因此 token 数为:
$$ (1248/16)^2=78^2=6084. $$此时 ViT³-T:
- 相对 DeiT-T 达到 4.6× throughput speedup;
- GPU memory consumption 减少 90.3%。
这是论文最能体现渐近复杂度价值的实验。低分辨率下,TTT 的 inner backward 常数开销可能抵消优势;但当 N 很大时,Softmax 的 N² 增长最终会被 ViT³ 的 N 增长明显拉开。
九、结论
9.1 论文结论
ViT³ 通过系统研究证明,Test-Time Training 可以成为视觉线性序列建模的一条有竞争力的路线。有效的视觉 TTT 不应简单复制语言模型设置,而需要围绕图像的非因果二维结构重新设计:
- 使用支持高阶梯度传播的 loss;
- 使用一次 full-batch update;
- 使用足够大的 inner LR;
- 优先增加浅层 inner model 的宽度与结构容量;
- 避免未经处理的深 inner network;
- 利用 convolution 融合局部归纳偏置和全局 fast-weight context。
最终模型在多类任务中超过大量 linear attention 和 Mamba baseline,并在高分辨率下展示显著的吞吐和显存优势。
9.2 贡献
ViT³ 给出了三个概念转变。
转变一:Attention 可以被看成“构造临时函数”
Softmax:用完整 K,V 构造宽度 N 的隐式 MLP
Linear attention:用 K^T V 构造 d×d 线性层
TTT:用梯度更新构造任意紧凑 inner model
这个统一视角把 attention、fast weights 和 meta-learning 连接起来。
转变二:上下文压缩可以是学习过程,而不是固定算子
传统 linear attention 用一次矩阵乘法压缩上下文;TTT 用当前序列上的自监督优化决定怎样写入状态。状态的架构和写入规则都可以设计。
转变三:线性复杂度模型的容量瓶颈可以从“状态大小”转化为“inner learner 设计”
TTT 允许扩大、非线性化甚至卷积化内部状态。不过新的瓶颈也随之出现:
- 高阶梯度;
- inner/outer 双层优化;
- 测试时 backward;
- 深 inner model 的稳定性;
- 常数计算开销。
9.3 最终评价
ViT³ 是一篇非常典型、也很有价值的“打开设计空间”论文。它的亮点不在于堆叠复杂模块,而在于:
- 提出统一、容易理解的 attention-as-learning 视角;
- 用受控实验找到六条可操作原则;
- 用二阶梯度和优化分析解释现象;
- 构建简单但覆盖多任务的强基线;
- 明确展示线性复杂度在 6084-token 图像上的真实收益。
它目前还没有证明 TTT 会全面替代 Softmax Transformer。测试时 backward、较大的常数开销以及深 inner model 的优化困难,仍是落地障碍。但它成功证明了:
视觉序列的上下文不一定只能存进 attention matrix 或固定 recurrent state,也可以存进一个针对当前图像即时学习的神经网络权重中。
这正是 ViT³ 最值得学习和继续研究的思想。
说些什么吧!