
零、写在前面
依旧练手。
源码:REINFORCE
一、REINFORCE
1.1 CartPole Setup
1.1.1 环境简介
CartPole 比较适合策略梯度法,而且训的超级快,便于验证。
import gymnasium as gym
import torch

env = gym.make("CartPole-v1", render_mode="human")

obs_dim = env.observation_space.shape[0]
action_dim = env.action_space.n

print(obs_dim)
print(action_dim)
4
2
可以简单写个循环看一下:
import gymnasium as gym
import torch
import random
from typing import Tuple, List, Dict

env = gym.make("CartPole-v1", render_mode="human")

obs_dim = env.observation_space.shape[0]
action_dim = env.action_space.n

obs, _ = env.reset()
while True:
    action = env.action_space.sample()
    obs, reward, terminated, truncated, info = env.step(action)
    if terminated or truncated: break
env.close()
CartPole 的简介:
Action Space
The action is a
ndarraywith shape(1,)which can take values{0, 1}indicating the direction of the fixed force the cart is pushed with.
- 0: Push cart to the left
- 1: Push cart to the right
Note: The velocity that is reduced or increased by the applied force is not fixed and it depends on the angle the pole is pointing. The center of gravity of the pole varies the amount of energy needed to move the cart underneath it
Observation Space
The observation is a
ndarraywith shape(4,)with the values corresponding to the following positions and velocities:
Num Observation Min Max 0 Cart Position -4.8 4.8 1 Cart Velocity -Inf Inf 2 Pole Angle ~ -0.418 rad (-24°) ~ 0.418 rad (24°) 3 Pole Angular Velocity -Inf Inf
1.1.2 封装成 Agent 类
import gymnasium as gym

class Agent:
    def __init__(self):
        self.env = gym.make("CartPole-v1", render_mode=None)

    def run(self, num_episodes: int = 5):
        for episode in range(num_episodes):
            obs, _ = self.env.reset()
            total_reward = 0.0
            steps = 0

            while True:
                # 随机采样动作
                action = self.env.action_space.sample()

                obs, reward, terminated, truncated, _ = self.env.step(action)
                total_reward += reward
                steps += 1

                if terminated or truncated:
                    print(f"Episode {episode:2d} | 总步数: {steps:3d} | 总奖励: {total_reward:5.1f}")
                    break

        self.env.close()

if __name__ == "__main__":
    agent = Agent()
    agent.run(num_episodes=5)
1.2 PolicyNet
1.2.1 REINFORCE 原理
REINFORCE 算法的核心公式:
$$ \nabla_\theta J(\theta) = \mathbb{E}_{s \sim d_{\pi_\theta}} \left[ \sum_a \nabla_\theta \pi_\theta(a|s) \, Q^{\pi_\theta}(s,a) \right] $$我们用蒙特卡洛方法来估计 $Q$:
$$ J(\theta) = \mathbb{E}_{s \sim d_{\pi_\theta}} \left[ \sum_t \log \pi_\theta(a_t|s_t) \, G_t \right] $$$$ \text{loss} = -\sum_t \log \pi_\theta(a_t | s_t) \, G_t $$其中 $G_t$ 是从时间步 $t$ 开始的折扣累积回报:
$$ G_t = R_{t+1} + \gamma R_{t+2} + \gamma^2 R_{t+3} + \cdots $$关于为什么只用计算从当前时刻开始的汇报,在我之前的博客有详细证明:ch09策略梯度法
1.2.2 PolicyNet 实现
class PolicyNet(nn.Module):
    def __init__(self, obs_dim: int, action_dim: int, hidden_dim=64):
        super().__init__()
        self.fc = nn.Sequential(
            nn.Linear(obs_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, action_dim)
        )
        self.softmax = nn.Softmax(dim=-1)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.softmax(self.fc(x))

    def sample_action(self, obs: torch.Tensor) -> Tuple[int, torch.Tensor]:
        probs = self.forward(obs)
        dist = Categorical(probs)
        action = dist.sample()
        log_prob = dist.log_prob(action)
        return action.item(), log_prob

    def get_action(self, obs: torch.Tensor) -> int:
        probs = self.forward(obs)
        return torch.argmax(probs).item()
1.2.3 agent 决策逻辑更改
然后把原来的随机策略改成网络决定就行了。
import gymnasium as gym
from policy import PolicyNet
import torch
import torch.nn as nn
import torch.optim as optim
from typing import Tuple

# device = 'cuda' if torch.cuda.is_available() else 'cpu'
device = 'cpu' # 模型很小,用cpu就行

class Agent:
    def __init__(self, env_id: str = 'CartPole-v1', render_mode: str = None, device: str = 'cpu'):
        self.device = device
        self.env = gym.make(env_id, render_mode=render_mode)
        self.obs_dim = self.env.observation_space.shape[0]
        self.action_dim = self.env.action_space.n

        self.policy = PolicyNet(self.obs_dim, self.action_dim)
        self.optimizer = optim.Adam(self.policy.parameters(), lr=1e-3)

    def run(self, num_episodes: int = 5):
        for episode in range(num_episodes):
            obs, _ = self.env.reset()
            total_reward = 0.0
            steps = 0

            while True:
                obs_tensor = torch.tensor(obs, dtype=torch.float32, device=self.device)
                action = self.policy.get_action(obs_tensor)

                obs, reward, terminated, truncated, _ = self.env.step(action)
                total_reward += reward
                steps += 1

                if terminated or truncated:
                    print(f"Episode {episode:2d} | 总步数: {steps:3d} | 总奖励: {total_reward:5.1f}")
                    break

        self.env.close()

if __name__ == '__main__':
    agent = Agent()
    agent.run()
1.3 训练
一些参数配置:
DATE_FORMAT = "%m-%d %H:%M:%S"

# device = 'cuda' if torch.cuda.is_available() else 'cpu'
device = 'cpu' # 模型很小,用cpu就行

class Agent:
    def __init__(
        self,
        env_id: str = "CartPole-v1",
        device: str = "cpu",
        gamma: float = 0.99,
        lr: float = 1e-3,
    ):
        self.device = torch.device(device)
        self.gamma = gamma
        self.env_id = env_id

        # 主训练环境
        self.env = gym.make(env_id)
        self.obs_dim = self.env.observation_space.shape[0]
        self.action_dim = self.env.action_space.n

        self.policy = PolicyNet(self.obs_dim, self.action_dim).to(self.device)
        self.optimizer = optim.Adam(self.policy.parameters(), lr=lr)

        # 记录目录与日志
        base_dir = os.path.dirname(os.path.abspath(__file__))
        self.checkpoint_dir = os.path.join(base_dir, "checkpoints")
        self.plot_dir = os.path.join(base_dir, "plots")
        self.log_file = os.path.join(base_dir, "REINFORCE.log")

        os.makedirs(self.checkpoint_dir, exist_ok=True)
        os.makedirs(self.plot_dir, exist_ok=True)
训练循环:
流程很简单,采样——计算折扣率——计算loss——反向传播
    def train(
        self,
        target_reward: float = 475.0,
        max_episodes: int = 1000,
        plot_interval: int = 20,
    ):
        print(f"开始训练 REINFORCE(目标平均奖励: {target_reward})...")

        # 日志写入开始标记
        self._init_log()

        episode_rewards = []
        avg_rewards = []
        best_100_avg = -float("inf")

        for episode in range(1, max_episodes + 1):
            log_probs = []
            rewards = []

            obs, _ = self.env.reset()
            done = False
            episode_reward = 0.0

            # 轨迹采样
            while not done:
                obs_tensor = torch.as_tensor(
                    obs, dtype=torch.float32, device=self.device
                )
                action, log_prob = self.policy.sample_action(obs_tensor)
                obs, reward, terminated, truncated, _ = self.env.step(action)

                log_probs.append(log_prob)
                rewards.append(reward)
                episode_reward += reward
                done = terminated or truncated

            # 计算折扣回报 (Discounted Returns)
            returns = []
            G = 0.0
            for r in reversed(rewards):
                G = r + self.gamma * G
                returns.append(G)
            returns.reverse()
            returns = torch.tensor(
                returns, dtype=torch.float32, device=self.device
            )

            # 标准化 Returns(极大地稳定梯度)
            if len(returns) > 1:
                returns = (returns - returns.mean()) / (returns.std() + 1e-8)

            # 计算损失并更新网络
            log_probs = torch.stack(log_probs)
            loss = -(log_probs * returns).sum()

            self.optimizer.zero_grad()
            loss.backward()
            self.optimizer.step()

            # 统计指标
            episode_rewards.append(episode_reward)
            last_100 = episode_rewards[-100:]
            current_avg = float(np.mean(last_100))
            avg_rewards.append(current_avg)

            # 保存最佳模型(覆盖保存,避免文件泛滥)
            if current_avg > best_100_avg and len(last_100) >= 10:
                best_100_avg = current_avg
                self._save_model(episode, current_avg, is_best=True)
                self._log_training(episode, episode_reward, current_avg, loss.item())
                print(
                    f"{datetime.datetime.now().strftime(DATE_FORMAT)}: "
                    f"Episode {episode:4d} | 单轮奖励: {episode_reward:5.1f} | "
                    f"近100轮均值: {current_avg:5.1f} | Loss: {loss.item():.4f}"
                )
                self._plot_reward(episode_rewards, avg_rewards)

            # 早停
            if current_avg >= target_reward and len(last_100) >= 100:
                print(
                    f"\n达到目标平均奖励 {target_reward}!在 Episode {episode} 提前结束!"
                )
                break

        # 训练结束后保存最终图谱和最终权重
        self._plot_reward(episode_rewards, avg_rewards)
        self._save_model(episode, current_avg, is_best=False)
        print("\n训练全部结束!")
一些辅助函数:
    def evaluate(self, num_episodes: int = 5, render: bool = False):
        """测试已训练好的策略(使用贪心动作)"""
        eval_env = gym.make(
            self.env_id, render_mode="human" if render else None
        )
        print(f"\n开始策略评估 ({num_episodes} 轮)...")

        for ep in range(num_episodes):
            obs, _ = eval_env.reset()
            total_reward = 0.0
            done = False

            while not done:
                obs_tensor = torch.as_tensor(
                    obs, dtype=torch.float32, device=self.device
                )
                action = self.policy.get_action(obs_tensor)
                obs, reward, terminated, truncated, _ = eval_env.step(action)
                total_reward += reward
                done = terminated or truncated

            print(f"评估轮次 {ep + 1:2d} | 总得分: {total_reward:5.1f}")
        eval_env.close()

    def load_model(self, model_path: str = "checkpoints/best_policy.pth"):
        """加载已训练好的模型权重"""
        if not os.path.exists(model_path):
            print(f"模型文件不存在: {model_path}")
            return False

        try:
            checkpoint = torch.load(model_path, map_location=self.device)
            self.policy.load_state_dict(checkpoint["model_state_dict"])
            print(f"成功加载模型: {os.path.basename(model_path)}")
            return True
        except Exception as e:
            print(f"加载模型失败: {e}")
            return False

    def _save_model(self, episode: int, avg_reward: float, is_best: bool = True):
        """保存模型权重并打印绝对路径"""
        filename = (
            "best_policy.pth" if is_best else f"final_policy_ep{episode}.pth"
        )
        checkpoint_path = os.path.join(self.checkpoint_dir, filename)
        torch.save(
            {
                "episode": episode,
                "model_state_dict": self.policy.state_dict(),
                "optimizer_state_dict": self.optimizer.state_dict(),
                "avg_reward": avg_reward,
            },
            checkpoint_path,
        )

    def _plot_reward(self, episode_rewards, avg_rewards):
        """绘制波形图"""
        plt.figure(figsize=(10, 5))
        plt.plot(
            episode_rewards,
            alpha=0.3,
            color="steelblue",
            label="Episode Reward",
        )
        plt.plot(
            avg_rewards,
            color="firebrick",
            linewidth=2.0,
            label="100-Episode Moving Avg",
        )
        plt.title(f"REINFORCE Training - {self.env_id}")
        plt.xlabel("Episode")
        plt.ylabel("Reward")
        plt.grid(True, alpha=0.3)
        plt.legend(loc="upper left")

        plot_path = os.path.join(self.plot_dir, "training_curve.png")
        plt.savefig(plot_path, dpi=120, bbox_inches="tight")
        plt.close()

    def _init_log(self):
        with open(self.log_file, "w", encoding="utf-8") as f:
            f.write(
                f"\n{'='*20} 训练启动: {datetime.datetime.now().strftime('%Y-%m-%d %H:%M:%S')} {'='*20}\n"
            )

    def _log_training(self, episode, episode_reward, avg_reward, loss):
        log_msg = f"{datetime.datetime.now().strftime(DATE_FORMAT)}: Episode {episode:4d} | Reward: {episode_reward:5.1f} | 100-Avg: {avg_reward:5.1f} | Loss: {loss:.4f}\n"
        with open(self.log_file, "a", encoding="utf-8") as f:
            f.write(log_msg)

    def close(self):
        self.env.close()
测一下:
if __name__ == "__main__":
    agent = Agent(env_id="CartPole-v1", device=device, lr=1e-3)

    agent.train(target_reward=490, max_episodes=2000)

    agent.evaluate(num_episodes=5, render=True)

    agent.close()
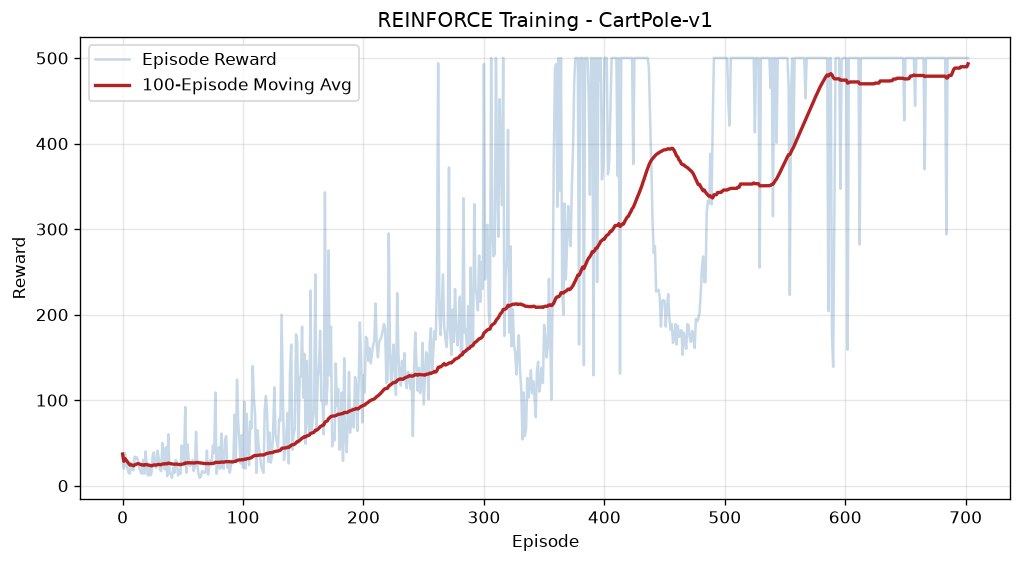
效果还不错:
开始训练 REINFORCE(目标平均奖励: 490)...
08-29 19:08:50: Episode   10 | 单轮奖励:  18.0 | 近100轮均值:  23.3 | Loss: 0.0821
08-29 19:08:50: Episode   11 | 单轮奖励:  34.0 | 近100轮均值:  24.3 | Loss: -0.1274
08-29 19:08:50: Episode   12 | 单轮奖励:  32.0 | 近100轮均值:  24.9 | Loss: 0.6187
08-29 19:08:50: Episode   13 | 单轮奖励:  33.0 | 近100轮均值:  25.5 | Loss: -0.0594
... 此处省略xxx个字
08-29 19:12:06: Episode  697 | 单轮奖励: 500.0 | 近100轮均值: 489.7 | Loss: 2.8534
08-29 19:12:07: Episode  698 | 单轮奖励: 500.0 | 近100轮均值: 489.8 | Loss: -2.8727
08-29 19:12:09: Episode  703 | 单轮奖励: 500.0 | 近100轮均值: 493.2 | Loss: 1.8832

达到目标平均奖励 490!在 Episode 703 提前结束!

训练全部结束!

开始策略评估 (5 轮)...
评估轮次  1 | 总得分: 500.0
评估轮次  2 | 总得分: 500.0
评估轮次  3 | 总得分: 500.0
评估轮次  4 | 总得分: 500.0
评估轮次  5 | 总得分: 500.0
1.4 更困难的游戏
Lunar Lander,一个2D的月球着陆的小游戏。
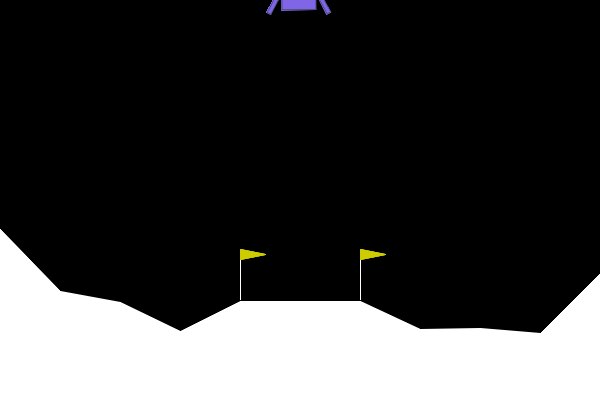
一些简介:
Action Space
There are four discrete actions available:
- 0: do nothing
- 1: fire left orientation engine
- 2: fire main engine
- 3: fire right orientation engine
Observation Space
The state is an 8-dimensional vector: the coordinates of the lander in
x&y, its linear velocities inx&y, its angle, its angular velocity, and two booleans that represent whether each leg is in contact with the ground or not.
训练一下:
if __name__ == "__main__":
    agent = Agent(env_id="LunarLander-v3", device=device, hidden_dim=128, lr=5E-4)

    agent.train(target_reward=450, max_episodes=20000)

    agent.evaluate(num_episodes=5, render=True)

    agent.close()
开始训练 REINFORCE(目标平均奖励: 450)...
08-29 19:40:58: Episode   10 | 单轮奖励: -151.9 | 近100轮均值: -216.0 | Loss: -0.9449
08-29 19:40:59: Episode   11 | 单轮奖励: -155.1 | 近100轮均值: -210.5 | Loss: 0.1107
08-29 19:40:59: Episode   16 | 单轮奖励: -129.7 | 近100轮均值: -207.4 | Loss: -0.3034
08-29 19:41:00: Episode   17 | 单轮奖励: -201.9 | 近100轮均值: -207.1 | Loss: 0.6742
08-29 19:41:00: Episode   18 | 单轮奖励: -125.9 | 近100轮均值: -202.6 | Loss: 0.6264
... 省略
08-29 20:16:07: Episode 5093 | 单轮奖励: 122.3 | 近100轮均值: 188.2 | Loss: 125.9519
08-29 20:16:09: Episode 5096 | 单轮奖励: 278.2 | 近100轮均值: 189.4 | Loss: -5.8852
08-29 20:16:10: Episode 5097 | 单轮奖励: 277.1 | 近100轮均值: 189.4 | Loss: 18.9638
08-29 20:16:11: Episode 5098 | 单轮奖励: 145.2 | 近100轮均值: 189.6 | Loss: 142.5494
08-29 20:16:12: Episode 5101 | 单轮奖励: 236.4 | 近100轮均值: 189.8 | Loss: 15.7785
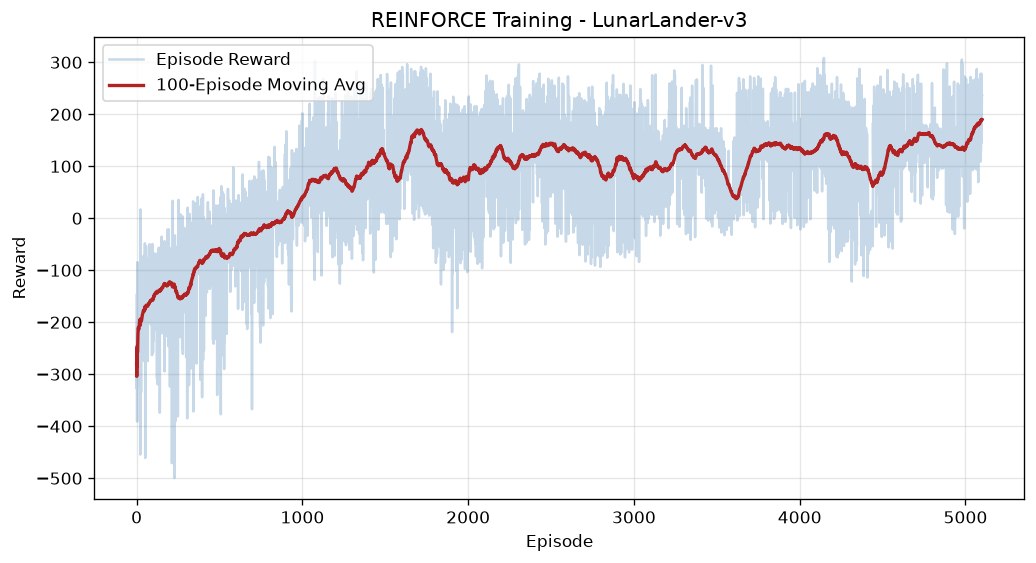
可见到后期增长非常缓慢了,这基本就是 REINFORCE 算法的上限了,当然调调参可能更好一些。
说些什么吧!