零、写在前面
方法很简单,基本算是换皮 Search-R1,属于占坑工作。
一、标题
来源:ACL 2026
标题里的 R1 延续了 Search-R1、WebAgent-R1 一类工作的命名习惯:把某种 Agent 能力建模为带结果奖励的序列决策问题,再通过 reinforcement learning 学习策略。
Memory-R1 要学习两种能力:
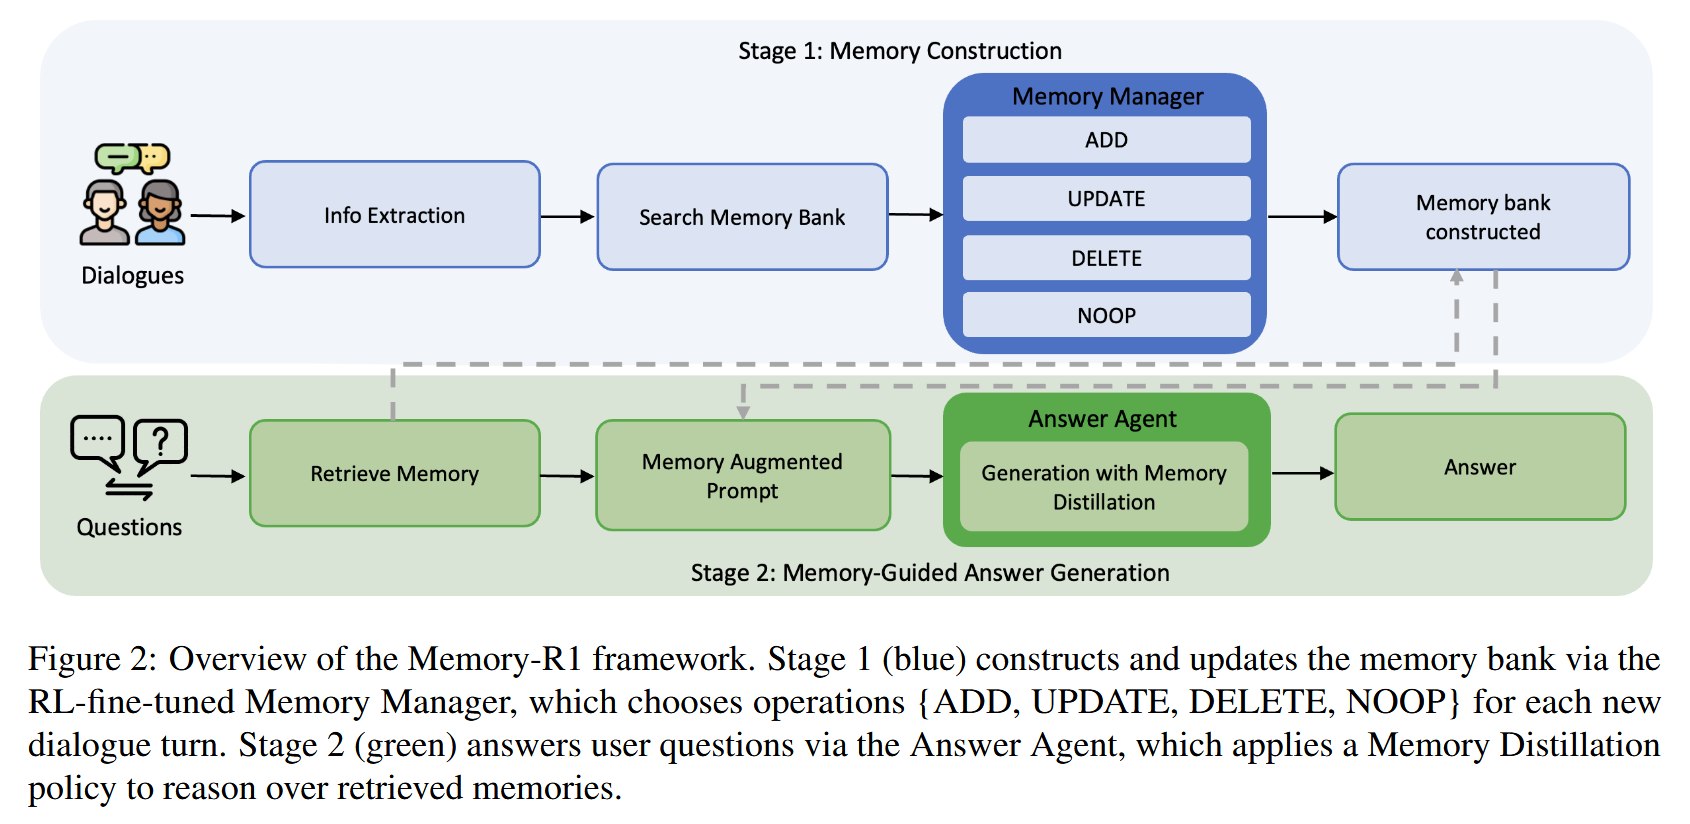
- Manage Memories(管理记忆):新对话到来时,决定执行
ADD、UPDATE、DELETE还是NOOP。 - Utilize Memories(使用记忆):面对问题和检索到的大量候选记忆,先筛选真正相关的信息,再生成答案。
因此,它不是只训练一个“会调用向量数据库”的问答模型,而是由两个专门 Agent 组成:
| Agent | 主要任务 |
|---|---|
| Memory Manager | 维护外部 memory bank |
| Answer Agent | 从候选记忆中蒸馏证据并回答 |
二、背景
2.1 问题
传统 Agent Memory pipeline 往往是手工规则驱动的。例如:
抽取当前对话中的事实
→ 搜索相似旧记忆
→ 根据提示词执行 ADD / UPDATE / DELETE
→ 查询时用向量检索召回若干条记忆
→ 全部拼入 prompt 回答
这种方法有两类局限:
- 管理端缺乏学习:操作由 prompt 和启发式规则决定,不一定有利于最终任务。
- 使用端缺乏筛选:RAG 可能召回过少而漏证据,也可能召回过多而引入噪声。
2.2 相关工作
2.2.1 Memory-Augmented LLM Agents
论文回顾了两类典型系统:
- 外部持久记忆:MemoryBank、Mem0、A-Mem 等负责抽取、组织、更新和检索用户历史;
- 上下文管理:MemGPT、ReadAgent 等负责将超长信息在 working context 与外部存储之间调度或压缩。
Memory-R1 与它们共享文本 memory bank 和 RAG 接口,但关键差别是:
传统方法大多通过 prompt 或固定规则选择 memory operation;Memory-R1 用最终问答奖励学习操作策略。
2.2.2 LLM Reinforcement Learning
论文将自身放在 RLHF、ReAct、Toolformer、Search-R1 和 trial-and-error Agent 的发展线上。
这些工作说明,LLM 不仅可以学习“生成哪句话”,也可以学习更高层行为:
- 是否搜索;
- 调用哪个工具;
- 选择哪条推理轨迹;
- 何时执行某种外部操作。
Memory-R1 将这一思想迁移到 memory:
- Memory Manager 的 action 是记忆操作及其内容;
- Answer Agent 的 action 是证据选择过程和最终答案;
- 最终答案是否正确构成可程序计算的 reward。
2.3 为什么 memory operation 适合用 RL?
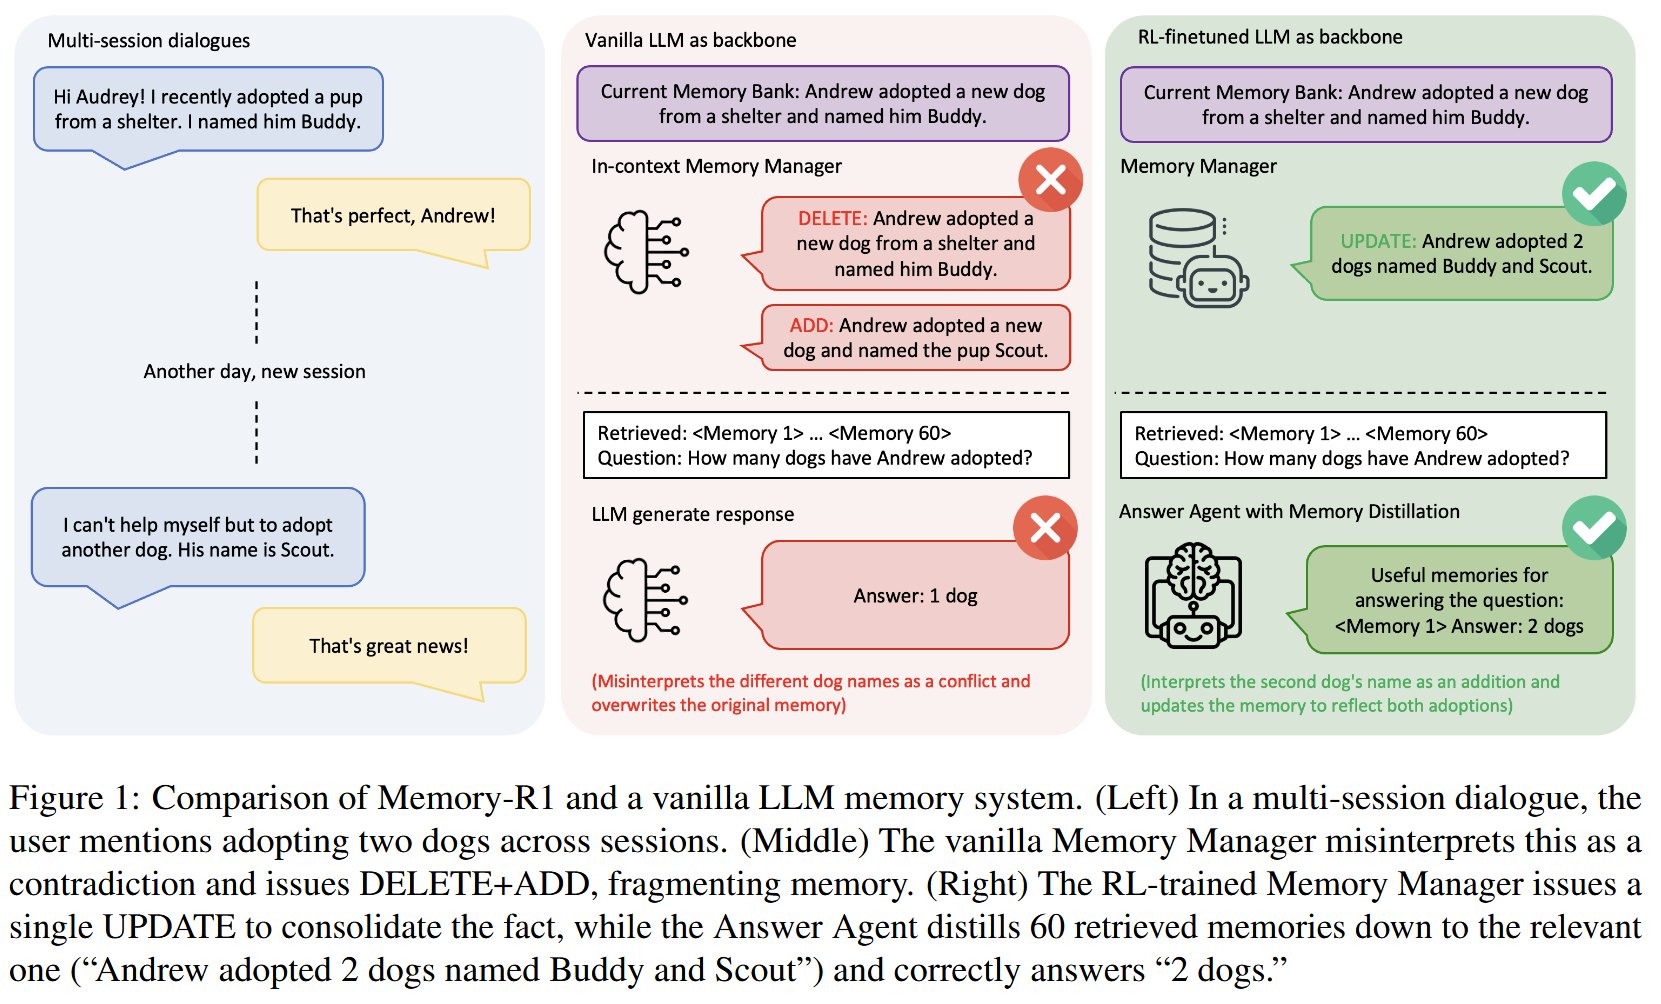
一条操作是否正确,经常不能只看动作本身,需要看它对未来问答的影响。
例如,旧 memory 是:
Andrew 收养了一只名叫 Buddy 的狗。
新对话是:
Andrew 又收养了一只名叫 Scout 的狗。
表面上,新旧句子中的狗名不同。启发式 manager 可能误判为冲突:
DELETE Buddy
ADD Scout
但更合理的操作是:
UPDATE: Andrew 收养了两只狗,Buddy 和 Scout。
Memory-R1 不为这个样本人工标注“正确操作必须是 UPDATE”,而是让不同操作产生不同的最终 memory bank,再通过下游问题“Andrew 有几只狗?”是否答对给予奖励。
这属于 outcome-driven learning(结果驱动学习):不直接告诉模型每一步怎么做,而是根据最终效果优化策略。
三、方法
3.1 RL 任务定义
3.1.1 State
状态写为:
$$ s=(x,M_{old}), $$其中:
- $x$:当前 dialogue turn 抽取出的新信息;
- $M_{old}$:与新信息相关的现有 memory entries。
例如:
x: Andrew 又收养了一只名叫 Scout 的狗
M_old: Andrew 收养了一只名叫 Buddy 的狗
3.1.2 Action
Memory Manager 输出:
$$ (o,m')\sim\pi_\theta(\cdot\mid x,M_{old}), $$其中:
- $o\in\{ADD,UPDATE,DELETE,NOOP\}$;
- $m'$ 是操作涉及的新文本内容。
四种动作含义:
| Action | 含义 | 适用情况 |
|---|---|---|
ADD |
新建 memory entry | 新事实与现有记忆互补但适合独立保存 |
UPDATE |
合并或修订现有 entry | 新信息细化、补充或改变旧事实 |
DELETE |
删除错误或失效 entry | 旧事实确实被证据推翻或不再有效 |
NOOP |
不修改 | 信息重复、无长期价值或无需变化 |
3.1.3 Environment transition
执行 (o,m') 后,memory bank 从 $M_{old}$ 变成 $M_{new}$。随后冻结的 Answer Agent 使用新 memory bank 回答与该信息相关的问题。
因此,Memory Manager 的环境不仅是数据库,还包含:
执行 memory operation
→ 重新检索 memory
→ 冻结 Answer Agent 回答
→ 比较 gold answer
3.1.4 Reward
论文使用最终回 Exact Match:
$$ R_{answer}=EM(y_{pred},y_{gold}). $$若答案与 gold 完全匹配,奖励为正;否则奖励低或为 0。Memory Manager 没有 ADD/UPDATE/DELETE 的人工标签。
这个沿用了 Search-R1 的 reward
3.1.5 Policy
Memory Manager 本身是 LLaMA 或 Qwen backbone。它学习输出结构化 memory command。训练它时 Answer Agent 冻结,只充当 reward environment。
3.2 Memory Manager PPO
PPO 比较当前 policy 与生成 rollout 时的旧 policy:
$$ \rho_\theta= \frac{\pi_\theta(o,m'\mid x,M_{old})} {\pi_{old}(o,m'\mid x,M_{old})}. $$使用 clipped objective:
$$ J(\theta)=\mathbb E\left[ \min\left( \rho_\theta A, \operatorname{clip}(\rho_\theta,1-\epsilon,1+\epsilon)A \right) \right]. $$- 如果一个 memory operation 得到正 advantage,提高它的生成概率;
- 如果得到负 advantage,降低概率;
- clip 不允许一次更新幅度过大;
- PPO 需要 critic/value model 估计 advantage。
论文实现中:
- actor learning rate:
1×10^-6; - critic learning rate:
1×10^-5; - actor 和 critic 联合训练。
3.3 Memory Manager GRPO
对于同一个状态 $s=(x,M_{old})$,采样 $G$ 个候选操作:
$$ \{(o_i,m'_i)\}_{i=1}^{G}. $$每个候选分别更新 memory bank,再通过下游 QA 获得 reward \(r_i\)。然后做组内标准化:
$$ A_i=\frac{r_i-\operatorname{mean}(r)} {\operatorname{std}(r)}. $$目标中再加入 KL 约束:
$$ J(\theta)=\mathbb E\left[ \frac{1}{G}\sum_i \rho_\theta^{(i)}A_i -\beta D_{KL}(\pi_\theta\Vert\pi_{ref}) \right]. $$总的来说就是标准的 PPO、GRPO 实现,没有复杂设计。
3.4 Answer Agent 的任务
完成 memory bank 后,对问题 $q$ 做相似度检索:
- 从每位对话参与者的 memory bank 中各取 Top-30;
- 总计得到 60 条候选记忆 $M_{ret}$;
- Answer Agent 接收问题与 60 条候选:
它被提示先选择有用 memory,再输出不超过约 5–6 个词的答案。
所以它同时学习:
- 哪些候选记忆是证据;
- 如何结合时间、人物和事件关系;
- 如何输出简短、可被 EM/F1 评价的答案。
3.5 Answer Agent 的 PPO 与 GRPO
PPO
Answer Agent 生成完整答案 $y$,概率比是:
$$ \rho_\phi= \frac{\pi_\phi(y\mid q,M_{ret})} {\pi_{old}(y\mid q,M_{ret})}. $$reward 同样使用:
$$ R=EM(y_{pred},y_{gold}). $$PPO 用 critic 估计 advantage,再更新 Answer Agent。
GRPO
对同一个 (q, M_ret) 采样一组候选答案:
使用每个答案的 EM reward 做组内标准化,不训练 value function。
论文没有为“选中了哪条 memory”提供单独 process reward。Memory distillation 的好坏仍主要通过最终答案是否正确间接学习。因此,它的 credit assignment 比 AttriMem 的 token attribution 更粗。
3.6 两个 Agent 是否同时训练?
不是端到端同时更新。论文采用分离、交替训练:
- 训练 Memory Manager 时,Answer Agent 冻结;
- 训练 Answer Agent 时,Memory Manager 固定;
- 前一阶段构建较稳定的 memory bank,供后一阶段训练使用;
- 论文称两个模块可在交替阶段中共同适配,但一次更新只优化其中一个。
这样做的原因是 sparse reward 下 attribution ambiguity:如果两个 Agent 同时变化,答错时很难知道是 memory bank 建坏了,还是 Answer Agent 没用好。
代价是 pipeline 更复杂,也没有真正研究 joint multi-agent RL。
3.7训练数据是怎样构造的?
3.7.1 Memory Manager 数据
每个 dialogue turn 构成一个训练状态:
当前 turn
+ 由之前若干 turns 构建的 temporal memory bank
+ 与当前 turn 关联的 QA
GPT-4o-mini 用来预构建 temporal memory bank,但不会为每个样本提供 ADD/UPDATE/DELETE/NOOP gold label。真正的 operation label 由 RL 探索并通过下游 QA reward 学习。
3.7.2 Answer Agent 数据
先用训练后的 Memory Manager 遍历对话,形成完整 memory bank。对每个训练问题:
question
+ 每位参与者 Top-30 memories,共 60 条
+ gold answer
构成 Answer Agent 的 RL 输入。
3.7.3 训练集划分
LoCoMo 按 1:1:8 划分为:
- 152 个训练问题;
- 81 个验证问题;
- 1307 个测试问题。
但“152 个 QA”不等于只有 152 次模型调用:
- 一个问题关联多个 dialogue turns;
- 每个 turn 可以构建 Memory Manager state;
- 每个状态可采样多个 PPO/GRPO rollout;
- Answer Agent 对每个问题也会采样多条候选答案。
因此论文的数据监督规模确实小,但实际 rollout 数和 token 消耗远大于 152。
3.8 训练与推理配置
| 项目 | 论文设置 |
|---|---|
| Backbones | LLaMA-3.1-8B-Instruct;Qwen-2.5-3B/7B/14B-Instruct |
| RL framework | VERL |
| PPO actor LR | 1×10^-6 |
| PPO critic LR | 1×10^-5 |
| RL decoding temperature | 1.0 |
| Evaluation temperature | 0 |
| Total batch size | 128 |
| Micro-batch | 每 GPU 2 |
| Max prompt length | 4096 |
| Max response length | 2048 |
| 主要算力 | 4× NVIDIA H100 80GB |
| Qwen-2.5-14B | 8× NVIDIA H100 80GB |
这里也说明:虽然训练 QA 少,但全参数或较大规模 RL rollout 仍然是明显的算力密集型实验。
四、实验
4.1 实验设置
Benchmarks
| 数据集 | 作用 |
|---|---|
| LoCoMo | 主训练与主评测;多 session 长对话,包含 single-hop、multi-hop、open-domain、temporal QA |
| MSC | 零样本测试跨 session 对话记忆 |
| LongMemEval | 零样本测试事实召回、偏好、知识更新、多 session 和时间推理 |
LoCoMo 主文描述对话约 600 turns、26k tokens;附录则写平均约 300 turns、9k tokens、最多 35 sessions,原文在统计口径上也存在差异。
Metrics
- F1:预测答案与 gold token 的重叠;
- BLEU-1(B1):unigram overlap;
- LLM-as-a-Judge(J):独立 LLM 判断答案是否正确、相关和完整。
Baselines
- LoCoMo RAG;
- A-Mem;
- Mem0;
- MemoryOS;
- Memory-SFT:相同架构和训练数据,但用 GPT-5 trajectory 做 behavior cloning,不使用 RL。
4.2 LoCoMo 主结果
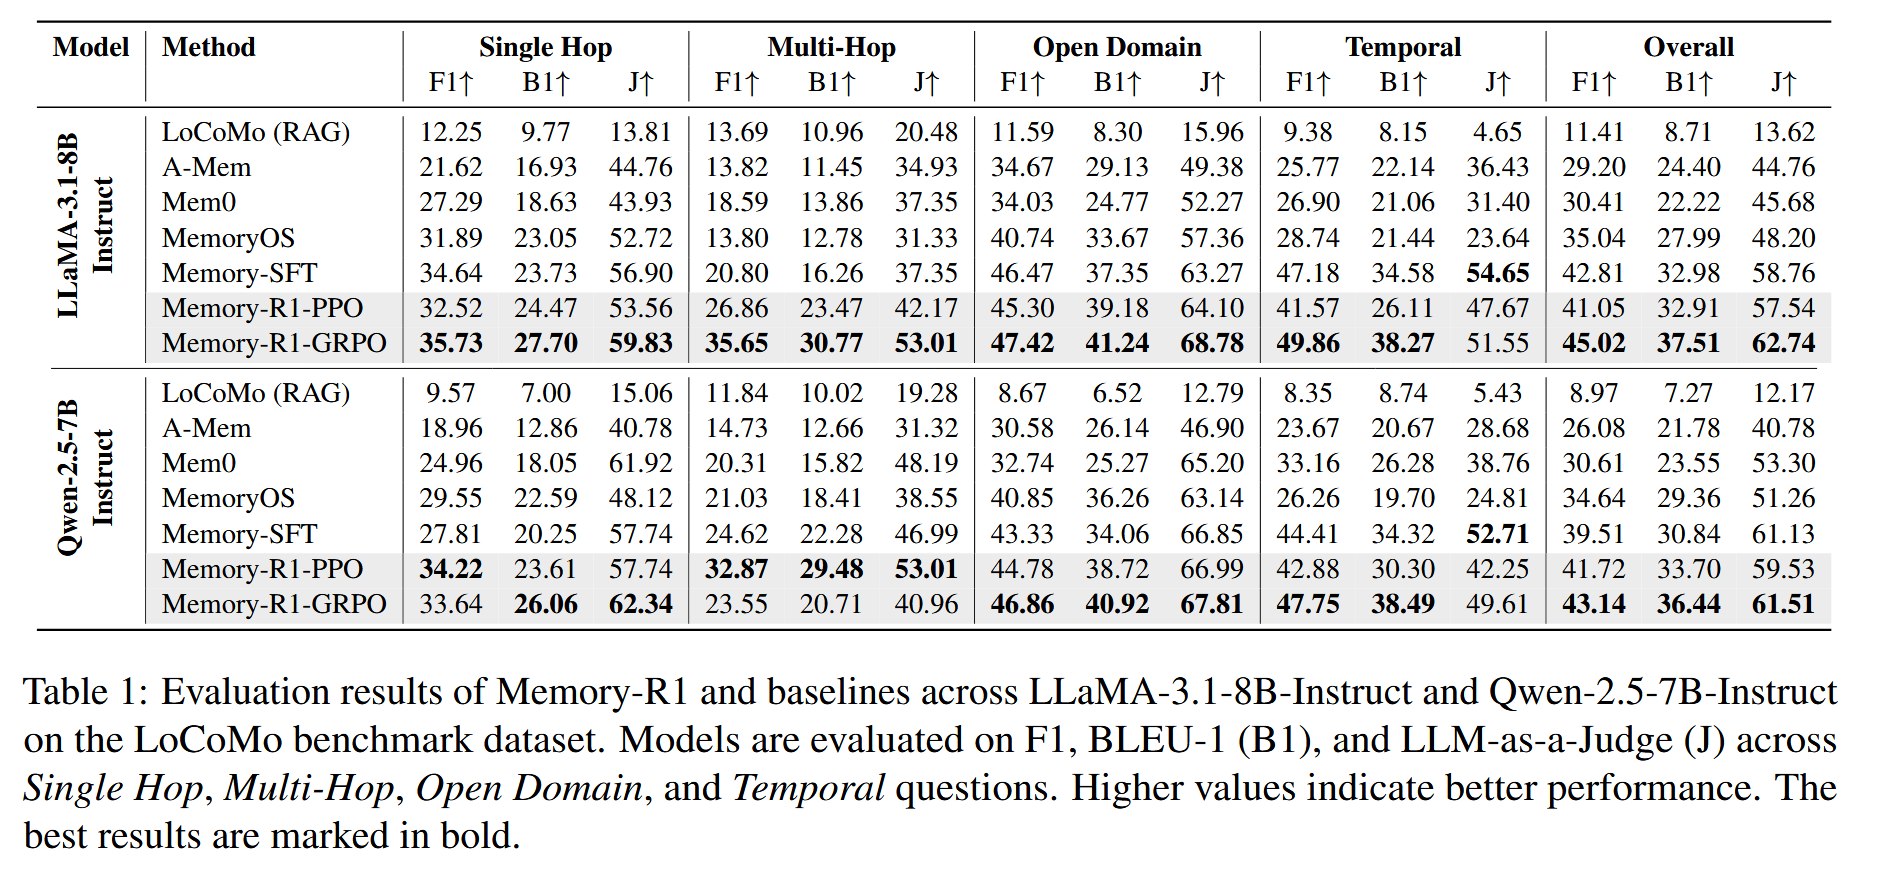
LLaMA-3.1-8B-Instruct Overall
- GRPO 是整体最强。值得注意的是,Memory-SFT 在 LLaMA 上略高于 PPO,说明“使用 RL”本身不保证一定胜过强 teacher imitation;论文的主要优势集中在 GRPO。
Qwen-2.5-7B-Instruct Overall
- GRPO 的 F1/B1 最好,J 只略高于 Memory-SFT。分题型看也不是 GRPO 全面领先:例如 Qwen 的 multi-hop 上 PPO 高于 GRPO。这说明 group-relative learning 的优势具有任务依赖性。
4.3 PPO 和 GRPO 应怎样比较?
论文观察到:
- GRPO 初期收敛更快,可能因为组内 reward normalization 提供更明确的相对信号;
- PPO 和 GRPO 后期训练 reward 接近;
- 最终 benchmark 上,GRPO 整体更好,尤其面对多条噪声 memory 时;
- PPO 需要 critic,训练结构和显存开销更复杂;
- GRPO 不需要 value model,但需要对同一输入采样一组候选,rollout 成本仍然不低。
因此不能简单说 GRPO 更省算力。更准确地说:
GRPO 省去了 critic 的参数和训练,但用 group sampling 换取相对优势估计。
4.4 泛化与模型规模
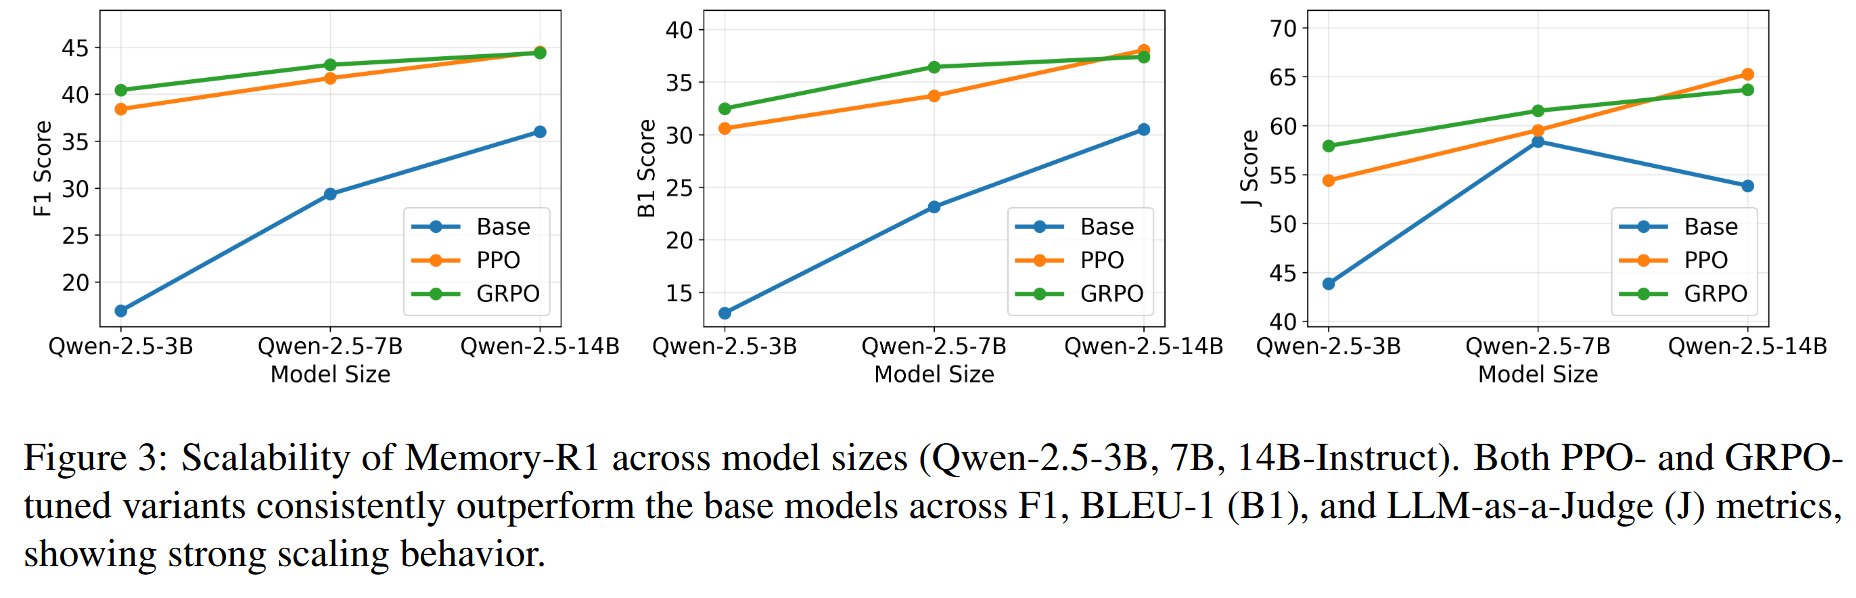
论文只在 LoCoMo 训练,然后直接在 MSC 和 LongMemEval 上零样本评测。PPO/GRPO 在两个 backbone 上均保持提升。
Qwen-2.5 的 3B、7B、14B 实验也显示 RL variant 通常优于对应 base,说明 memory policy learning 不只在某一个规模有效。
不过,所谓 zero-shot generalization 仍发生在长期对话和记忆 QA 相关 benchmark 内,不能直接推出它对 Web Agent、软件 Agent 或开放环境同样有效。
4.5 LongMemEval 总体结果
| Backbone | Method | Overall F1 | Overall B1 | Overall J |
|---|---|---|---|---|
| LLaMA-3.1-8B | Memory-SFT | 43.89 | 36.72 | 54.80 |
| LLaMA-3.1-8B | Memory-R1-PPO | 43.60 | 39.50 | 55.20 |
| LLaMA-3.1-8B | Memory-R1-GRPO | 45.20 | 39.30 | 55.40 |
| Qwen-2.5-7B | Memory-SFT | 43.16 | 35.04 | 54.80 |
| Qwen-2.5-7B | Memory-R1-PPO | 40.30 | 35.50 | 47.40 |
| Qwen-2.5-7B | Memory-R1-GRPO | 46.70 | 41.10 | 57.80 |
Qwen PPO 在 LongMemEval 上明显弱于 Memory-SFT,进一步说明 PPO 的稳定性和 reward optimization 可能依赖 backbone 与任务。GRPO 的跨数据集表现更稳。
4.6 消融实验
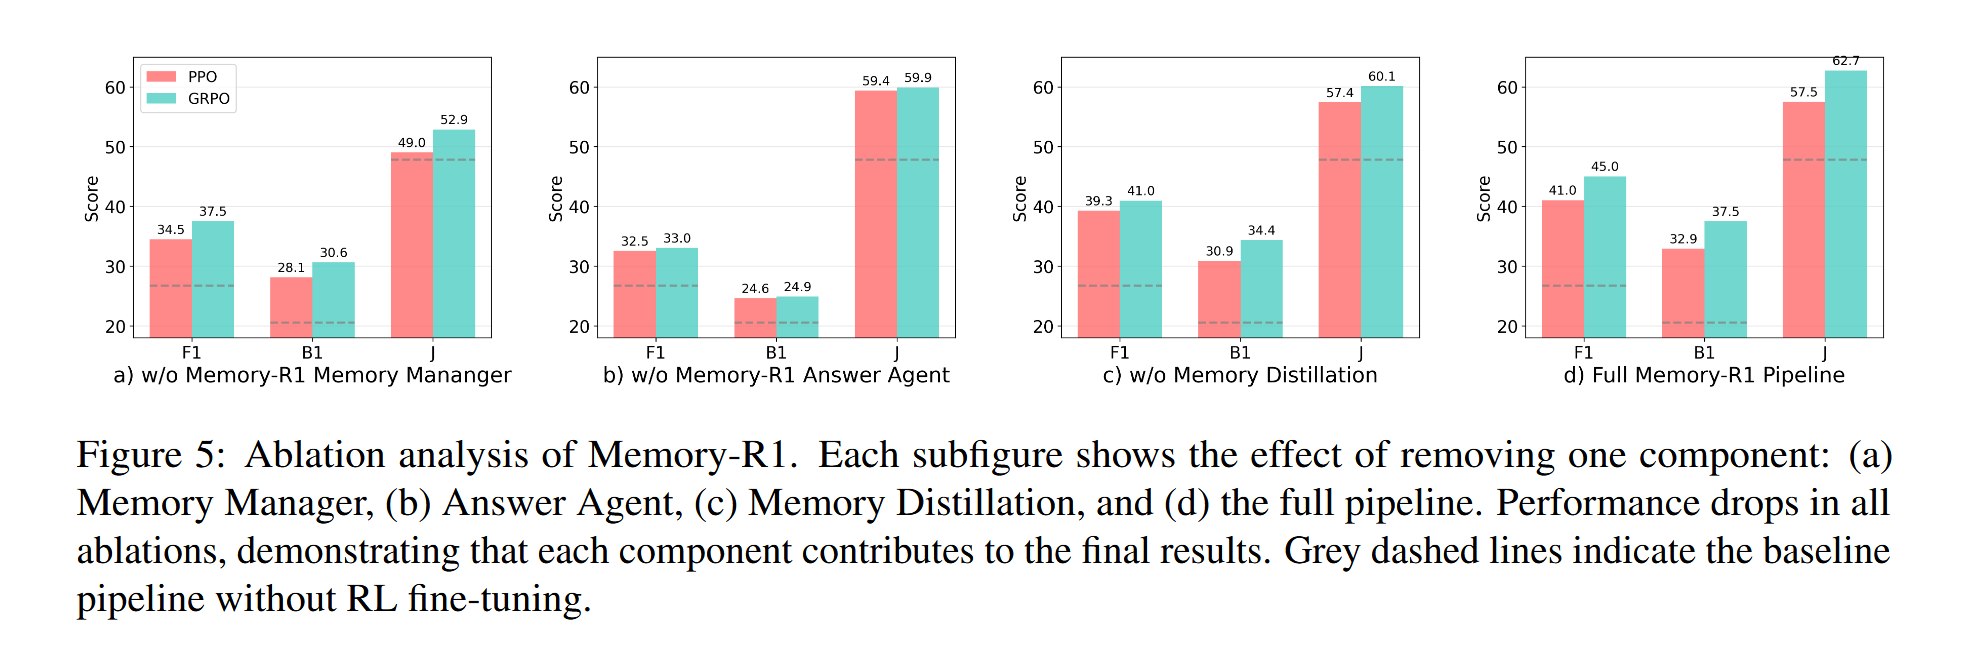
4.6.1 去掉 RL Memory Manager
LLaMA-3.1-8B 上:
- PPO:
41.0/32.9/57.5 → 34.5/28.1/49.0; - GRPO:
45.0/37.5/62.7 → 37.5/30.6/52.9。
说明 learned memory operation 对最终表现有明显贡献。
4.6.2 去掉 RL Answer Agent
- PPO:
41.0/32.9/57.5 → 32.5/24.6/59.4; - GRPO:
45.0/37.5/62.7 → 33.0/24.9/59.9。
F1/B1 显著下降,但 J 的变化并不完全同向,反映不同回答长度和风格会影响指标。
4.6.3 去掉 Memory Distillation
- PPO:
39.3/30.9/57.4 → 41.0/32.9/57.5; - GRPO:
41.0/34.4/60.1 → 45.0/37.5/62.7。
GRPO 从 distillation 中获益更明显,支持“组内比较有助于从噪声候选中学习选择”的解释。
4.6.4 更强的 Manager 是否帮助 Answer Agent?
把 LLaMA manager 换成 GPT-4o-mini manager 后,Answer Agent 的增益更大:
- F1:
+10.10 → +19.72; - B1:
+10.81 → +18.19; - J:
+5.05 → +15.76。
这说明两个模块存在乘法效应:上游 memory bank 越可靠,下游 learned reader 越能发挥作用。但这也提示主结果的一部分上限受 Memory Manager 质量控制。
4.7 Reward 设计分析
论文比较 Answer Agent 的两种 PPO reward:
| Reward | F1 | B1 | J |
|---|---|---|---|
| LLM Judge reward | 33.69 | 23.36 | 63.58 |
| EM reward | 41.05 | 32.91 | 57.54 |
Judge reward 会鼓励更详细、解释性更强的答案。例如 gold 是 Yes,模型可能输出一整句正确解释。Judge 喜欢这种回答,但 F1/BLEU 会因为长度不匹配而下降。
论文最终采用 EM,主要为了与 benchmark 的短答案形式对齐,并在三个指标之间取得更均衡结果。
这揭示了 RL 的一个基本问题:
模型会优化你给的 reward,而不是你心中没有写出来的“真正目标”。
4.8 Learned Distillation 与 Reranker
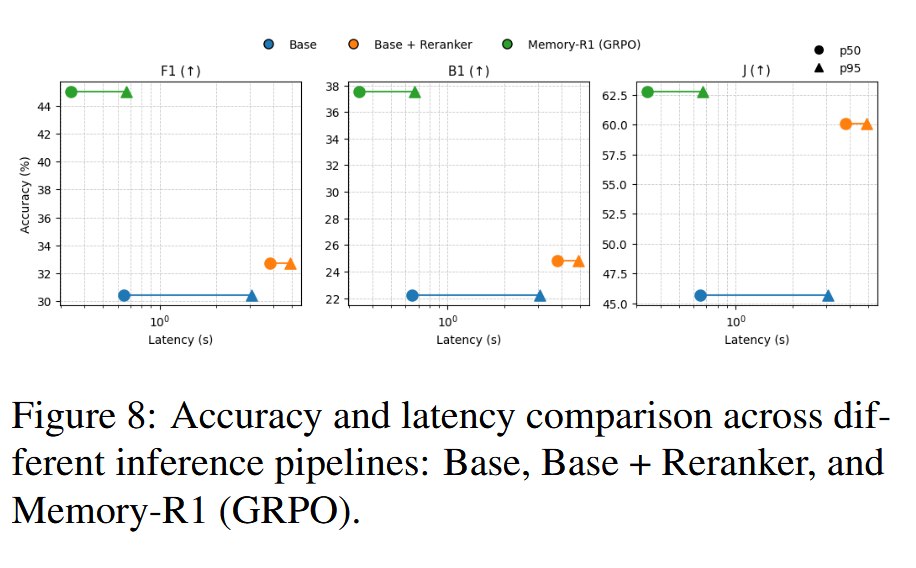
选出top-k后,直接给model / reranker 后给model / 利用model训练的能力
论文比较:
Base
Base + Reranker
Memory-R1 GRPO Answer Agent
reranker 能带来一定准确率提升,但增加推理 latency。Memory-R1 声称 learned distillation 在准确率和 p50/p95 latency 上形成更好折中。
4.9 延迟分析
- Memory Manager 在不同 base/PPO/GRPO 之间延迟相近;
- LLaMA manager median 约
1.98–2.17s,p95 约3.4–3.6s; - Qwen-7B manager p50 低于
1.4s; - Memory search median 低于
0.35s,p95 低于0.65s; - 部分 GRPO variant 的 tail latency 低于 base/PPO,可能因为回答策略更简洁。
五、总结
5.1 贡献
它最有代表性的贡献不是提出新的 memory schema,而是明确完成了以下转变:
从“用 prompt 规定 memory manager 应该怎么做”,转向“用下游任务结果学习 memory manager 应该怎么做”。
同时,它认识到 Agent Memory 不是只有写入侧:检索出的 60 条候选还需要 learned reader 去蒸馏和使用。
5.2 局限
Memory-R1 仍然没有充分解决:
- 局部操作的细粒度 credit assignment;
- 无 gold answer 场景中的 reward;
- 跨用户、持续多月的在线学习;
- 矛盾 belief 的置信度和证据追踪;
- 错误删除后的恢复;
- LTM 与 active context 的统一管理;
- 多模态或工具轨迹记忆。
说些什么吧!