
零、写在前面
RL 理论确实不太熟,memory RL 的工作看的并不多,之前的 memgen 是构造了一些 expert trajectory,那么他的奖励是很粗糙的,只看了这次轨迹。
attrimem 这个动机就是,现在那么多 RL 做 memory 的工作都忽略了一点:真正起到作用的是哪些 memory?也就是说,一段文本,你用到的信息可能就一小段。但你现在的 RL 方法都做的比较粗糙,一般都是看单次 policy 的奖励。
所以这个工作就做了 Token 级归因生成细粒度过程奖励,试图解决 Agent 记忆 RL 训练信用分配瓶颈。
但这个训练成本感觉太高了,8卡 H800 训30h + 5天,还需要很强的第三方 model 的API,大家很难 follow,目前暂时还没看到这个工作开源。
其次这个推理成本感觉也不低,跟 mem0 一样了,curd 都得让 llm 决策。
不过好的一点是,这个方法不需要什么 expert trajectory,也不需要人工标注,通过 contextcite 的方法,利用 token 的预测概率就可以做 reward,效果还不错。
这个工作其实是把 contextcite 的理念拿来做 meomory-construction RL了。
半个月前也发现 memgen 其实就是训练 experimential memory 做 softCot。
感觉思维还是得发散一下,多了解了解相关领域的工作,而不是局限于单个领域。
一、标题
作者团队来自 ZJU OmniAI Lab
还没开源
AttriMem 是 Attribution-Guided Process Feedback for Agent Memory Construction :
- Attribution-guided(归因引导):通过反事实遮蔽,估计一段记忆中的每个 token 对最终答案有多大贡献。
- Process feedback(过程反馈):不只在最后说“这题答对了或答错了”,还在中间告诉 memory manager:“你刚写的这几个词有帮助,那几个词无帮助甚至有害。”
- Memory construction(记忆构建):训练目标是“怎样抽取、更新、压缩、合并、保留记忆”,不是训练回答问题的 LLM。
按照《Memory in the Age of AI Agents: A Survey》的 Forms / Functions / Dynamics 框架:
- Form(形式):主要是外部 token-level memory(文本级记忆)。核心、情景、语义、程序记忆均为文本记录;训练后的 policy 参数可视作辅助 parametric knowledge,但不是论文主张的在线记忆本体。
- Function(功能):同时覆盖 factual / semantic memory、episodic memory、procedural memory,另有固定容量的用户 profile。
- Dynamics(动态):本文重点。它训练 Agent 做 extraction、compression、update、merge、retention;归因奖励服务于“怎样写、改、压缩、删”这一生命周期。
二、摘要
2.1 问题
长期对话中的信息散落在许多 session,且混入大量无关细节。一个 **memory-construction policy(记忆构建策略)**必须持续决定:这一轮抽取什么、已有记录该更新还是合并、哪些应压缩、哪些应保留或丢弃。
现有两类方法各有缺陷:
- Heuristic memory(启发式记忆):人工写规则,主观且任务耦合,容易“看起来重要”却对最终任务无用。
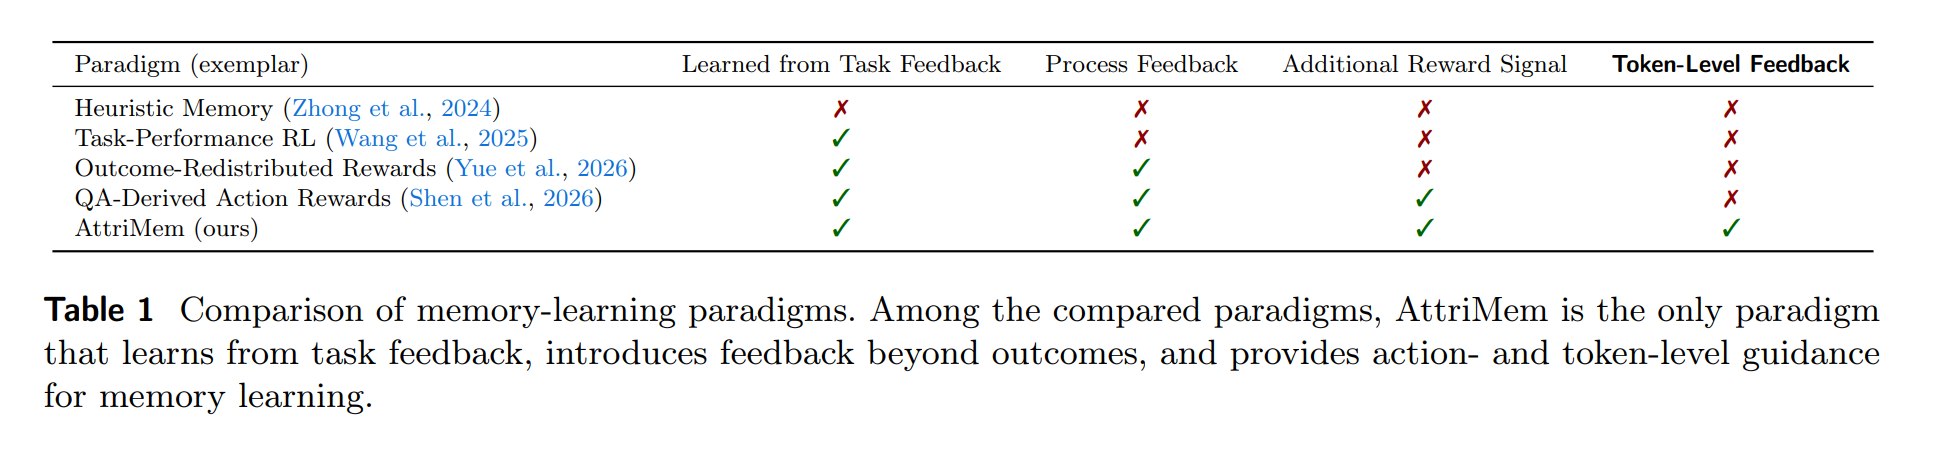
- RL-based memory learning(基于 RL 的记忆学习):用最终问答是否成功作奖励,目标更对齐,但中间记忆操作只有一个很晚、很粗的分数,出现 credit assignment(信用分配)问题。
例如,十次 session 后才回答一个问题。答案答对时,普通 outcome-only RL 会把正奖励广播给全部十次记忆操作的所有 token;它不知道真正有用的是“7:15 AM”“三个月”“20 个瓶子”,还是一长段无关的个人背景。
2.2 AttriMem 的答案
AttriMem 保留全局最终问答奖励,同时新增局部 token 过程奖励:
- memory agent 先按 session 构建结构化文本记忆;
- 固定 retriever 和固定 answer model 从记忆中回答最终问题;
- 固定生成的答案不变,对记忆 token 进行随机遮蔽;
- 观察遮蔽后答案概率如何变化;
- 将每个 token 的贡献映射回产生它的记忆操作,作为 RL 的 token-level reward。
这等于把“这份档案有用”进一步拆成“档案中的哪个词、哪条数值、哪段时间线帮助了答案”。
然后摘要这里卖了一下贡献:
- 将最终问答表现转换为 token 级过程反馈,缓解长程记忆构建中的奖励稀疏。
- 比 outcome-only reward 和 action-level reward(整条操作奖励)更细地指导 memory policy。
- 在 LoCoMo、LongMemEval、PerLTQA 上取得更好准确率,并报告更好的中间记忆质量与更稳定的 RL 曲线。
三、引言
3.1 核心问题

RAG 类方法常假设历史原文仍在,只需在查询时找到相关段落。AttriMem 的问题更靠前一步:
当每轮对话都很长、不能永久保存原文时,memory manager 应把哪些信息压缩成长期档案?
它和 Mem0、MemoryOS、MemBuilder 一样属于 memory manager 问题。不同在于,AttriMem 的核心贡献不是新的存储格式,而是如何训练这个 manager。
3.2 现有 RL 方案的粗粒度奖励
引言里面引用了几篇 RL 做 memory 的论文,mark一下,回头看一下方案。
基本都是一些粗粒度的奖励方案。
假设某条 memory action 写出:
用户每天 7:15 坐公交,已持续三个月;提前一站下车步行十分钟;两月读完三本有声书……
最终问题只问“用户坐这趟车多久了”。如果回答正确,**普通 GRPO 会把相同的正 advantage 给上述所有 token;真正关键的“三个月”得不到特别强化,无关信息也搭了正奖励便车。**由此出现四个后果:
- 关键数值、时间、实体、关系得不到精准强化;
- 一条整体正确、局部有错的 action 无法局部纠正;
- 回答偶然正确时,中间错误操作也会被奖励;
- 长程探索的学习信号噪声很大。
AttriMem 的切口是:不要给整条 action 一把同样的分,而是尝试给内部 token 分别记账。
3.3 ContextCite => memory-construction RL
他这个工作的角度 token attribution 早在 2024 年的 ContextCite 就提出了,所以本文其实是把 context attribution 接入 memory-construction RL:
最终答案质量
  -> 反事实估计记忆 token 对该答案的贡献
  -> token 级过程奖励
  -> 用 GRPO 更新写记忆的 policy
这里最终答案既是任务结果,也是给中间 memory process 分配信用的锚点。
四、相关工作
4.1 RAG 与启发式 Memory Manager
RAG-Session、RAG-Utterance 直接从 session 或 utterance 原文检索。Mem0、MIRIX、MemoryOS、A-Mem、LightMem、GAM 等会用规则、提示词或打分机制决定记什么、何时压缩和更新。
这类方法优点是无需昂贵 RL;缺点是规则编码了设计者对“重要”的猜测,而非直接由下游 QA 目标校正。AttriMem 的立场是:记忆是否好,应由后续回答效用来评判。
4.2 基于结果奖励的 Memory RL
Memory-R1 一类方法以任务成功为回报。Mem-T 在采样的 memory-action tree 中把叶节点结果奖励回传给祖先 action。
作者的批评是:这虽然把奖励扩散到了中间步骤,但本质仍是最终结果的重新分发,并没有告诉模型“一个 action 内部哪些内容值得信用”。
4.3 QA-derived action rewards:最直接的前作 MemBuilder
MemBuilder 会合成辅助 QA,观察某次记忆 action 产生的内容是否被检索并帮助回答,再形成 action-level reward。它已经比只看最终答案更密。
| 方法 | memory action 获得的反馈 | 能否区分 action 内部 token |
|---|---|---|
| Outcome-only RL | 整条轨迹一个结果奖励 | 否 |
| Mem-T | 将叶节点结果回传到中间 action | 否,本质仍是结果重分配 |
| MemBuilder | 基于辅助 QA 的 action-level reward | 否,整条 action 共用一个分数 |
| AttriMem | 最终答案条件下的 attribution reward | 是,token 可有不同正负分数 |
AttriMem 和 MemBuilder 的受控比较很关键:两者匹配 Qwen3-4B、memory architecture、SFT 初始化、GRPO 优化预算、检索回答接口、解码和评测协议;论文刻意保留的主要差异是 RL reward。
4.4 Process reward 与 Attribution
在长程推理、Agent 轨迹和多 Agent 优化中,研究者都在尝试把结果奖励拆成过程奖励。AttriMem 的具体位置是:它不让 critic 用语言事后评价“这步好不好”,而是固定最终答案,用反事实遮蔽得到answer-conditioned token attribution(以最终答案为条件的 token 归因),并将系数直接转成记忆生成 token 的奖励。
五、Preliminaries
5.1 问题设置
给定 $T$ 个历史对话 session:
$$ H=\{h_t\}_{t=1}^{T}, $$在所有 session 结束后才出现问题 $q$。目标是基于分散在完整历史中的信息回答问题。
系统被刻意拆为两部分:
- Memory agent(记忆 Agent):每轮看到当前 session $h_t$ 与旧记忆 $M_{t-1}$,选择 $a_t^{mem}$ 并更新记忆。
- Retriever + answer model(检索器和回答模型):最终看到问题 $q$ 后,从 $M_T$ 取回记录,生成答案 $\hat y$。
一个非常重要的设定是:构建阶段 memory agent 看不到未来问题 $q$。它必须像真实长期助手一样边聊天边维护可复用档案;问题只在后面出现。
5.2 四类结构化记忆
沿用 MemBuilder 式架构,论文使用同一个 LLM,配合不同 prompt 和动作空间管理四个模块:
| 模块 | 含义 | 例子 |
|---|---|---|
| $M_{core}$ | Core memory(固定大小用户画像) | 身份、偏好、关系 |
| $M_{epi}$ | Episodic memory(带时间的事件) | 某天丢公交卡、何时开始通勤 |
| $M_{sem}$ | Semantic memory(用户实体事实) | 就读专业、常用工具、地点关联 |
| $M_{proc}$ | Procedural memory(步骤或工作流) | 如何完成一项固定任务 |
每类可执行 ADD、UPDATE、MERGE 等动作。
四模块不是 AttriMem 新提出的结构;AttriMem 接受并沿用它,主要改进训练信号。
5.3 SFT warm start 与 GRPO
**SFT warm start(监督微调热启动)**先用 expert 或 teacher trajectory 教会 memory policy 合法动作格式和基本写法。否则 RL 从乱写记忆开始探索,成本高且不稳定。
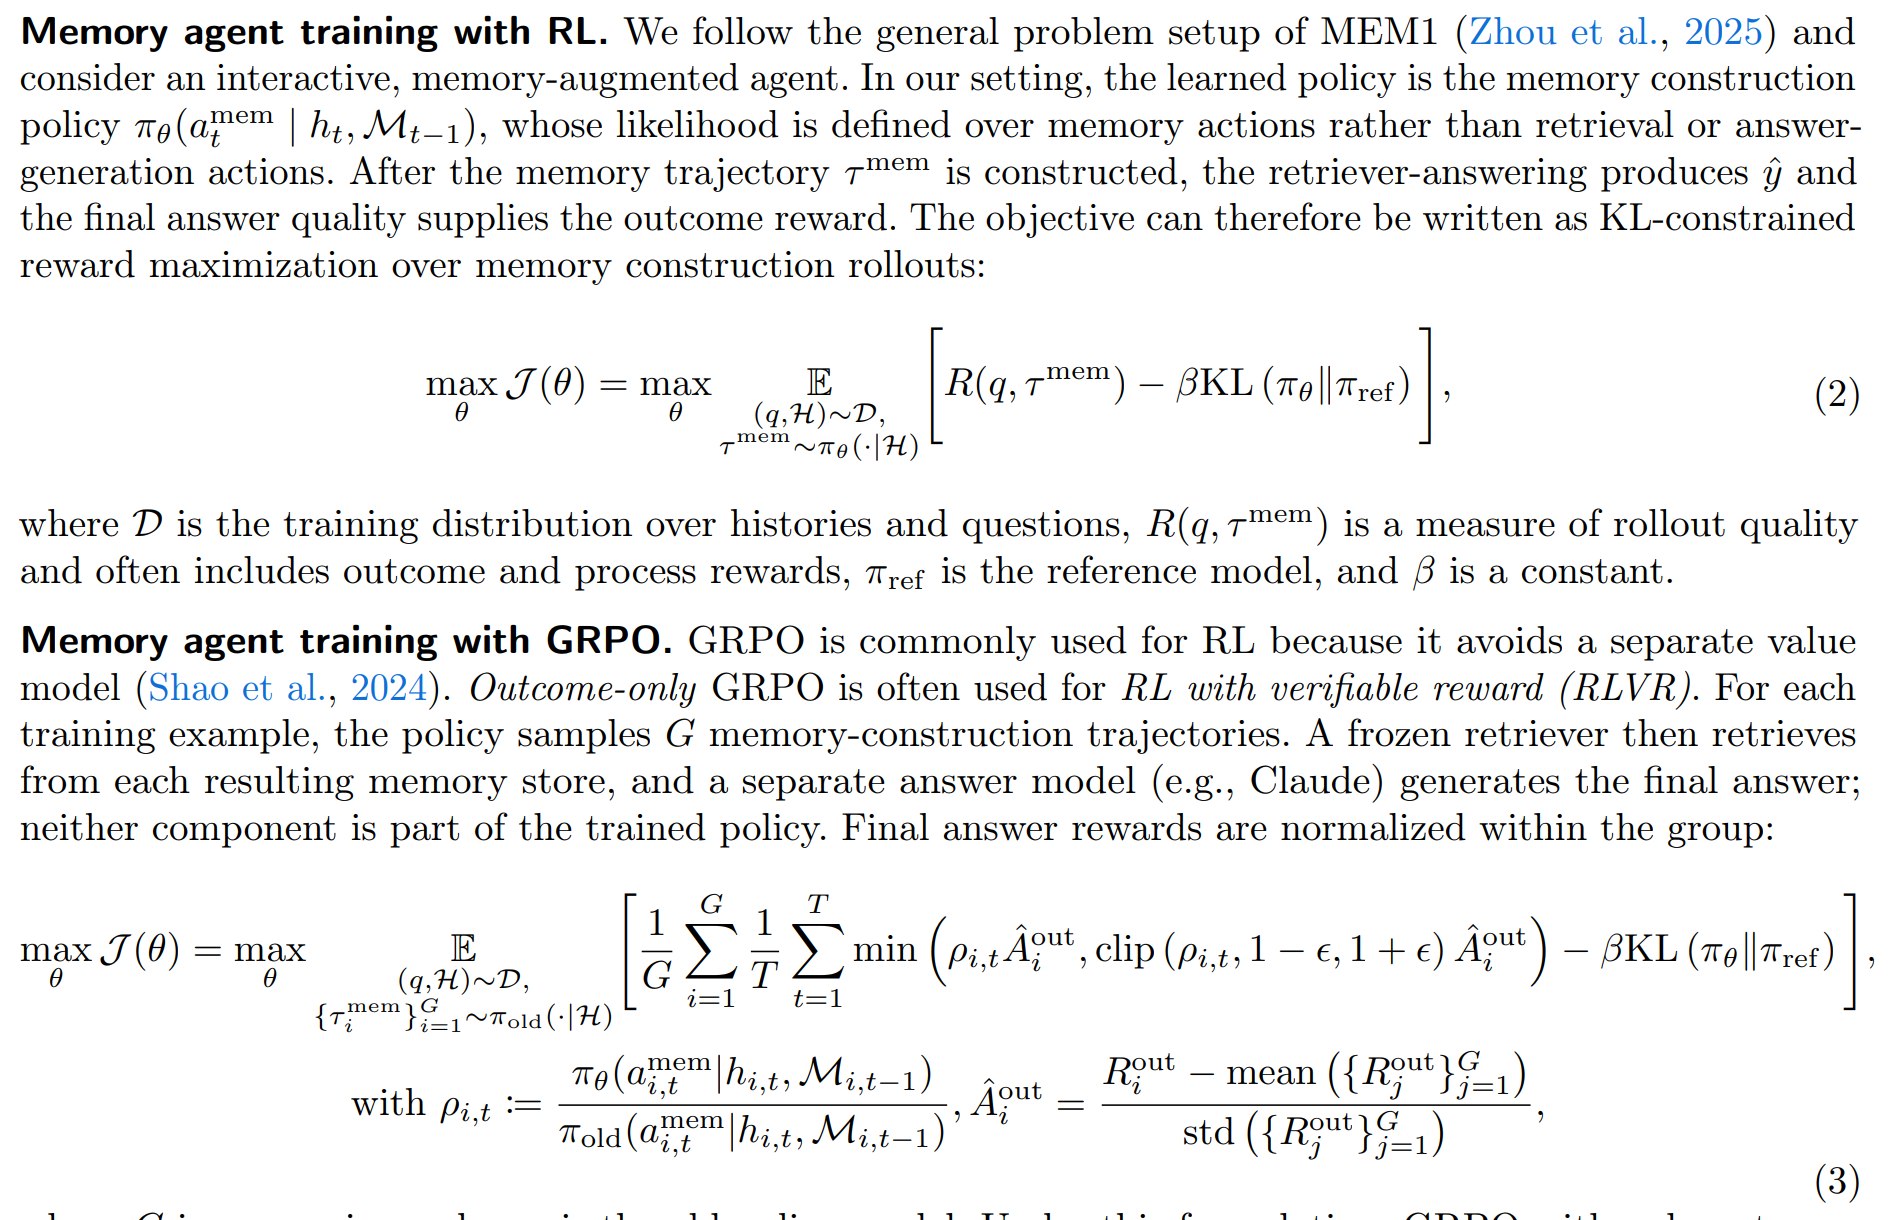
之后使用 GRPO(Group Relative Policy Optimization):对同一历史和问题采样 $G$ 条记忆构建轨迹;每条轨迹都被固定检索器和 answer model 评估;最终问答奖励在组内标准化为相对优势;同时加 KL 项,避免 policy 一次偏离 reference policy 太远。
普通 outcome-only GRPO 会把一条轨迹的最终优势广播给该轨迹全部 memory action token。这正是本文要补的缺口。
5.4 Context attribution:从“删掉它会怎样”测贡献
把记忆上下文切为来源 $Z=\{z_i\}$。一个来源对最终回答 $y$ 的贡献直觉为:
$$ \mathcal A(z_i,y;c)\approx F(y\mid c)-F(y\mid c\setminus z_i), $$其中 $c$ 为完整记忆上下文,$F$ 是回答模型对固定答案 $y$ 的打分。正值代表“保留它会提高答案分数”,负值代表“保留它反而拉低分数”。AttriMem 把一个记忆输出 token当作来源 $z_i$。
六、方法
6.1 overview
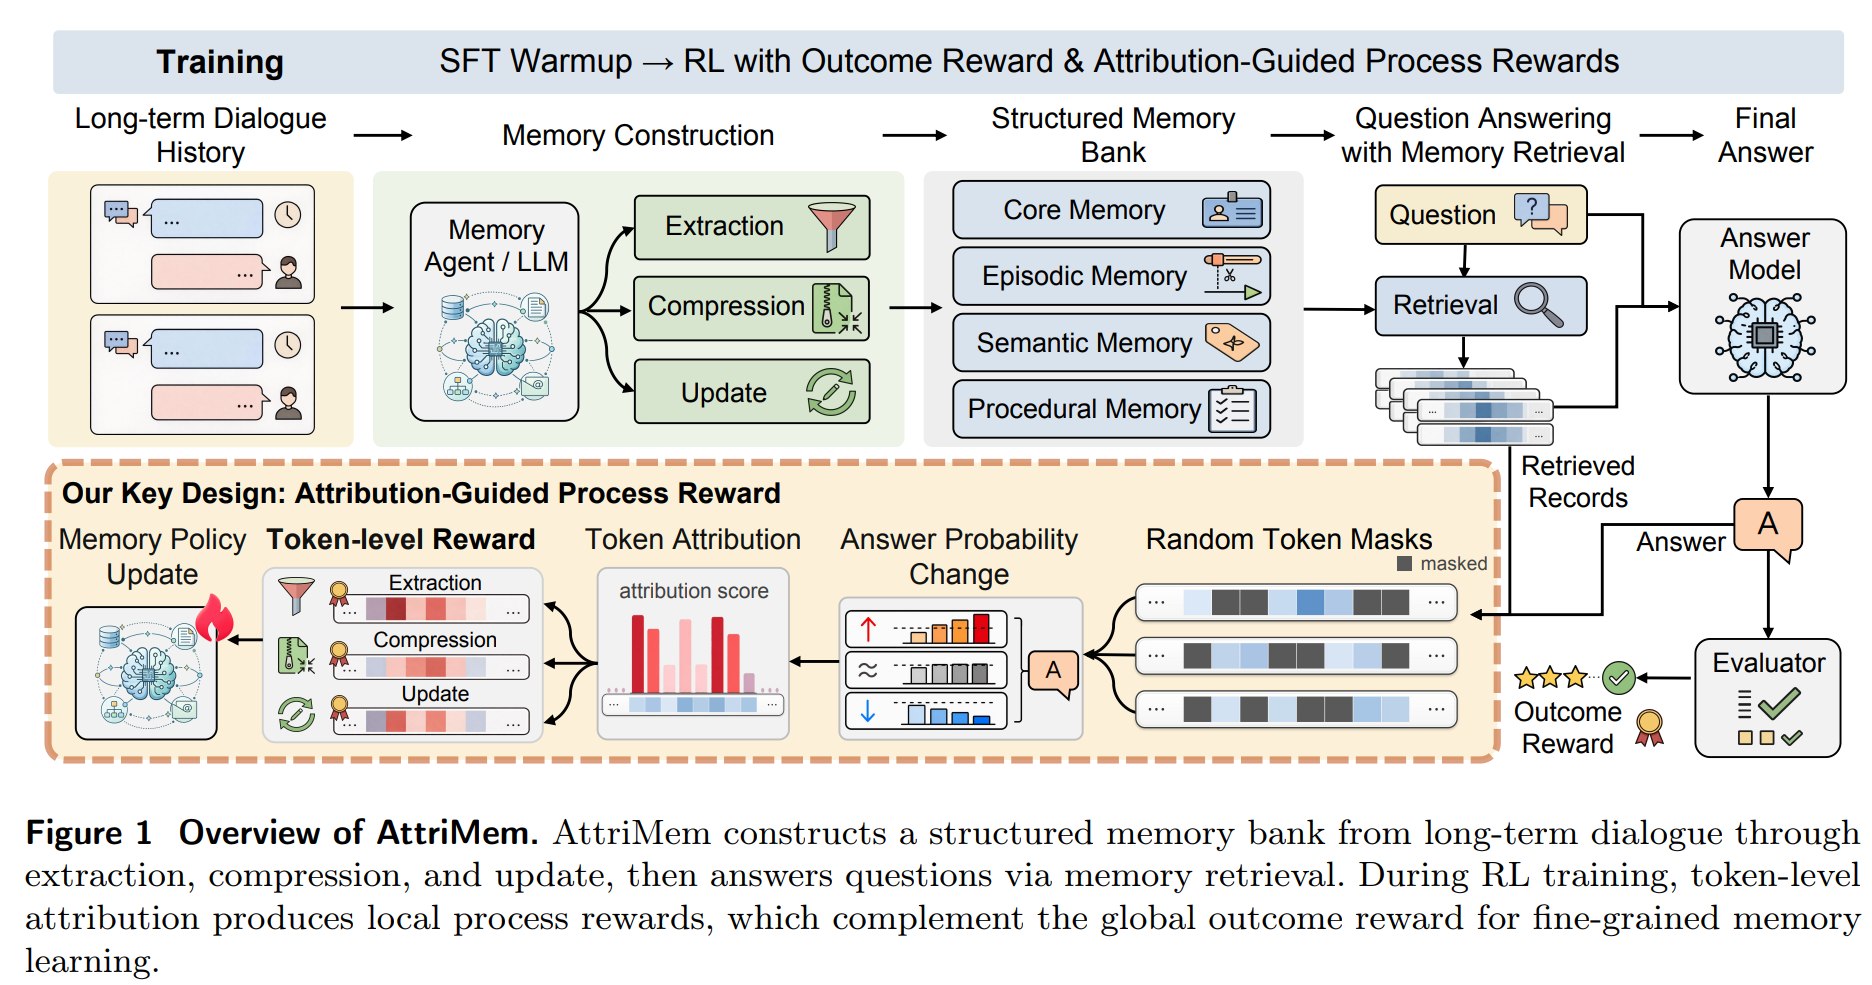
完整训练管线:
长期对话 H
  -> memory policy 逐 session 做抽取、压缩、更新、合并
  -> 结构化文本 Memory Bank M_T
  -> 固定 Retriever 从 M_T 检索
  -> 固定 Answer Model 回答 q,得到 y_hat
  -> Outcome reward:答案整体是否好
  -> ContextCite:遮蔽不同记忆 token,估计其对固定 y_hat 的贡献
  -> Token process rewards
  -> GRPO 更新 memory policy
AttriMem 只训练第一段 memory policy;retriever 与 answer model 是产生学习反馈的固定环境组件。
6.2 Memory construction 的基本形式
每个 session 的记忆更新写为:
$$ M_t=U(M_{t-1},h_t,a_t^{mem}), \tag{5} $$其中 $U$ 是更新操作,$a_t^{mem}$ 是 policy 生成的动作及其文本输出。处理所有 session 后,固定接口回答:
$$ \hat y=G(q,\operatorname{Ret}(q,M_T)). \tag{6} $$学习目标不是直接优化回答模型 $G$,而是让生成 $\{a_t^{mem}\}$ 的策略将 $M_T$ 写得更完整、少噪声、易检索。
6.3 一个 token 有两种奖励来源
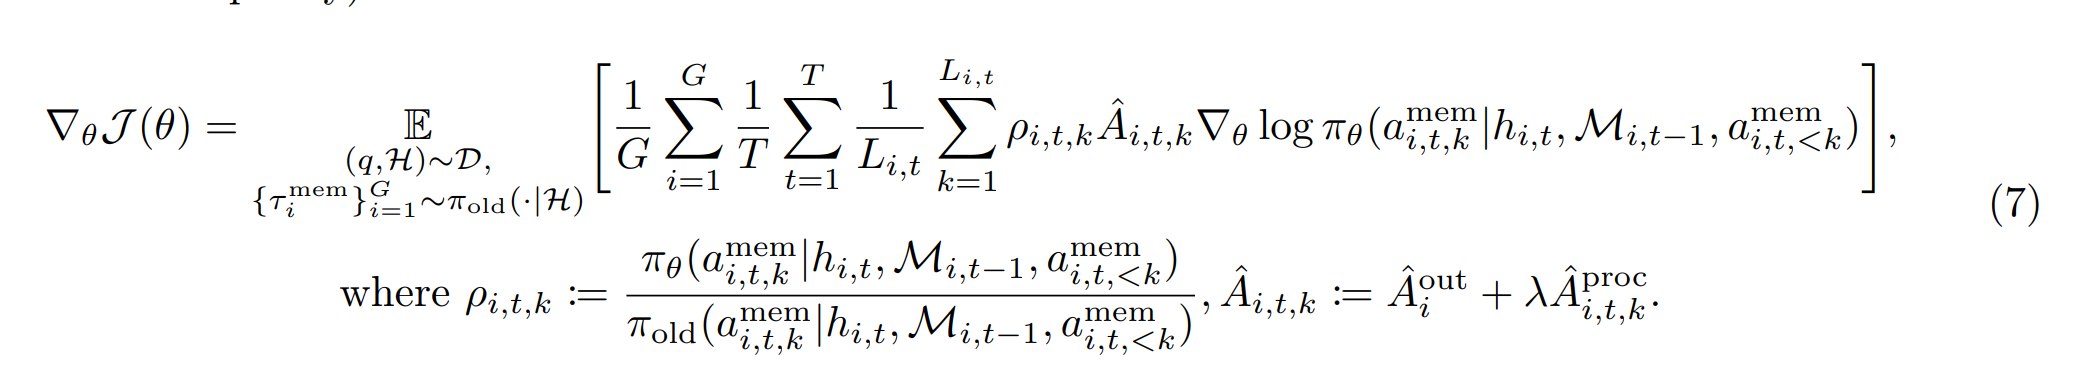
这个式子是忽略 KL 散度后的梯度
第 $i$ 条 rollout、第 $t$ 个 action 的第 $k$ 个生成 token,使用:
$$ \hat A_{i,t,k}=\hat A_i^{out}+\lambda\hat A_{i,t,k}^{proc}. \tag{7} $$- $\hat A_i^{out}$:该 rollout 相对同组其他 rollout 的最终问答优势,回答“整份记忆总体有用吗”。
- $\hat A_{i,t,k}^{proc}$:token 级过程优势,由归因奖励转换而来,回答“这个 token 有帮助吗”。
- $\lambda$:局部过程信号的权重。
GRPO 的概率比、clip、KL 仍照常工作;变化在于每个 token 所乘 advantage 从统一的结果分数,变成“全局结果加局部贡献”。
一个例子:若最终答案正确,$\hat A^{out}$ 为正,整条轨迹整体被鼓励;但“3 books / month”若破坏正确事实“3 books / 2 months”,其局部归因可更低甚至为负。因此策略不再把所有 token 无差别强化。
6.4 ContextCite 如何变成 token reward
这是整篇论文的技术核心。
6.4.1 ContextCite 到底在测什么?
AttriMem 的核心问题是:
如果从最终用于回答的 memory context 中去掉某个由 policy 生成的 token,Answer Model 对当前答案的信心会怎样变化?
其实这就说明训练比较依赖一个比较强的 answer model 了。
抽象地写:
$$ \mathcal A(z_j,\hat y;c) \approx F(\hat y\mid c) - F(\hat y\mid c\setminus z_j), \tag{4} $$其中:
- $c$:完整的 attribution context,即构建后、供 answer model 使用的文本 memory context;
- $z_j$:一个由 memory action 产生的 token source;
- $\hat y$:完整 context 下已经生成的答案;
- $F$:Answer Model 对固定答案 $\hat y$ 的评分;
- $\phi$:该 token 对答案的贡献估计。
直接逐 token 删除并重新跑一次 Answer Model 成本太高,而且 token 之间有组合效应。因此论文采用 ContextCite 的随机遮蔽加稀疏线性代理。
6.4.2 ContextCite 的七个具体步骤
步骤 1:固定一次完整答案
先用完整 memory context 生成:
$$ \hat y=(\hat y_1,\ldots,\hat y_L). $$之后所有 ablation 都不重新采样新答案,而是评价 Answer Model 对这个同一个 $\hat y$ 的概率。
为什么要固定答案?
如果每次删掉 token 后重新生成,可能得到风格和长度完全不同的答案,难以判断变化来自 memory token,还是 sampling randomness。固定 $\hat y$ 后,问题变成:
删除某些 memory token 后,模型还愿不愿意输出原来这份答案?
步骤 2:把每个 action token 当成一个 Source
设 attribution context 为:
$$ c=(z_1,z_2,\ldots,z_d), $$每个 $z_j$ 对应 constructed textual memory context 中的一个 generated action-token position。
例如:
Andrew / has / two / dogs / Buddy / and / Scout
   z1     z2   z3    z4     z5     z6    z7
AttriMem 的粒度是 tokenizer token,不一定恰好对应自然语言单词。
步骤 3:随机生成二进制 Mask
每个 mask:
$$ v\in\{0,1\}^{d}, $$其中:
- $v_j=1$:保留 source $z_j$;
- $v_j=0$:移除 source $z_j$。
每个 source 以 1/2 概率独立保留。采样 $N$ 个 masks:
论文最大使用 32 个随机 masks,而不是对每个 token 单独做 leave-one-out。
步骤 4:构造被遮蔽的 Memory Context
根据 mask 得到:
$$ \operatorname{Ablate}(c,v^{(n)}). $$保留下来的 token 按原顺序组成 counterfactual memory context。所有 masks 可以组成一个 batch 并行前向。
步骤 5:Teacher Forcing 计算固定答案概率
对每个 mask,计算:
$$ f(v^{(n)}) := p_{\mathrm{ans}} \left( \hat y \mid q,\operatorname{Ablate}(c,v^{(n)}) \right), $$展开为:
$$ f(v^{(n)}) = \prod_{\ell=1}^{L} p_{\mathrm{ans}} \left( \hat y_\ell \mid q,\operatorname{Ablate}(c,v^{(n)}),\hat y_{<\ell} \right). \tag{9} $$这就是 teacher forcing:第 $\ell$ 步始终喂入固定答案的真实前缀 $\hat y_{<\ell}$,测模型对下一个固定 token 的概率。
步骤 6:把概率做 Logit 变换
论文使用:
$$ g(v^{(n)}) = \sigma^{-1}(f(v^{(n)})) = \log\frac{f(v^{(n)})}{1-f(v^{(n)})}. \tag{10} $$
原因是概率被限制在 [0,1],直接用线性模型拟合不方便;logit 将其映射到实数范围。
步骤 7:用 LASSO 拟合每个 Token 的贡献
ContextCite 用稀疏线性模型近似:
$$ \hat g(v)=b+w^\top v. $$通过 LASSO 求:
$$ (\hat b,\hat w) = \arg\min_{b,w} \frac{1}{2N} \sum_{n=1}^{N} \left( g(v^{(n)})-b-w^\top v^{(n)} \right)^2 + \alpha\lVert w\rVert_1. \tag{11} $$其中:
- $w_j$:保留第 $j$ 个 token 对固定答案得分的估计影响;
- $\alpha=0.01$:LASSO 稀疏正则;
- L1 正则隐含假设:真正强烈影响答案的 token 只占少数。
最终:
$$ \mathcal A(z_j,\hat y;c)=\hat w_j. \tag{12} $$解释如下:
- $\hat w_j>0$:保留这个 token 通常提高 Answer Model 对 \(\hat y\) 的信心;
- $\hat w_j<0$:保留它通常降低信心,可能是错误或干扰;
- $\hat w_j\approx0$:在当前问题和答案下贡献较小。
每个 source index j 与某个 rollout、某个 session、某个 action token 一一对应:
$$ z_j \longleftrightarrow a_{i,t,k}^{\mathrm{mem}}. $$因此论文直接使用 ContextCite coefficient 作为 process reward:
$$ r_{i,t,k}^{\mathrm{proc}} = \phi \left( a_{i,t,k}^{\mathrm{mem}}, \hat y_i; c_i \right) = \hat w_j. \tag{8/13} $$6.5 GRPO Advantage
论文对 token process reward $r_{i,t,k}^{\mathrm{proc}}$ 按 GRPO 方式估计过程 advantage:
$$ \hat A_{i,t,k}^{\mathrm{proc}} = \operatorname{GRPOAdvantage} \left(r_{i,t,k}^{\mathrm{proc}}\right). $$再与整条 trajectory 的 outcome advantage 相加:
$$ \hat A_{i,t,k} = \hat A_i^{\mathrm{out}} + \lambda \hat A_{i,t,k}^{\mathrm{proc}}. \tag{7} $$其中:
- $\hat A_i^{\mathrm{out}}$:第
i条 memory trajectory 的最终问答相对优势; - $\hat A_{i,t,k}^{\mathrm{proc}}$:该 action token 的归因过程优势;
- $\lambda$:控制局部 signal 权重。
它形成两个尺度的信用:
Outcome Advantage:这整套长期记忆构建方案最终好不好?
Process Advantage:这套方案中,这个具体 token 对答案有没有帮助?
二者可能出现不同组合:
| Outcome | Token attribution | 训练含义 |
|---|---|---|
| 正 | 正 | 整体成功且 token 有贡献,强烈鼓励 |
| 正 | 负 | 整体成功但 token 有害,避免让它搭便车 |
| 负 | 正 | 整体失败但 token 局部有用,避免全部抹杀 |
| 负 | 负 | 整体失败且 token 有害,强烈抑制 |
这就是 AttriMem 相比 outcome-only RL 的核心增量。
6.6 SFT Warm
AttriMem 不是直接从 Base Qwen 开始全部 RL。SFT 先用 expert/teacher trajectories 做 next-token prediction,让 Qwen 学会:
- 不同 memory module 的基本职责;
- 合法 action 和结构化输出格式;
- 如何根据 session 与旧 memory 生成合理更新;
- 避免 RL 初期大量无效、无法解析的探索。
SFT 可以抽象为:
$$ \mathcal L_{\mathrm{SFT}} = - \sum_{t,k} \log \pi_\theta \left(a_{t,k}^{\mathrm{mem},*} \mid h_t,M_{t-1},a_{t,\lt k}^{\mathrm{mem},*} \right). $$注意:论文只说明沿用 expert/teacher-generated memory trajectories 的 SFT warm start,并未在正文中完整公开 teacher 数据生成的全部细节。
6.7 训练配置
| 项目 | 配置 |
|---|---|
| Memory policy | Qwen3-4B |
| SFT | 3,000 steps,10 epochs |
| SFT batch size | 32 |
| SFT learning rate | $5\times10^{-7}$ |
| RL | GRPO 400 steps |
| GRPO effective batch size | 256 |
| GRPO group size | 8 |
| RL learning rate | $1\times10^{-6}$ |
| 最大序列长度 | 6,000 |
| Attribution masks | RL step 0/80/200 时累计提高到 8/16/32 |
| LASSO \(\alpha\) | 0.01 |
| 硬件 | 8 × NVIDIA H800 80GB |
| 作者报告时间 | SFT 约 30 小时;RL 约 5 天 |
粗略换算约为:
$$ 8\times30+8\times120 \approx1200 $$H800 GPU-hours。成本主要来自:
- 每个样本需要 group rollout;
- 每条 rollout 要完整构建长期 memory;
- 要运行 Retriever 和 Answer Model;
- 每个答案还要评估最多 32 个 masked contexts;
- 最后拟合 attribution surrogate。
论文说 masks 可以 batch 并行,因此 wall-clock overhead 接近一次 batched forward;但这不等于 FLOPs 或 API token 成本只有一次普通 forward。
6.8 一些疑问
1、Attribution 解释的是“支持当前答案”,不一定是“事实正确”
ContextCite 固定的是模型已经生成的 $\hat y$。若 $\hat y$ 本身错误,某些 token 仍可能因为支持这个错误答案而得到正 attribution。Outcome reward 可以部分抑制这种现象,但不能从机制上完全消除。
2、线性 LASSO 不能完整表示 Token Interaction
not 与 allergic、数字与单位、人物与关系词经常需要组合后才有意义。线性 surrogate 将贡献近似分配给各 token,可能误估复杂交互。
3、只有少量 Masks,却有大量 Token Sources
最长序列可达 6,000,而 masks 最多 32。方法依赖强稀疏假设:只有少数 token 真正影响答案。若重要证据分散、交互复杂,估计可能不稳定。
4、训练问题分布会决定“什么值得记”
构建 policy 看不到未来问题,但 RL reward 来自 LongMemEval 的未来问题。policy 学到的是“对这类 benchmark 问题有用”的重要性,不必然等于开放世界中对用户长期最重要的信息。
5、Memory Architecture 不是 AttriMem 的创新
四模块架构、action-specific prompts 和外部 memory bank 主要沿用 MemBuilder。AttriMem 的核心贡献应准确定位为:
用 answer-conditioned token attribution 构造 memory-action token 的 process reward,并接入 GRPO。
七、实验
7.1 评测设置
- 训练:LongMemEval。
- 零样本迁移:LoCoMo、PerLTQA。
- 指标:准确率。
- 共享 answer model:Claude 4.5 Sonnet。
- 中间记忆质量 judge:GPT-4.1,比较时给出完整对话、问题、gold answer、两系统中间输出;双顺序比较后取平均。
- 关键受控 baseline:MemBuilder,匹配模型、memory architecture、SFT、GRPO 预算、检索回答接口和评测协议。
7.2 主结果
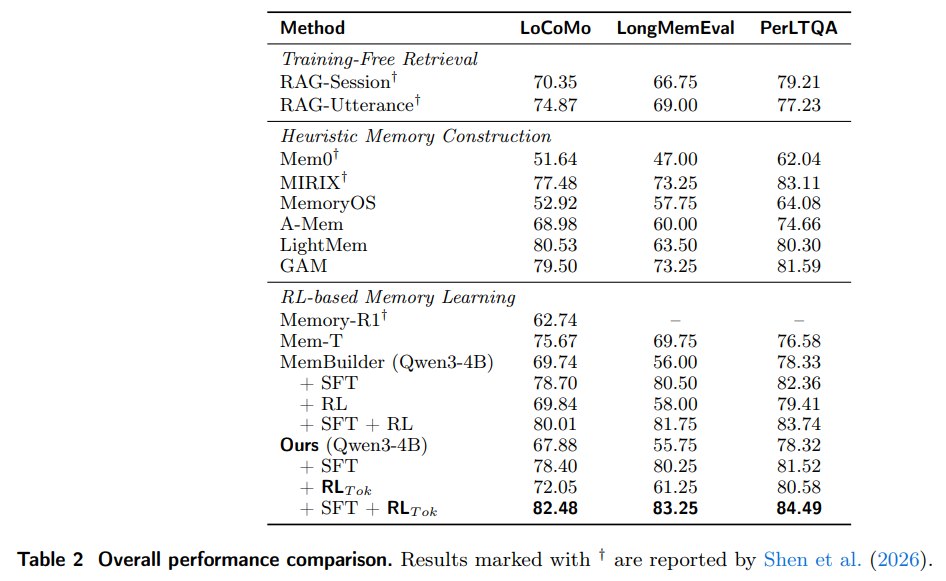
相对最接近 MemBuilder,在同等 SFT 加 RL 条件下,AttriMem 分别提升 2.47、1.50、0.75 点。
一个重要细节:SFT 后 MemBuilder 为 78.70 / 80.50 / 82.36,AttriMem 为 78.40 / 80.25 / 81.52,起点接近。AttriMem 并非靠更强 SFT 领先,其优势主要在 RL 后出现,这较好支持论文的中心论点。
7.3 Reward granularity 消融
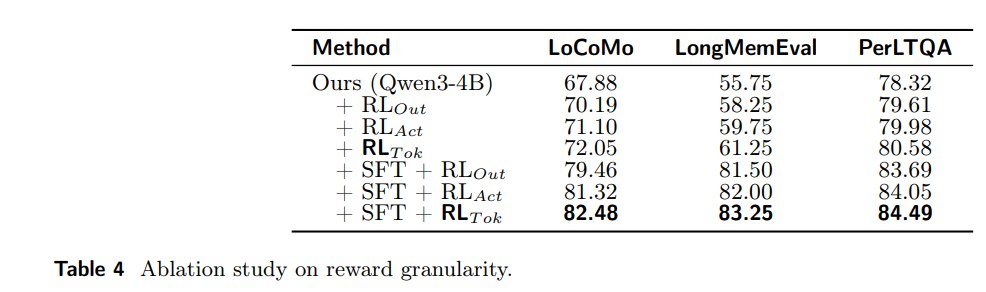
逻辑链很完整:
- outcome-only RL 有帮助,但有限;
- action-level attribution 更好,说明额外过程信息有价值;
- token-level 更进一步,说明更细的 credit assignment 不是装饰;
- SFT 加 RL 最好,说明细粒度奖励减少了对 SFT 的依赖,但没有让 SFT 变得不必要。
7.4 换 answer model 后,memory 是否仍有用
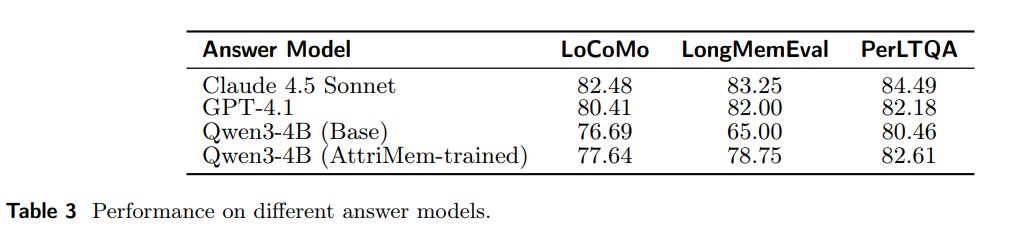
结果说明训练出的 memory 可以被不同 answer model 使用,至少存在一定转移性。不过绝对表现仍与 answer model 能力高度相关,尤其 LongMemEval 上 Qwen3-4B Base 远低于 Claude;不能说它已得到 answer-model-independent 的通用 memory。
7.5 中间 memory 质量、案例与训练曲线
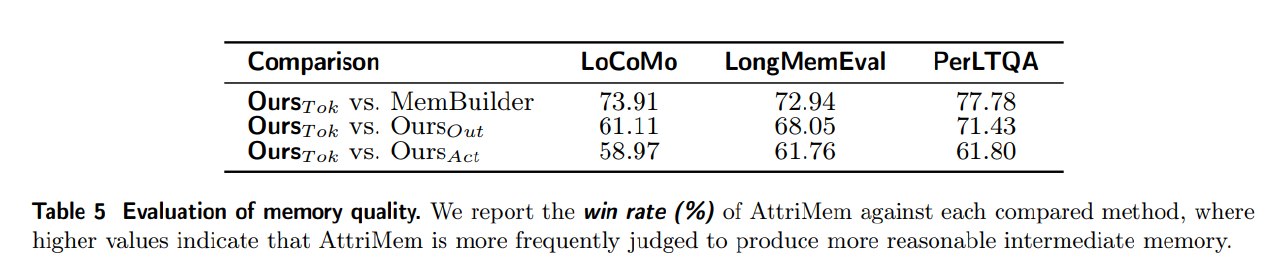
GPT judge 给出的 AttriMem token 版本相对 MemBuilder 胜率为:
- LoCoMo:73.91%;
- LongMemEval:72.94%;
- PerLTQA:77.78%。
相对 outcome-only 版本的胜率是 61.11%、68.05%、71.43%;相对 action-level 版本是 58.97%、61.76%、61.80%。
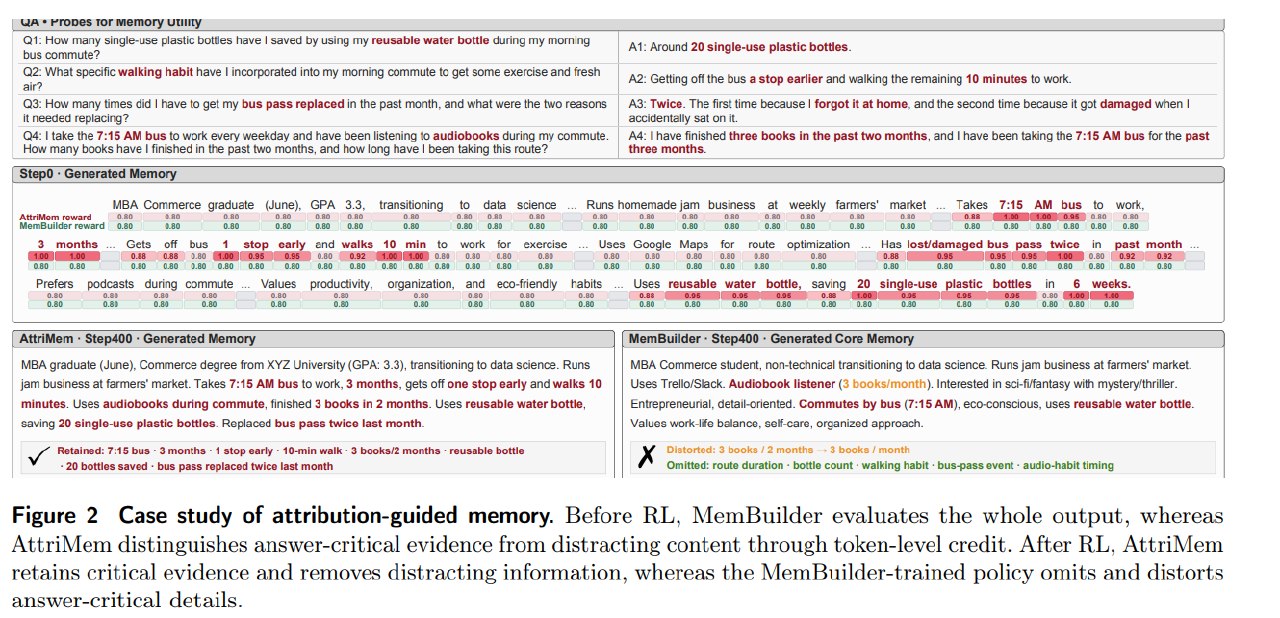
AttriMem 会保留“7:15”“三个月”“提前一站、十分钟”“三本书、两个月”“20 个瓶子”“公交卡两次”等答案敏感事实。MemBuilder 的整条 action 奖励更粗,示例中把“三本书 / 两个月”歪成“三本书 / 每月”,并漏掉路线时长、瓶子数量等。
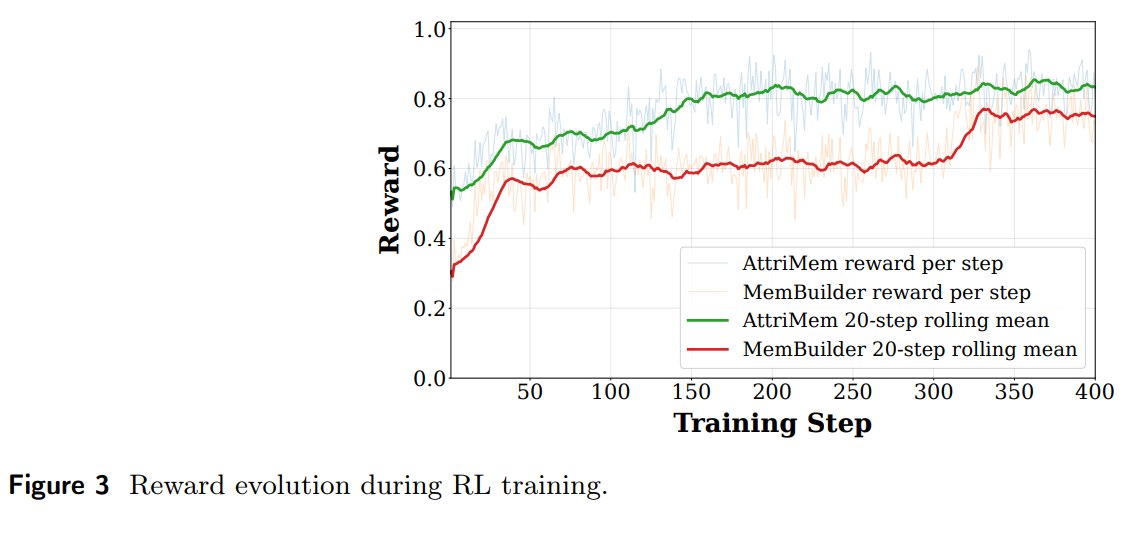
显示 token reward 的训练回报更平稳上升;MemBuilder 早期停滞、约 step 320 才突增。这是有用的优化诊断,但仍是特定环境和随机性的曲线,不应被扩张为所有设置下都必然稳定。
7.6 效率
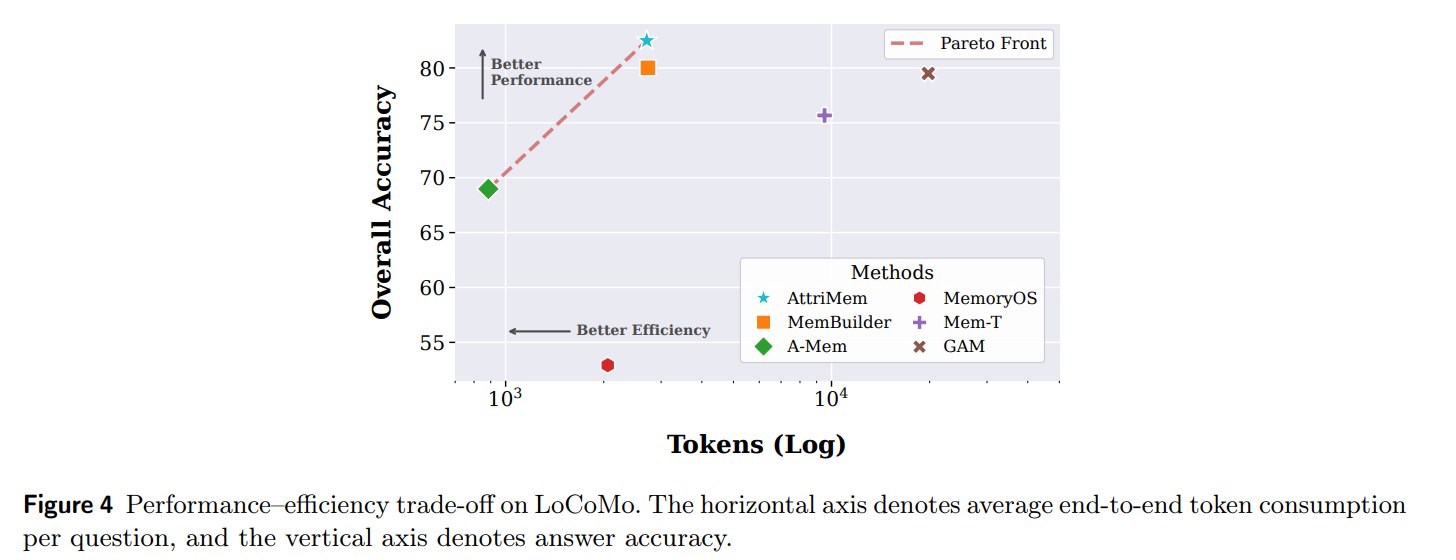
统计每问题平均端到端 token 数,包含摊销后的 memory construction 和 question answering。作者称 AttriMem 位于 LoCoMo 的 performance-efficiency Pareto front:准确率最高、推理 token 与 MemBuilder 接近,低于 Mem-T 和 GAM;A-Mem token 更少但准确率更低。
不过综合来看:
- 推理期 token 消耗:AttriMem 写出的 memory 较紧凑,确有竞争力。
- 训练期计算消耗:归因需要随机遮蔽、answer score、LASSO,训练还是太贵了。
7.7 实验小结
较有力支持:
- 在受控 MemBuilder 比较中,token-level reward 的 RL 增益高于 action-level 和 outcome-only reward。
- SFT 起点近似时,优势主要在 RL 后出现。
- 中间 memory judge 和案例与性能提升方向一致。
- learned memory 可在不同 answer model 上使用,存在一定迁移。
仍需保留的疑问:
- **attribution 对固定生成答案 $\hat y$ 打分;若 $\hat y$ 错误,局部奖励可能强化“支撑错误回答”的 token。**全局 outcome reward 会缓解,却不能从机制上消除。
- 32 个随机 masks 估计许多 token 贡献,依赖 LASSO 的稀疏和近似线性可加假设;多 token 组合、否定、时间关系等交互可能被错误分摊。
- 构建阶段看不到 $q$,这是合理设定;但训练仍由 benchmark 的问题分布事后提供 credit,学到的重要性可能偏向该分布,而非开放世界通用个人记忆。
八、结论
感觉这个工作的创新点就是 做了一个比较细粒度的 token-level 的 RL,然后借鉴 contextcite,比较巧妙地设计 reward,不过训练成本有点高,而且比较依赖外部 answer model。可以想想能不能改进,或者迁移到别的场景。
说些什么吧!